


Título original: (DeepSeek lança modelo de compreensão visual; olhos, como os do grande tubarão azul, que chegaram atrasados)
Autor original: 动察Beating
Em 21 de agosto de 2026, a DeepSeek lançou um novo modelo de compreensão visual deepseek-v4-flash-vision-exp, e a API multimodal foi oficialmente disponibilizada. Pela primeira vez, os desenvolvedores podem enviar imagens diretamente para a interface oficial da DeepSeek.
O modelo mantém o contexto de 1 milhão de tokens do V4 Flash e a saída máxima de 384 mil tokens; suporta JSON Output, Tool Calls e Responses API, além de ser compatível com a API da Anthropic.
Os preços seguem completamente o V4 Flash. Por cada 1 milhão de tokens de entrada, quando não há acerto de cache, custará 3 iuanes no período de pico e 1,5 iuanes no período fora do pico; quando há acerto de cache, os valores são 0,1 iuanes e 0,05 iuanes, respectivamente. Para a saída, no período de pico são 9 iuanes e no período fora do pico 4,5 iuanes. Em Pequim, das 9h às 12h e das 14h às 18h de cada dia é considerado período de pico; nas demais 17 horas, o preço é pela metade.
As imagens também são cobradas por tokens. Antes de entrar no modelo, cada imagem é redimensionada automaticamente de acordo com o tamanho: as menores que aproximadamente 384×384 pixels são ampliadas, e imagens grandes são comprimidas para um total de pixels em torno de 800×800 pixels. Uma imagem única ocupa no máximo 384 tokens. Uma imagem de 2000×2000 e uma de 5000×5000 podem acabar consumindo exatamente a mesma quantidade de tokens.
De acordo com o limite de 384 tokens, durante o pico e com custo de entrada sem acerto de cache, uma imagem custa aproximadamente 0,001152 yuan. Ao processar mil imagens assim, só a entrada das imagens também fica em cerca de 1,152 yuan; texto e saída do modelo são cobrados à parte.
Também foi lançado o Files API. Desenvolvedores podem enviar imagens com antecedência e depois colocar o file_id na requisição. Para a mesma imagem, basta enviar uma vez; depois, pode ser referenciada repetidamente em diferentes solicitações. Em uma única requisição, no máximo ainda dá para incluir 600 imagens. Usando links externos ou Base64, o limite por imagem é 32 MiB; ao referenciar via Files API, pode chegar a 64 MiB.
Esta API em si não tem custo. Um arquivo máximo de 64 MiB, e por usuário no máximo 25 GiB e 10.000 arquivos. Os arquivos podem ser definidos para expirar de 1 hora a 30 dias; se não houver período de validade, podem ser mantidos indefinidamente. No momento, a própria empresa também não fornece uma interface para baixar o conteúdo dos arquivos. Desenvolvedores podem fazer upload, consultar e excluir, e o modelo consegue ler. É mais como um repositório gratuito de imagens preparado especificamente para inferência do que um disco em nuvem comum.
Mas o estranho não é que o DeepSeek só vai ver imagens até hoje.
Duas linhas de tempo
Se você só olhar para a pesquisa, a visão do DeepSeek não está atrasada.
Se você olhar apenas para produto e API, então sim, ela está atrasada há muito tempo.
Em 11 de março de 2024, o DeepSeek-VL foi open source.
Ele tem duas versões, 1,3B e 7B, consegue ver imagens naturais, páginas da web, fórmulas, gráficos e documentos. Em outubro, aparece o Janus e coloca a compreensão e a geração de imagens na mesma estrutura autoregressiva. Em 13 de novembro, o JanusFlow acompanha. Em dezembro, o DeepSeek-VL2 é lançado, trocando para uma arquitetura de especialistas híbridos, com a quantidade total de parâmetros dividida em três faixas: 3B, 16B e 27B.
À 1h da madrugada de 28 de janeiro de 2025, véspera do Ano Novo Lunar, Janus-Pro foi open source. O repositório oficial registrou como 27 de janeiro, de acordo com UTC.
A versão de 7B, na avaliação GenEval para instruções de geração de imagens, obteve 0,80, superando os 0,67 listados na paper para DALL-E 3. Ele tem pesos open source, pode ser implantado localmente, e também possui um demo público.
O DeepSeek não o conectou à sua própria API hospedada.
Apenas na semana anterior, o R1 já tinha colocado o DeepSeek sob os holofotes. Janus ficou no GitHub e no Hugging Face. Para a grande maioria dos usuários comuns, ele logo desapareceu do campo de visão.
Em 20 de outubro de 2025, o DeepSeek-OCR foi open source, comprimindo documentos longos com tokens visuais. Em 27 de janeiro de 2026, o OCR 2 foi lançado.
Começando pelo DeepSeek-VL, ao longo de dois anos dá para encontrar pelo menos sete registros públicos do DeepSeek-VL, Janus, JanusFlow, VL2, Janus-Pro, OCR e OCR 2.
A pesquisa em visão vem acontecendo há muito tempo e também vinha sendo divulgada para fora.
Mas um desenvolvedor comum simplesmente não tinha aquela entrada.
Por outro lado, até março de 2024, as interfaces de desenvolvedor de vários concorrentes principais já conseguiam receber imagens. A OpenAI liberou, em novembro de 2023, o GPT-4 Turbo with Vision; as imagens podiam entrar diretamente na Chat Completions API. Um mês depois, o Google lançou a Gemini Pro Vision API. Em março de 2024, o Claude 3 da linha toda adicionou capacidades visuais.
Em 25 de abril de 2025, na conferência Baidu Create, Li Yanhong disse: «DeepSeek também não é onisciente». Entre algumas questões listadas em seguida, havia também uma delas relacionada à modalidade única.
A avaliação dele é que o multimodal vai virar padrão dos modelos básicos, e o mercado de modelos apenas de texto vai diminuindo cada vez mais.
Naquela época, o DeepSeek já tinha feito um ano de pesquisa em visão.
de madrugada
Em 7 e 8 de abril de 2026, alguns usuários abriram o DeepSeek e, de repente, apareceram três entradas a mais na interface.
«rápido», «especialista», «visão».
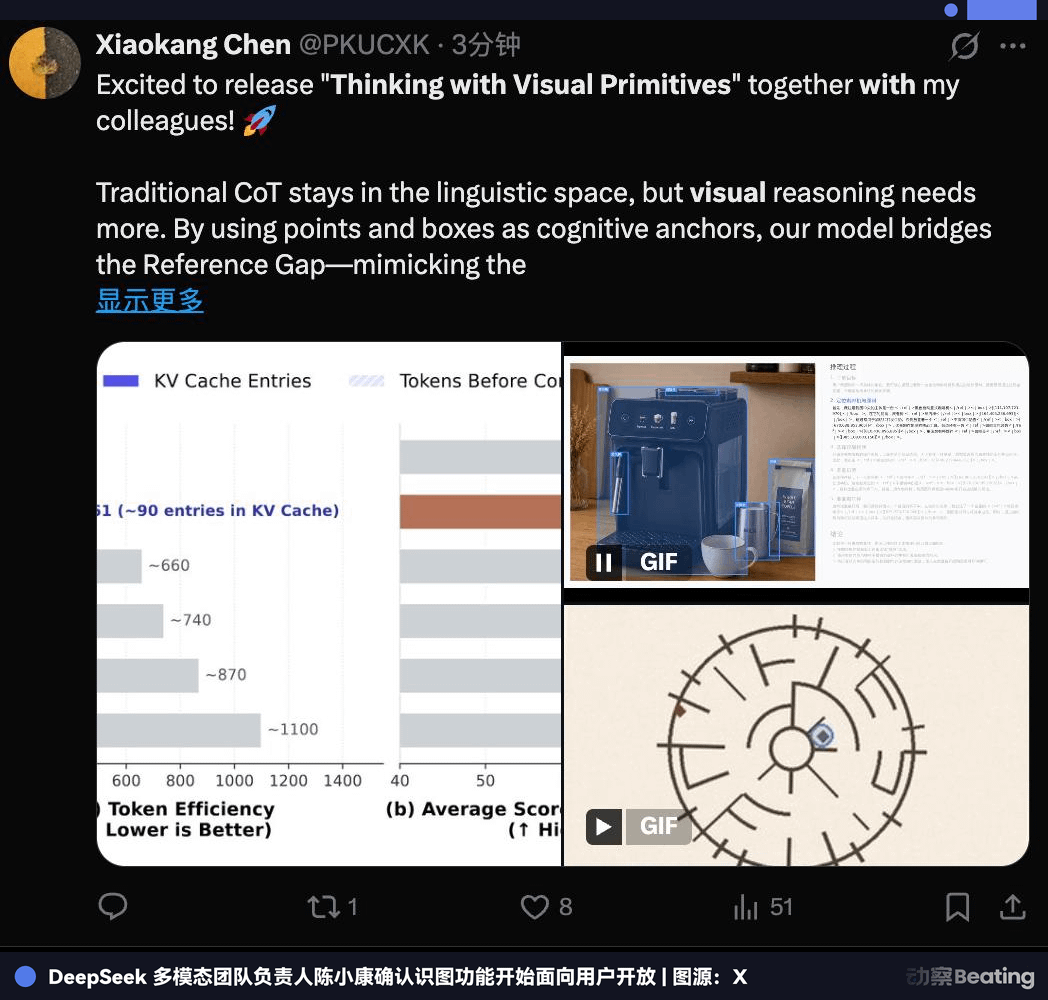
Em 29 de abril, o responsável pela equipe de multimodal do DeepSeek, Chen Xiaokang, confirmou que a função de entender imagens começou a ser disponibilizada em versão gradual para alguns usuários. Depois disso, um pesquisador sênior do DeepSeek escreveu: «Agora o peixinho-baleia consegue ver». O South China Morning Post colocou essa frase diretamente no título.
Os olhos do DeepSeek finalmente apareceram de verdade a partir da interface do produto.
No dia seguinte, o DeepSeek colocou (Thinking with Visual Primitives) no GitHub. Algumas horas depois, o repositório e a paper foram retirados. Até 1º de maio, o endereço original já retornava 404. O DeepSeek não explicou; na internet, só restaram espelhos da paper e relatos da mídia.
A pesquisa em paper trata de um problema bem específico.
Depois que o modelo vê uma imagem muito cheia, muitas vezes ele sabe do que está falando, mas não consegue dizer claramente exatamente qual pessoa ou qual linha ele está falando. A equipe inseriu diretamente coordenadas de pontos e caixas delimitadoras no processo de inferência: o modelo indica a posição enquanto continua pensando adiante.
Uma imagem de 756×756 passa primeiro por um codificador visual, virando 2916 tokens de blocos de imagem; depois, por uma compressão espacial 3×3, é transformada em 324 tokens. A atenção esparsa do V4 Flash continua comprimindo o cache e, no fim, ficam apenas 81 entradas de KV visuais.
A equipe também gerou mais de 40 milhões de amostras de treinamento para esse método, incluindo dados especificamente treinados para navegação em labirintos e rastreamento de caminhos.
A força que esta paper gastou para resolver o que, na verdade, é «apontar onde».
O modelo precisa primeiro enxergar, depois precisa saber onde exatamente está olhando. Só assim ele consegue continuar raciocinando adiante.
Desta vez, o DeepSeek não explicou se o Vision Exp incorporou completa e diretamente essa solução de Visual Primitives. Mais importante ainda, esta pesquisa, pela primeira vez, colocou o entendimento do DeepSeek sobre «raciocínio visual» para fora.
Em 18 de junho, o modo de ver imagens na web e no app foi lançado oficialmente. No dia seguinte, uma mídia enviou fotos do Liang Wenfeng para testes; o DeepSeek o reconheceu duas vezes seguidas como Zhang Yiming. Em outra conversa, ele voltou a reconhecer Zhang Yiming como Chen Tianshi, fundador da Cambricon.
Ele já consegue ler capturas de tela em inglês e também transformar páginas da web em código.
Chega diante de um rosto, mas nem o próprio chefe ele reconhece.
Em 19 de agosto, o DeepSeek Harness deixou uma nota técnica com data bem definida. O adaptador oficial já consegue serializar uma sequência de imagens em image_url. A documentação também deixa claro que, por enquanto, o diretório padrão do modelo não exibirá deepseek-v4-flash-vision-exp; é preciso esperar até que os endpoints de API correspondentes fiquem disponíveis.
Em 20 de agosto, também houve testes de desenvolvedores: enviar uma imagem para o nome desse modelo que ainda não estava aberto só recebia erro 400.
Em 21 de agosto, esta limitação foi removida. O Harness adicionou deepseek-v4-flash-vision-exp ao diretório padrão do modelo; o commit de merge correspondente já trazia diretamente «publish the vision model». Em seguida, o API oficial do DeepSeek e a conta oficial no WeChat anunciaram simultaneamente o lançamento do Vision Exp.
As duas linhas finalmente se encontraram.
Agent
Em uma transcrição de áudio de um encontro com investidores em maio deste ano, Liang Wenfeng organizou a rota AGI na visão dele em alguns degraus: modelos de linguagem, cadeia de pensamento, Agent, aprendizagem contínua, autoiteração e, por fim, inteligência corporificada.
O multimodal foi colocado no lugar de componente por ele, parecido com busca.
Ao falar sobre geração de vídeo, há uma frase na transcrição:
No aspecto comercial, é um bom negócio. Mas isso não tem nada a ver com inteligência.
A avaliação dele é que a relação entre geração de vídeo e modelos do mundo com o limite de inteligência nesta fase não é tão grande; o que é mais urgente agora é o treinamento de IA e, após o treinamento, a aprendizagem contínua.
O que há de diferente no multimodal é que, embora ele também esteja no lugar de «componente», é um componente que o DeepSeek disse com clareza que faria. Naquela época, Liang Wenfeng também mencionou que o V4 e as versões seguintes suportariam multimodal nativo.
A visão sempre teve um lugar na rota do DeepSeek, só que não ficou tão à frente.
Quando a rota chega ao terceiro passo, ao Agent, as coisas começam a ser um pouco diferentes.
O DeepSeek não divulgou publicamente que, desta vez, a API de visão foi lançada «para o Agent». Mas colocando juntos o julgamento do Liang Wenfeng sobre a rota e o anúncio de hoje, já fica bem difícil separar completamente as duas linhas.
O Agent precisa ler a tela, olhar gráficos e processar screenshots que as ferramentas jogam de volta. Ele não pode viver para sempre apenas em texto puro. Essas capacidades visuais já feitas há dois anos finalmente saíram das papers, dos repositórios e das páginas de testes e chegaram à API.
Os três exemplos que o DeepSeek mostrou para o Vision Exp hoje também não são o tradicional «ver imagem e falar». Um Agent prepara um PPT de viagem de carro pela região do Tibete para clientes de alto padrão; um redesenha o site do DeepSeek Harness; e outro cria um demo de front-end com efeitos dinâmicos de acordo com requisitos visuais.
Elas exigem que o modelo processe a informação visual repetidamente em tarefas de longo fluxo.
O design da API também está caminhando nessa direção. A Responses API também aceita input_image; depois que o Agent do navegador obtém um screenshot da página, ele pode enviá-lo de volta para a próxima rodada de inferência. O Agent de código pode verificar o resultado do render; gráficos, scan e interfaces de software também podem se tornar contexto diretamente.
O Files API resolve outra questão: a mesma imagem não precisa ser enviada novamente em cada rodada de requisição. Um arquivo pode ficar lá por muito tempo, e o Agent só precisa reenviar o file_id repetidas vezes. Em uma única requisição, também dá para colocar até 600 imagens. Ao usar links externos ou Base64, o limite para uma imagem é 32 MiB; após referenciar pelo Files API, pode chegar a 64 MiB.
Isso já não parece adicionar um botão «enviar imagem» para a caixa de conversa.
Parece mais que ele está completando a infraestrutura necessária para os Agents usarem visão.
Nas comparações de quatro agentes multimodais divulgadas pelo DeepSeek, também há bem poucas avaliações do tipo tradicional «ver imagem e falar».
ApexBench foca em tarefas de longo fluxo como bancos de investimento, consultoria e áreas jurídicas. Agents' Last Exam vem de trabalho real em 55 áreas profissionais. Chartography avalia especificamente curvas Kaplan-Meier, gráficos de K, curvas de nível, diagramas de Sankey e diagramas de Porter. ZeroBench, por sua vez, usa 100 problemas difíceis desenhados manualmente para testar raciocínio visual em múltiplos passos.
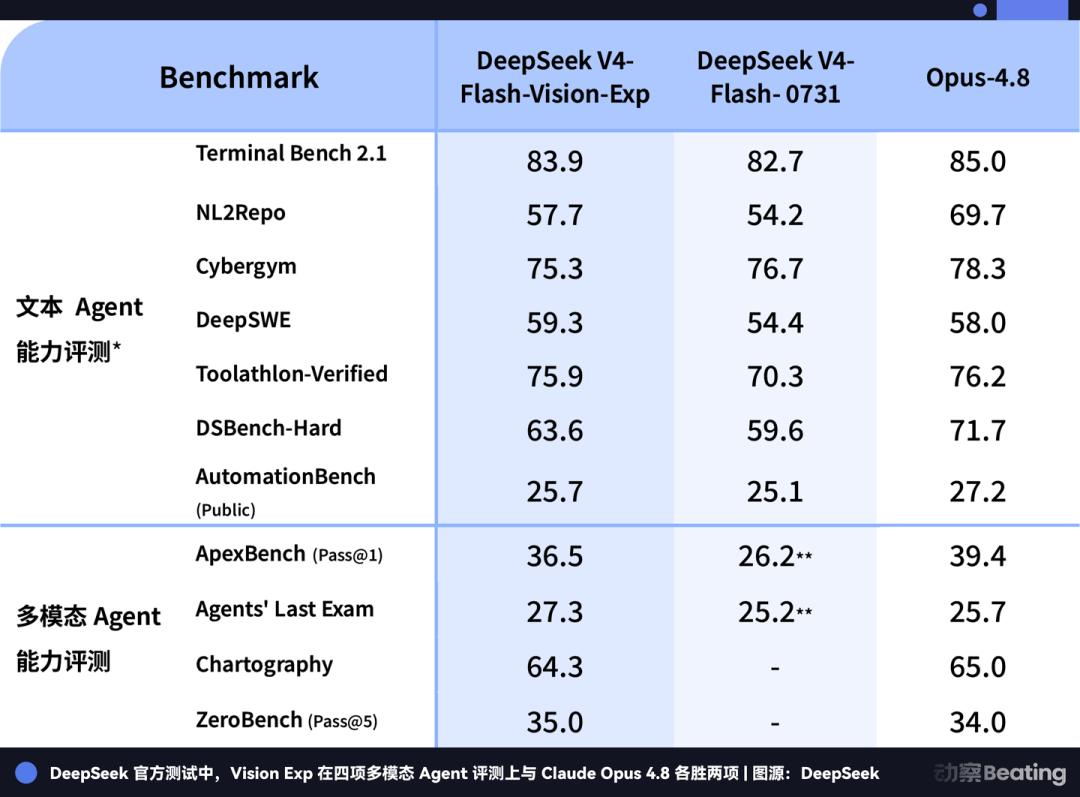
O Vision Exp teve duas vitórias e duas derrotas contra o Claude Opus 4.8.
Agents' Last Exam foi 27,3 contra 25,7; ZeroBench, 35,0 contra 34,0. ApexBench, 36,5 contra 39,4; Chartography, 64,3 contra 65,0. As quatro diferenças não passaram de 3 pontos.
O mais interessante é que, ao adicionar visão, as capacidades do Agent de texto original não caíram de forma evidente.
Comparando item a item com o V4 Flash apenas de texto lançado em 31 de julho, o site também forneceu cinco avaliações para Agents de texto, e todas tiveram melhora do antes para o depois.
O Terminal Bench 2.1 subiu de 82,7 para 83,9; NL2Repo de 54,2 para 57,7; DeepSWE de 54,4 para 59,3; DSBench-Hard de 59,6 para 63,6; AutomationBench de 25,1 para 25,7. O 59,3 do DeepSWE também ultrapassa os 58,0 do Opus 4.8 na imagem.
Mas esses números vêm dos próprios testes do DeepSeek. A documentação oficial informa que, nos textos de tarefas publicamente disponíveis do Code Agent, os modelos da série DeepSeek usam o modo minimalista do DeepSeek Harness, com o nível de inferência definido como max. Eles são mais adequados para observar as mudanças do Vision Exp em comparação com o próprio V4 Flash, e não para ser usado diretamente como ranking independente de terceiro.
O exp no nome do modelo também ainda não foi removido.
O DeepSeek marcou claramente como modelo experimental, e a versão ainda pode continuar mudando. Hoje, a interface só faz compreensão de imagens, e a saída ainda é texto. A geração de imagens e de vídeo não foi aberta; o Files API também só aceita JPEG, PNG, GIF e WebP; PDFs não podem ser enviados diretamente.
Em 2024, quando desenvolvedores queriam enviar uma imagem ao DeepSeek, a API oficial ainda não conseguia receber.
Em 21 de agosto de 2026, esta imagem finalmente entrou.
Os olhos do DeepSeek realmente demoraram para abrir.
Quando ela realmente abriu os olhos, o caminho à frente já não permitiria que ela continuasse andando de olhos fechados.
Link original