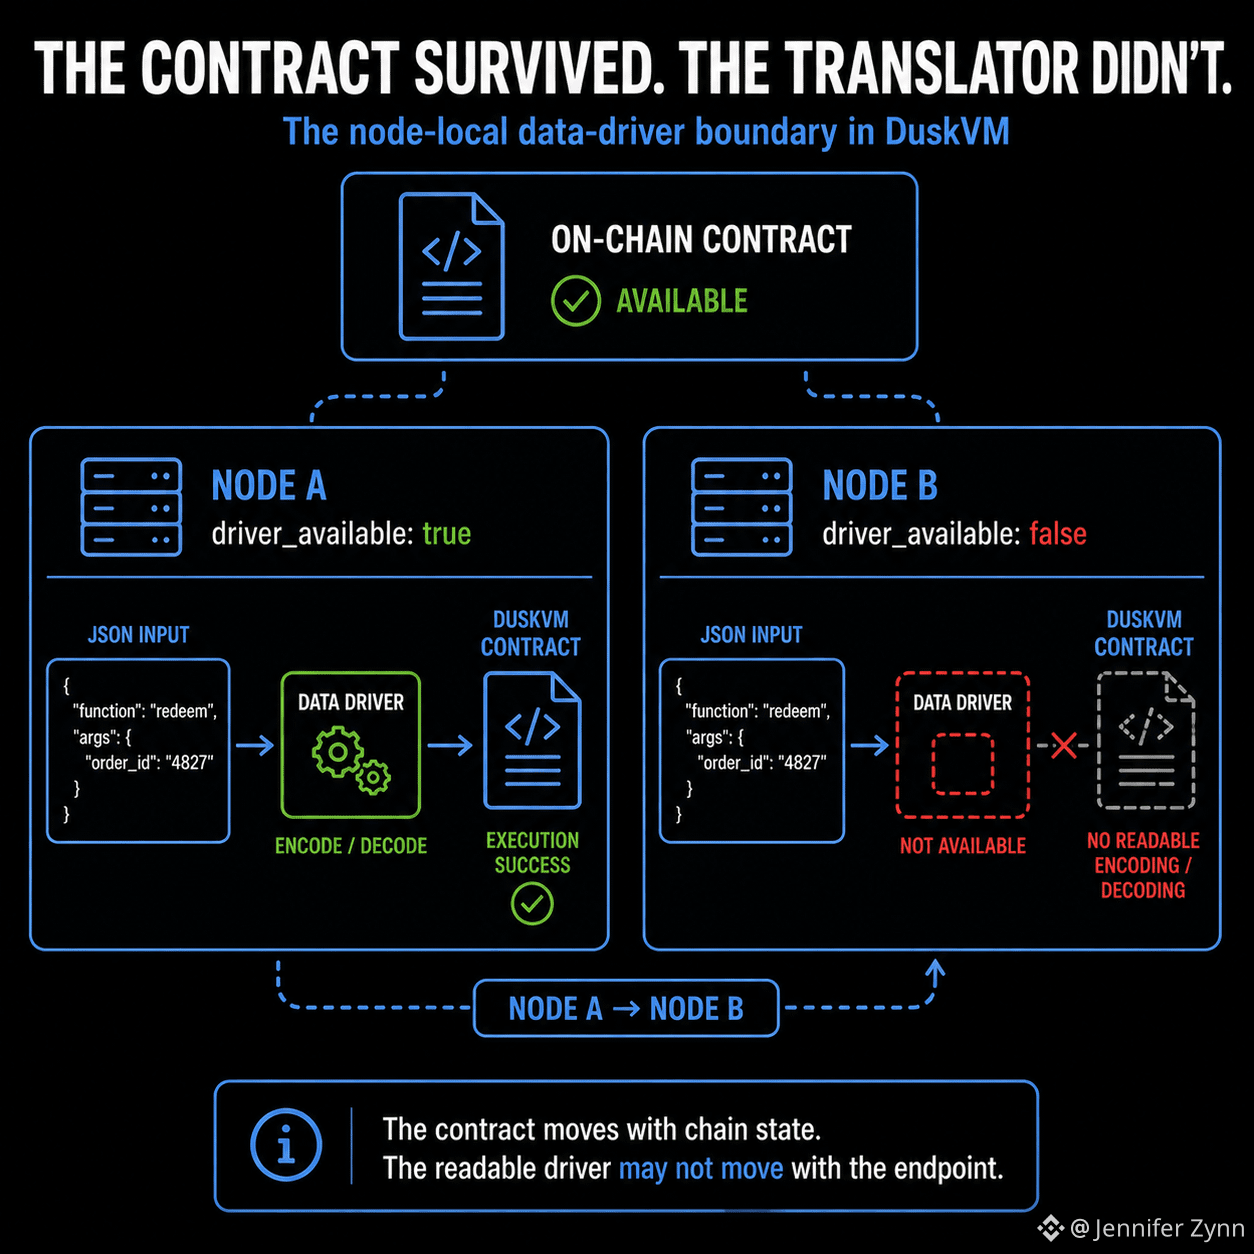

Um contrato do DuskVM pode sobreviver a uma alternância de failover de nós, enquanto minha aplicação de repente esquece como falar com ele.
O motivo está fora da cadeia. A Forge cria dois artefatos WASM a partir do mesmo código-fonte: o contrato que roda no DuskVM e um driver de dados que lida com JSON legível para codificação e decodificação rkyv. Esse driver não é implantado como parte do contrato on-chain.
Se eu quiser que rotas de contratos JSON do Rusk façam essa tradução, o proprietário do contrato registra o driver com aquele nó.
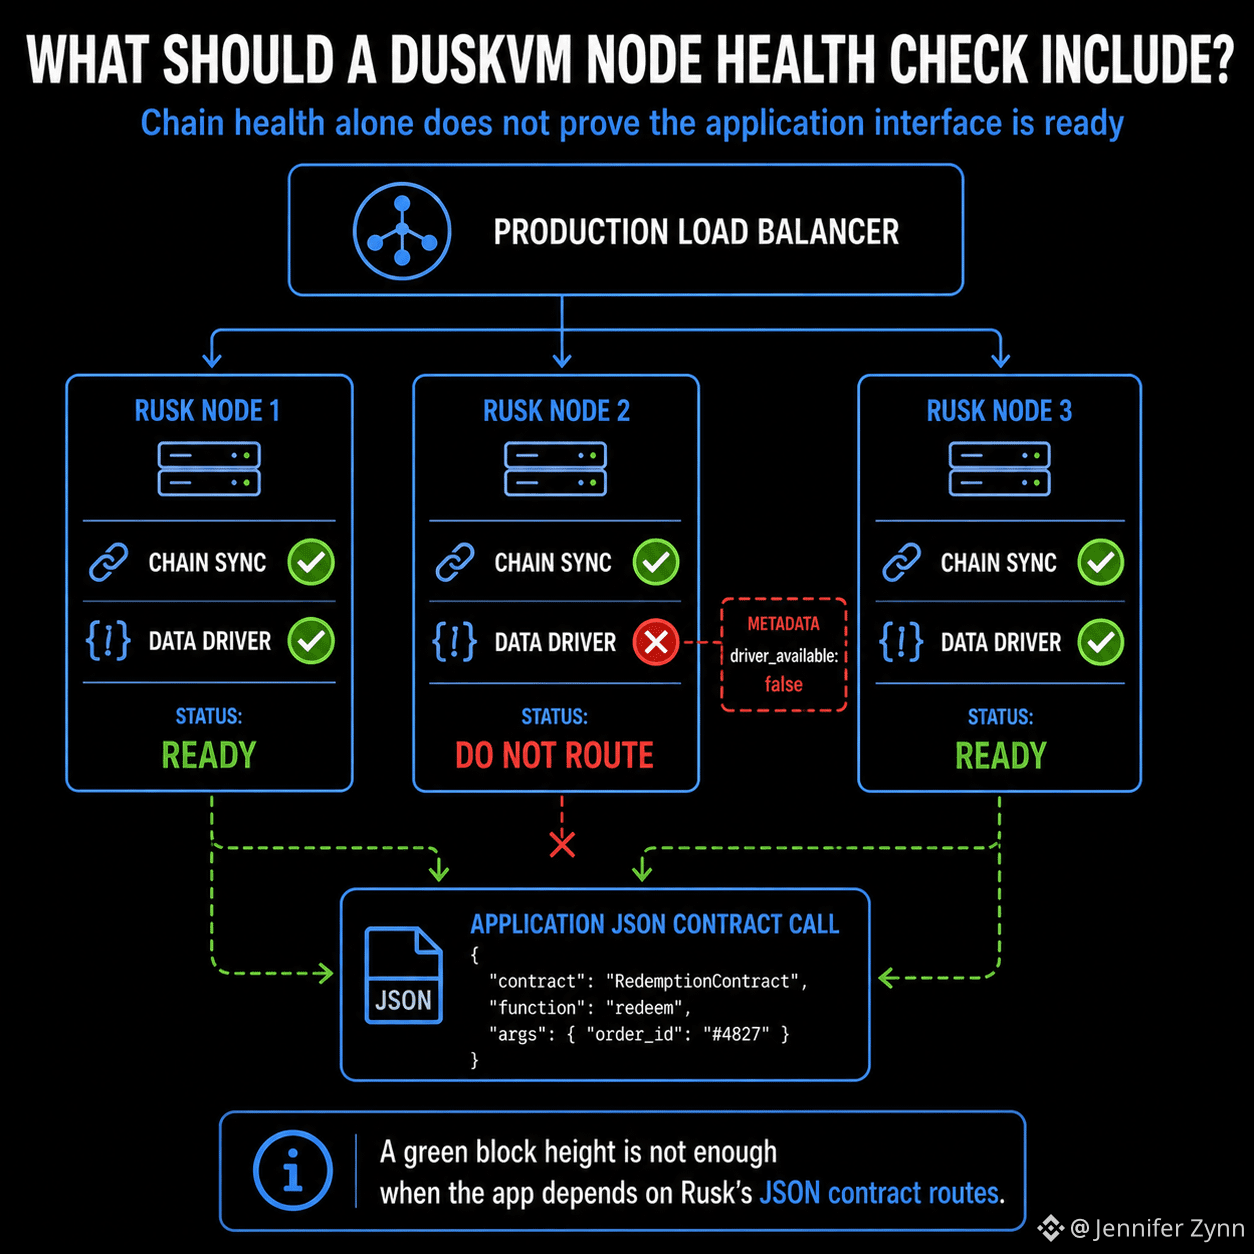
Então eu consigo implantar uma vez, testar contra o Node A, ver chamadas legíveis e limpas, e então fazer failover para o Node B e cair em um estado estranho. O contrato está lá. A cadeia está saudável. Mas driver_available pode ser false, então a aplicação perde a superfície de decodificação em que foi construída.
Esse é o perigo na produção para mim. A consensus não falhou. O contrato não falhou. Meu failover mudou uma dependência off-chain que eu havia tratado como se viajasse junto com o contrato.
Eu tornaria a disponibilidade do driver parte da prontidão do nó e verificaria isso em cada endpoint do Rusk antes que o tráfego chegue até ele.
No DuskVM, o contrato pode sobreviver ao failover enquanto o seu tradutor não.
#dusk $DUSK @Dusk