O momento mais constrangedor de uma cadeia de liquidação de valores: nem sempre é quando um hacker invade; é quando ninguém parece estar fazendo algo claramente malicioso, mas o livro-razão demora tanto para virar a próxima página. Nós ficam offline, ocorre uma partição de rede, o comitê não consegue reunir votos suficientes; o dinheiro não se perde, mas todos só conseguem esperar. Em uma blockchain comum, isso se chama congestionamento. Em um mercado financeiro, isso pode virar diretamente um incidente de consenso e liquidação.
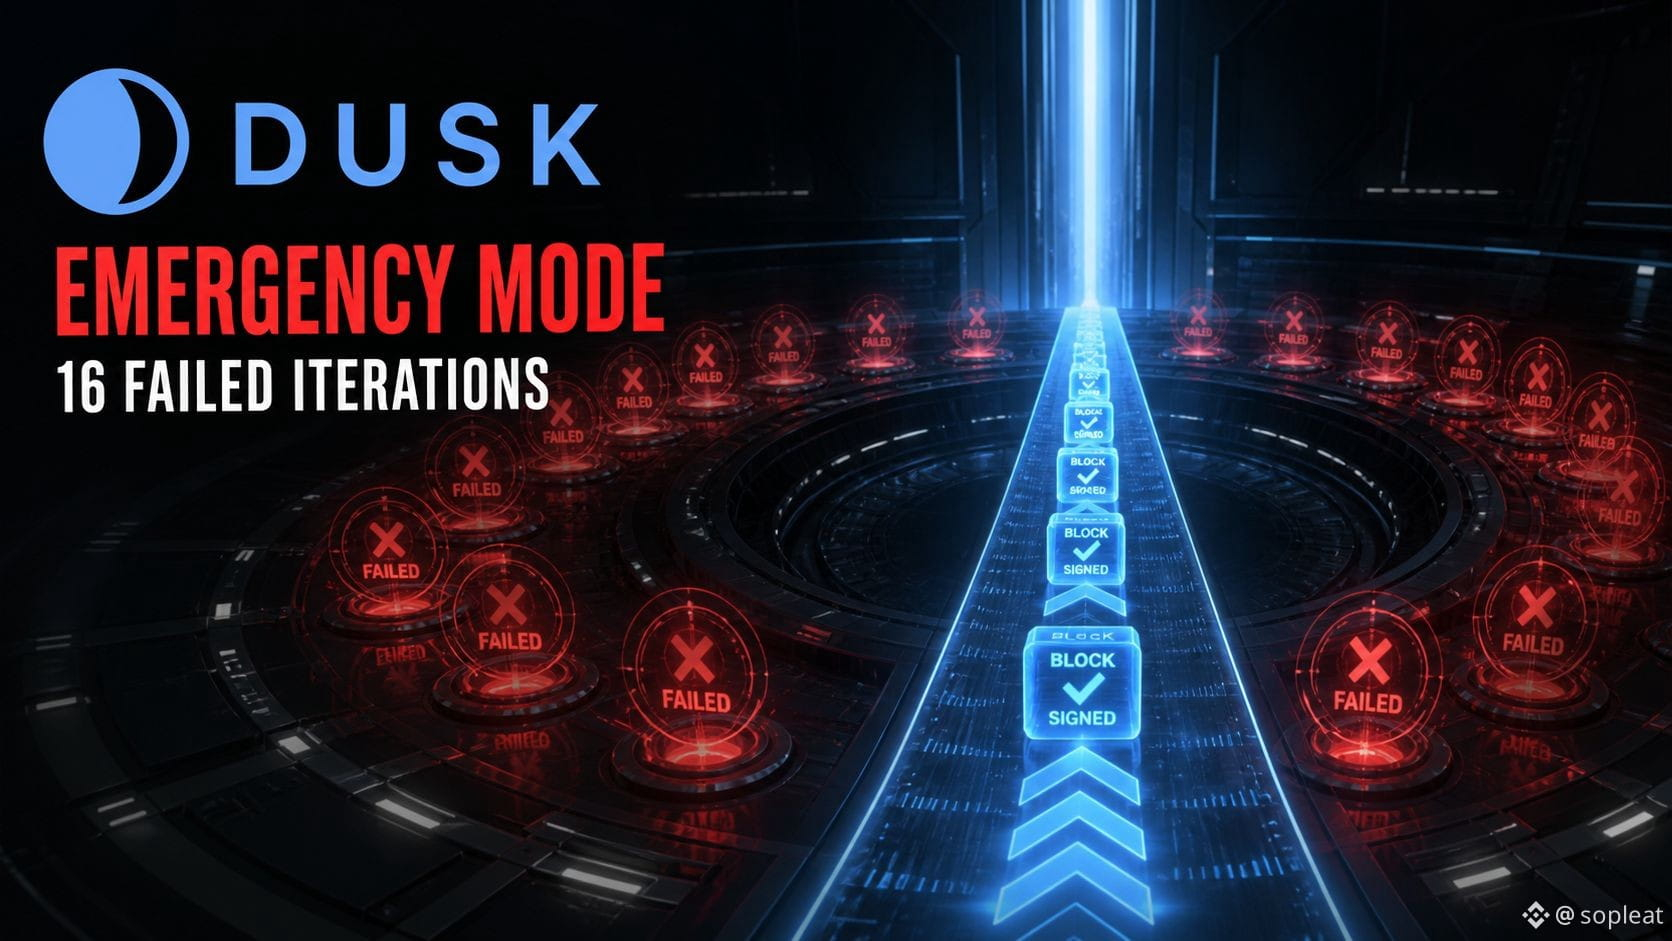
Releio o whitepaper do Emergency Mode do @Dusk e percebo que ele não finge que esse tipo de situação não vai acontecer. O Succinct Attestation executa no máximo 50 iterações por rodada; quando 16 iterações consecutivas falham, o protocolo entra em modo de emergência. As etapas que estouram o tempo-limite no fluxo normal são desativadas; NoCandidate e NoQuorum deixam de ser considerados como resultado de avanço. As iterações já iniciadas continuam aguardando o bloco candidato e a validação/aprovação em duas fases para, de fato, atingirem o quórum.
A intenção desse desenho é bem direta: no dia a dia, o consenso pode trocar para um novo grupo quando houver timeout; em um caso extremo, porém, não dá para ficar “pulando” o problema só porque “ninguém chegou em dia”. O sistema prefere deixar várias iterações abertas em paralelo, em vez de ficar preso, mas espera até que saia um bloco que o comitê possa confirmar — aumentando a probabilidade de o livro-razão continuar avançando.
Mas o custo também está escrito no whitepaper. Iterações em paralelo podem fazer com que, na mesma rodada, surjam vários blocos candidatos que já tenham alcançado consenso; o risco de bifurcação, na verdade, aumenta. Assim, o protocolo só pode escolher o candidato com o menor número de iteração para convergir. Se no fim ainda não for possível recuperar, a maioria dos detentores de stake pode, em conjunto, solicitar um bloco de emergência vazio que não inclua transações, e nós Dusk geram uma nova semente, permitindo que a rede atravesse essa rodada.
Eu não vou interpretar isso como “nunca desligar”. É mais como um manual de recuperação de desastres: reconhece que o consenso pode travar e define quem consegue impulsionar a recuperação e o que pode ser sacrificado durante a recuperação. No futuro, ao observar a capacidade de liquidação financeira do $DUSK , vou me importar mais com quantas vezes o modo de emergência é acionado na prática, por quanto tempo dura, quantas bifurcações ocorrem e quantas solicitações de bloco vazio são feitas — e não apenas com quantos segundos leva para produzir blocos no estado normal.
Infraestrutura de nível institucional de verdade não é aquela que nunca apresenta falhas; é aquela em que, quando a falha acontece, as regras de tratamento já estão escritas com antecedência, e o custo também é visível para todos.
#dusk
Releio o whitepaper do Emergency Mode do @Dusk e percebo que ele não finge que esse tipo de situação não vai acontecer. O Succinct Attestation executa no máximo 50 iterações por rodada; quando 16 iterações consecutivas falham, o protocolo entra em modo de emergência. As etapas que estouram o tempo-limite no fluxo normal são desativadas; NoCandidate e NoQuorum deixam de ser considerados como resultado de avanço. As iterações já iniciadas continuam aguardando o bloco candidato e a validação/aprovação em duas fases para, de fato, atingirem o quórum.
A intenção desse desenho é bem direta: no dia a dia, o consenso pode trocar para um novo grupo quando houver timeout; em um caso extremo, porém, não dá para ficar “pulando” o problema só porque “ninguém chegou em dia”. O sistema prefere deixar várias iterações abertas em paralelo, em vez de ficar preso, mas espera até que saia um bloco que o comitê possa confirmar — aumentando a probabilidade de o livro-razão continuar avançando.
Mas o custo também está escrito no whitepaper. Iterações em paralelo podem fazer com que, na mesma rodada, surjam vários blocos candidatos que já tenham alcançado consenso; o risco de bifurcação, na verdade, aumenta. Assim, o protocolo só pode escolher o candidato com o menor número de iteração para convergir. Se no fim ainda não for possível recuperar, a maioria dos detentores de stake pode, em conjunto, solicitar um bloco de emergência vazio que não inclua transações, e nós Dusk geram uma nova semente, permitindo que a rede atravesse essa rodada.
Eu não vou interpretar isso como “nunca desligar”. É mais como um manual de recuperação de desastres: reconhece que o consenso pode travar e define quem consegue impulsionar a recuperação e o que pode ser sacrificado durante a recuperação. No futuro, ao observar a capacidade de liquidação financeira do $DUSK , vou me importar mais com quantas vezes o modo de emergência é acionado na prática, por quanto tempo dura, quantas bifurcações ocorrem e quantas solicitações de bloco vazio são feitas — e não apenas com quantos segundos leva para produzir blocos no estado normal.
Infraestrutura de nível institucional de verdade não é aquela que nunca apresenta falhas; é aquela em que, quando a falha acontece, as regras de tratamento já estão escritas com antecedência, e o custo também é visível para todos.
#dusk