Já executei infraestrutura o suficiente para saber que o custo real não é a indisponibilidade em si, e sim o que você faz depois.
Quando um nó Dusk cai ou fica fora de sincronia, você tem dois caminhos.
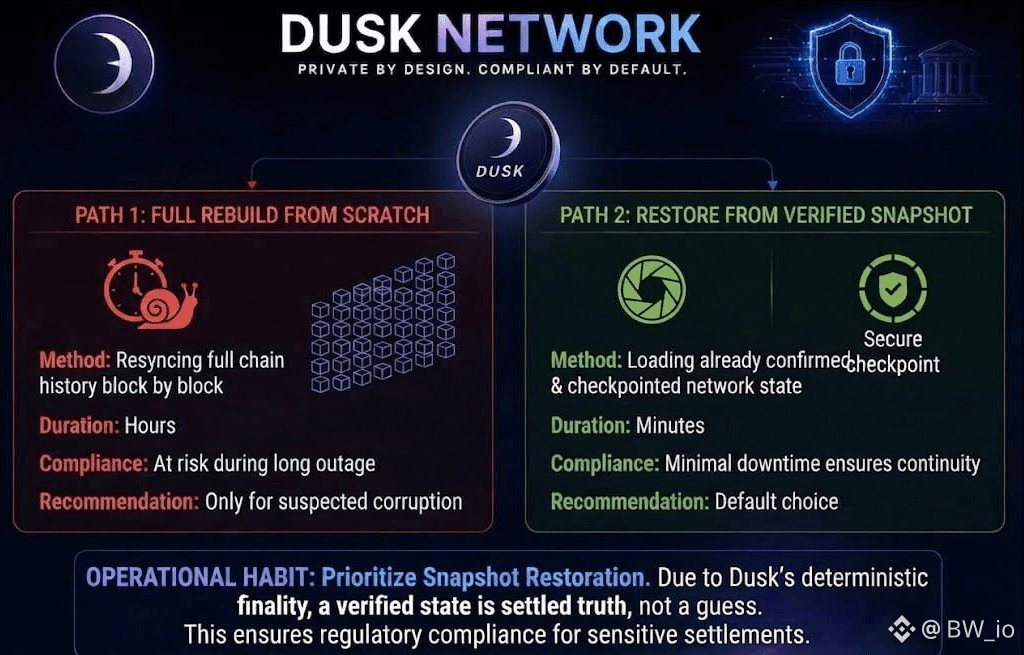
Você pode reconstruir do zero, re-sincronizando todo o histórico da cadeia bloco por bloco — algo seguro, mas lento e que consome horas que você não tem durante um incidente. Ou pode restaurar a partir de um snapshot de estado verificado, que já foi feito checkpoint e confirmado contra o consenso da rede, e voltar a ficar online em uma fração do tempo.
Eu sempre prefiro o segundo caminho, porque a finalidade determinística do Dusk significa que um estado verificado não é um palpite: é uma verdade consolidada, daquelas que o protocolo já concordou.
Isso importa mais aqui do que na maioria das outras cadeias, já que esses nós frequentemente dão suporte a liquidações regulamentadas — não apenas transações de gas. A indisponibilidade em uma rede que movimenta valores reais não é apenas inconveniente; é uma questão de conformidade.
Então, o hábito operacional que eu recomendaria é simples: não trate a restauração de snapshot como um atalho — trate como o padrão — e deixe as reconstruções completas apenas para quando você realmente suspeitar de corrupção.
É uma pequena escolha operacional, mas é a diferença entre minutos de indisponibilidade e horas.
@Dusk #dusk $DUSK $GPS $STAR
Quando um nó Dusk cai ou fica fora de sincronia, você tem dois caminhos.
Você pode reconstruir do zero, re-sincronizando todo o histórico da cadeia bloco por bloco — algo seguro, mas lento e que consome horas que você não tem durante um incidente. Ou pode restaurar a partir de um snapshot de estado verificado, que já foi feito checkpoint e confirmado contra o consenso da rede, e voltar a ficar online em uma fração do tempo.
Eu sempre prefiro o segundo caminho, porque a finalidade determinística do Dusk significa que um estado verificado não é um palpite: é uma verdade consolidada, daquelas que o protocolo já concordou.
Isso importa mais aqui do que na maioria das outras cadeias, já que esses nós frequentemente dão suporte a liquidações regulamentadas — não apenas transações de gas. A indisponibilidade em uma rede que movimenta valores reais não é apenas inconveniente; é uma questão de conformidade.
Então, o hábito operacional que eu recomendaria é simples: não trate a restauração de snapshot como um atalho — trate como o padrão — e deixe as reconstruções completas apenas para quando você realmente suspeitar de corrupção.
É uma pequena escolha operacional, mas é a diferença entre minutos de indisponibilidade e horas.
@Dusk #dusk $DUSK $GPS $STAR