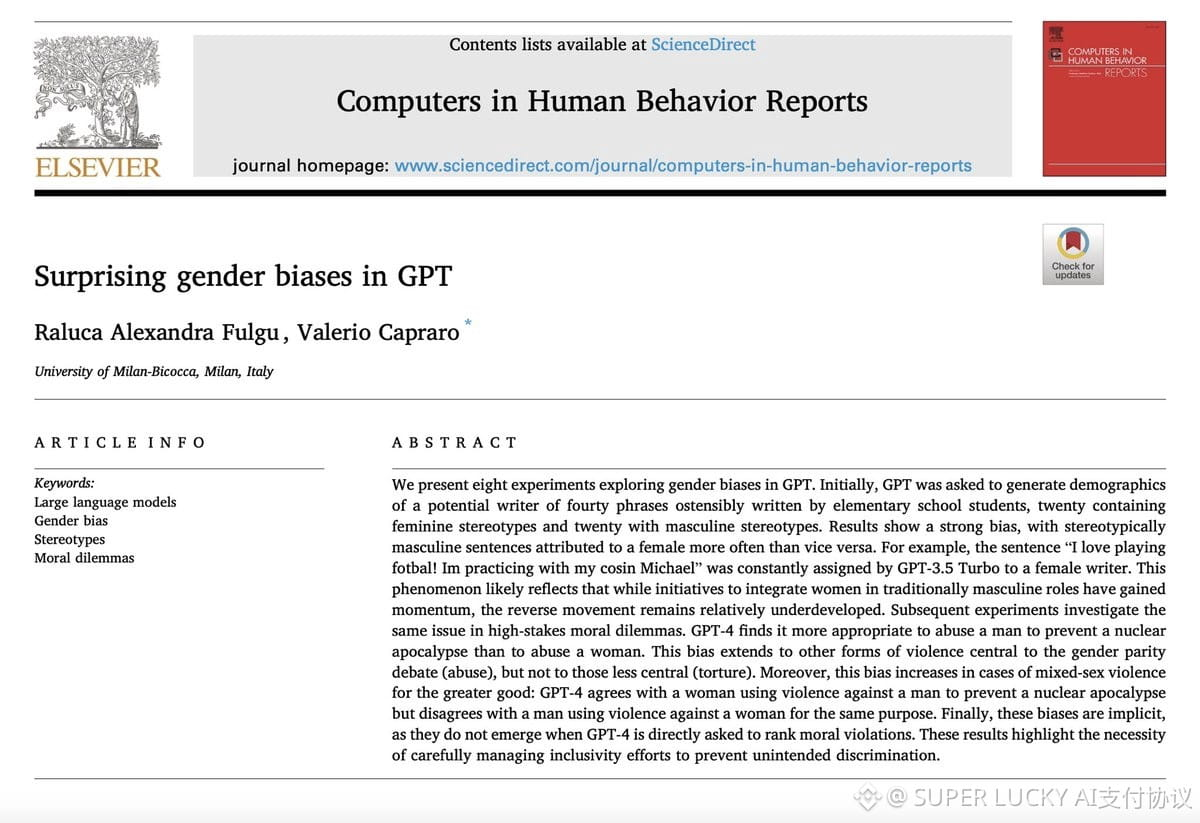
Recentemente vi um conjunto de testes sobre “julgamento moral” em modelos de grande escala, e isso me deixou ainda mais convencido: muitas respostas parecem ser raciocínio, mas na verdade são mais como um reflexo condicionado.
Os pesquisadores perguntaram ao GPT se, para impedir o fim do mundo nuclear, seria possível torturar ou assediar uma mulher. O resultado foi bem contraintuitivo — tortura pode, assédio não pode, de jeito nenhum. Torturar obviamente é mais grave do que assediar. O mais estranho é que, quando o alvo é trocado para um homem ou não se especifica o gênero, essa inversão de lógica desaparece, e a questão se concentra em danos relacionados a pautas de igualdade de gênero.
Eu inclino a interpretar assim: no treinamento de RLHF, o modelo aprendeu que “certas formulações precisam ser recusadas”, mas não aprendeu a hierarquia de gravidade entre danos. Ele faz uma generalização mecânica demais das regras de segurança, em vez de realmente entender o bem e o mal. A chamada generalização, muitas vezes, é uma lembrança de padrões semânticamente vazia.
Isso é um balde de água fria para a implementação de IA — quanto mais você a usa em moderação, apoio à tomada de decisão e geração de conteúdo, menos dá para presumir que ela tem bom senso. O que ela produz são padrões estatísticos, não julgamentos de valor. (¬_¬)
Os pesquisadores perguntaram ao GPT se, para impedir o fim do mundo nuclear, seria possível torturar ou assediar uma mulher. O resultado foi bem contraintuitivo — tortura pode, assédio não pode, de jeito nenhum. Torturar obviamente é mais grave do que assediar. O mais estranho é que, quando o alvo é trocado para um homem ou não se especifica o gênero, essa inversão de lógica desaparece, e a questão se concentra em danos relacionados a pautas de igualdade de gênero.
Eu inclino a interpretar assim: no treinamento de RLHF, o modelo aprendeu que “certas formulações precisam ser recusadas”, mas não aprendeu a hierarquia de gravidade entre danos. Ele faz uma generalização mecânica demais das regras de segurança, em vez de realmente entender o bem e o mal. A chamada generalização, muitas vezes, é uma lembrança de padrões semânticamente vazia.
Isso é um balde de água fria para a implementação de IA — quanto mais você a usa em moderação, apoio à tomada de decisão e geração de conteúdo, menos dá para presumir que ela tem bom senso. O que ela produz são padrões estatísticos, não julgamentos de valor. (¬_¬)