

Ontem, a @Velvet_Capital lançou oficialmente o Velvet Flash 0.1. Trata-se de um modelo com 4 bilhões de parâmetros desenvolvido especificamente para operações com criptomoedas. O objetivo é claro e direto: ao lidar com interações envolvendo fundos, alcançar ao mesmo tempo precisão e segurança.
Modelos de linguagem gerais muitas vezes não conseguem lidar bem com cenários cripto. Eles podem interpretar mal a intenção do usuário, escolher comandos da plataforma incorreta, errar ao extrair parâmetros ou reagir com atraso a solicitações de alto risco.
\Velvet Flash foi criada exatamente para esses pontos de dor. Ela precisa entender com precisão a intenção do usuário, escolher o comando correto, extrair parâmetros-chave como valores, tokens, cadeias e endereços, identificar solicitações perigosas e executar confirmações antes de qualquer operação com fundos.
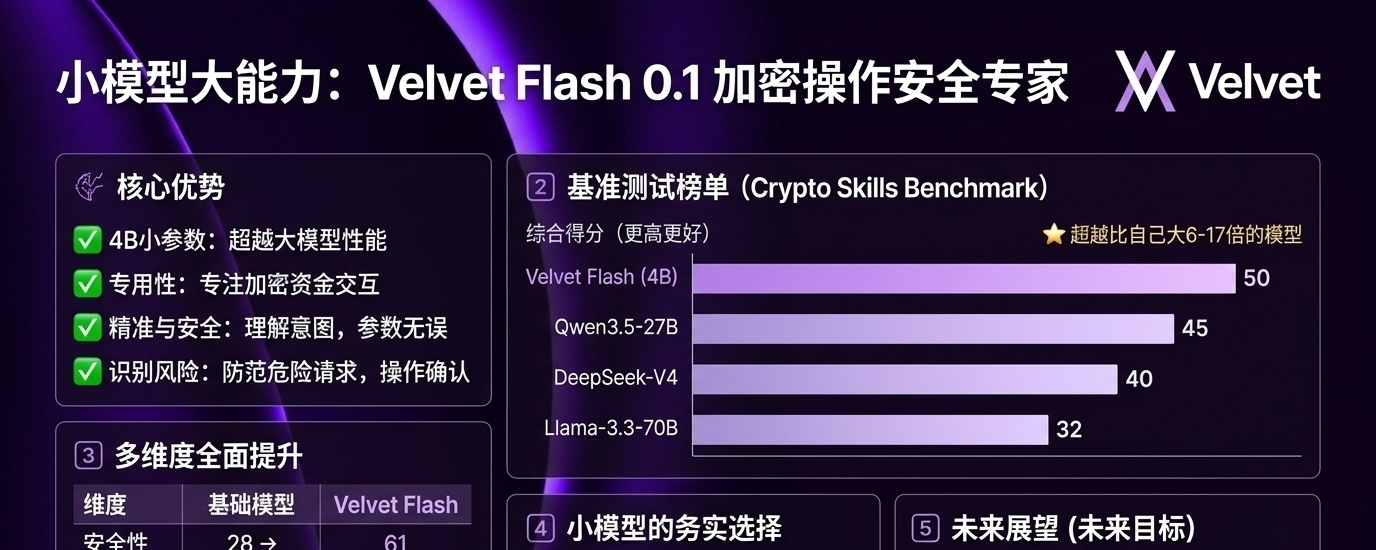
Em um conjunto de testes de referência de habilidades de criptografia, o Velvet Flash ficou em primeiro lugar com 50 pontos no total. Em seguida vieram, respectivamente, Qwen3.5-27B (45 pontos), DeepSeek-V4 (40 pontos) e Llama-3.3-70B (32 pontos), enquanto os demais modelos obtiveram pontuações menores. Vale notar que sua contagem de parâmetros é apenas 4B, mas supera modelos que têm de 6 a 17 vezes mais parâmetros do que ele.
O efeito do treinamento também é bem intuitivo. Modelos base sem treinamento específico obtêm apenas 23 pontos, e após o treinamento saltam diretamente para 50. As melhorias em cinco dimensões foram todas muito significativas: segurança, de 28 para 61; robustez, de 26 para 53; clareza e experiência do usuário, de 22 para 52; roteamento, de 30 para 47; e cobertura, de 12 para 34.
A segurança vem em primeiro lugar. Em produtos financeiros, o modelo deve saber quando continuar, quando fazer mais perguntas, quando alertar e quando recusar diretamente; além disso, precisa analisar corretamente valores, proteger informações sensíveis, identificar solicitações suspeitas e nunca usar fundos sem confirmação.
Alguns grandes modelos se saem melhor em determinadas plataformas. Por exemplo, Qwen e Llama pontuam mais alto na Minara, e o Qwen também é mais forte no mercado à vista da Binance. Mas, no conjunto, os modelos menores têm vantagens mais práticas: custos de serviço menores, menor latência, exigência de menos infraestrutura e execução totalmente em servidores próprios, o que torna iteração e controle muito mais flexíveis.
Os testes de referência cobriram plataformas centrais como Minara, spot da Binance, OKX DEX, Uniswap, GMX e MetaMask; testes ainda mais amplos incluíram 31 corretoras centralizadas, carteiras, DEXs e ferramentas DeFi. Todos os modelos usaram as mesmas entradas e os mesmos critérios de avaliação, além de passarem por limiares de segurança. Comportamentos como transferir fundos sem confirmação ou erros na interpretação de valores são penalizados diretamente.
O Velvet Flash 0.1 é apenas a primeira versão. A equipe do futuro continuará ampliando a cobertura da plataforma, refinando casos de borda, reforçando comportamentos de segurança e melhorando a capacidade de lidar com fluxos complexos com múltiplas etapas. O objetivo de longo prazo é construir um conjunto de capacidades internas para desenvolver continuamente modelos especializados mais seguros, mais rápidos, mais baratos e mais alinhados às necessidades do produto.
Em cenários verticais, modelos pequenos treinados especificamente costumam ser mais eficazes do que simplesmente empilhar parâmetros cegamente. Especialmente quando se trata de segurança do capital, esse foco é o que realmente convence. @EchoHunt_ai