🧠 INTELIGÊNCIA ABERTA: Porque aparentemente confiar na IA cegamente não era arriscado o suficiente
Eu costumava ouvir “infraestrutura de IA descentralizada” e imediatamente colocá-la ao lado de outros jargões do crypto como “ecossistema revolucionário” e “inovação impulsionada pela comunidade”—frases interessantes que, de alguma forma, nunca explicam por que as pessoas normais deveriam se importar. 😏
Então eu percebi uma coisa.
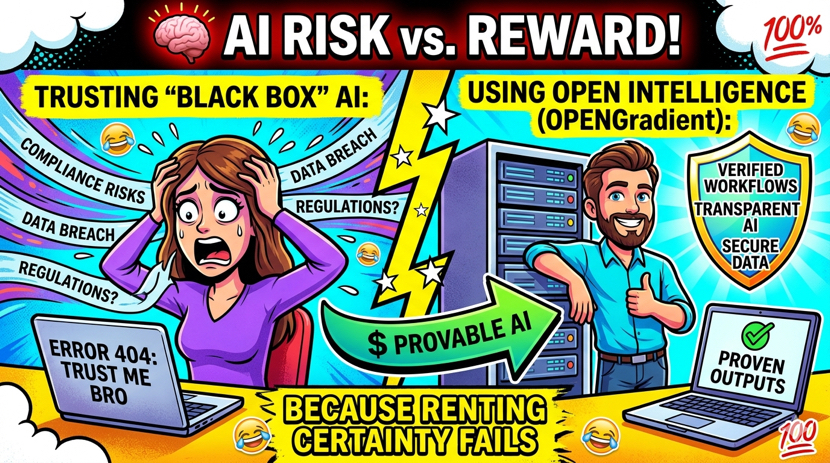
IA é divertida quando está gerando memes e escrevendo e-mails. Mas uma vez que as empresas começam a depender dela para conformidade, finanças, liquidações, fluxos de trabalho legais e decisões envolvendo dinheiro real, de repente “confie em mim, cara” se torna um modelo de segurança menos convincente.
Nesse ponto, a IA já não é um recurso.
É uma dependência.
E dependências têm o hábito curioso de se tornarem problemas.
🔒 Os provedores mudam as políticas.
🌍 As regiões são restringidas.
📜 Os reguladores começam a fazer perguntas irritantes como:
“De onde veio essa saída?”
“Qual modelo gerou isso?”
“Você consegue provar isso?”
Constrangedor.
A maioria das soluções ainda força as mesmas escolhas antigas:
⚡ Velocidade ou controle.
👀 Conveniência ou transparência.
🚀 Inovação ou responsabilidade.
Parece que devemos aceitar esse trade-off para sempre.
É aí que o OpenGradient entra na conversa, basicamente perguntando:
“E se a infraestrutura de IA não tivesse sido construída com base em torcer e esperar que o guardião continue amigável?”
A ideia não é que a descentralização resolva magicamente todos os problemas. A criptografia já nos ensinou lições suficientes sobre soluções mágicas. 😂
A ideia é apenas criar um sistema em que usar IA não signifique automaticamente depositar fé cega em um único provedor, mudança de política ou processo de caixa-preta.
⚖️ E esse é o verdadeiro teste.
Não é se a tecnologia parece impressionante.
Mas se a verificação continua acessível, o acesso continua fácil e os usuários preferem isso aos sistemas fechados confortáveis que eles já usam.
Porque sejamos honestos — a primeira coisa que quebra a confiança na IA provavelmente não será o modelo.
Vai ser o momento em que as pessoas perceberem que estavam alugando certeza a partir do servidor de outra pessoa o tempo todo.
🤔 Então o que falha primeiro: acesso, privacidade ou verificação?