Um trader compara dois projetos de IA.
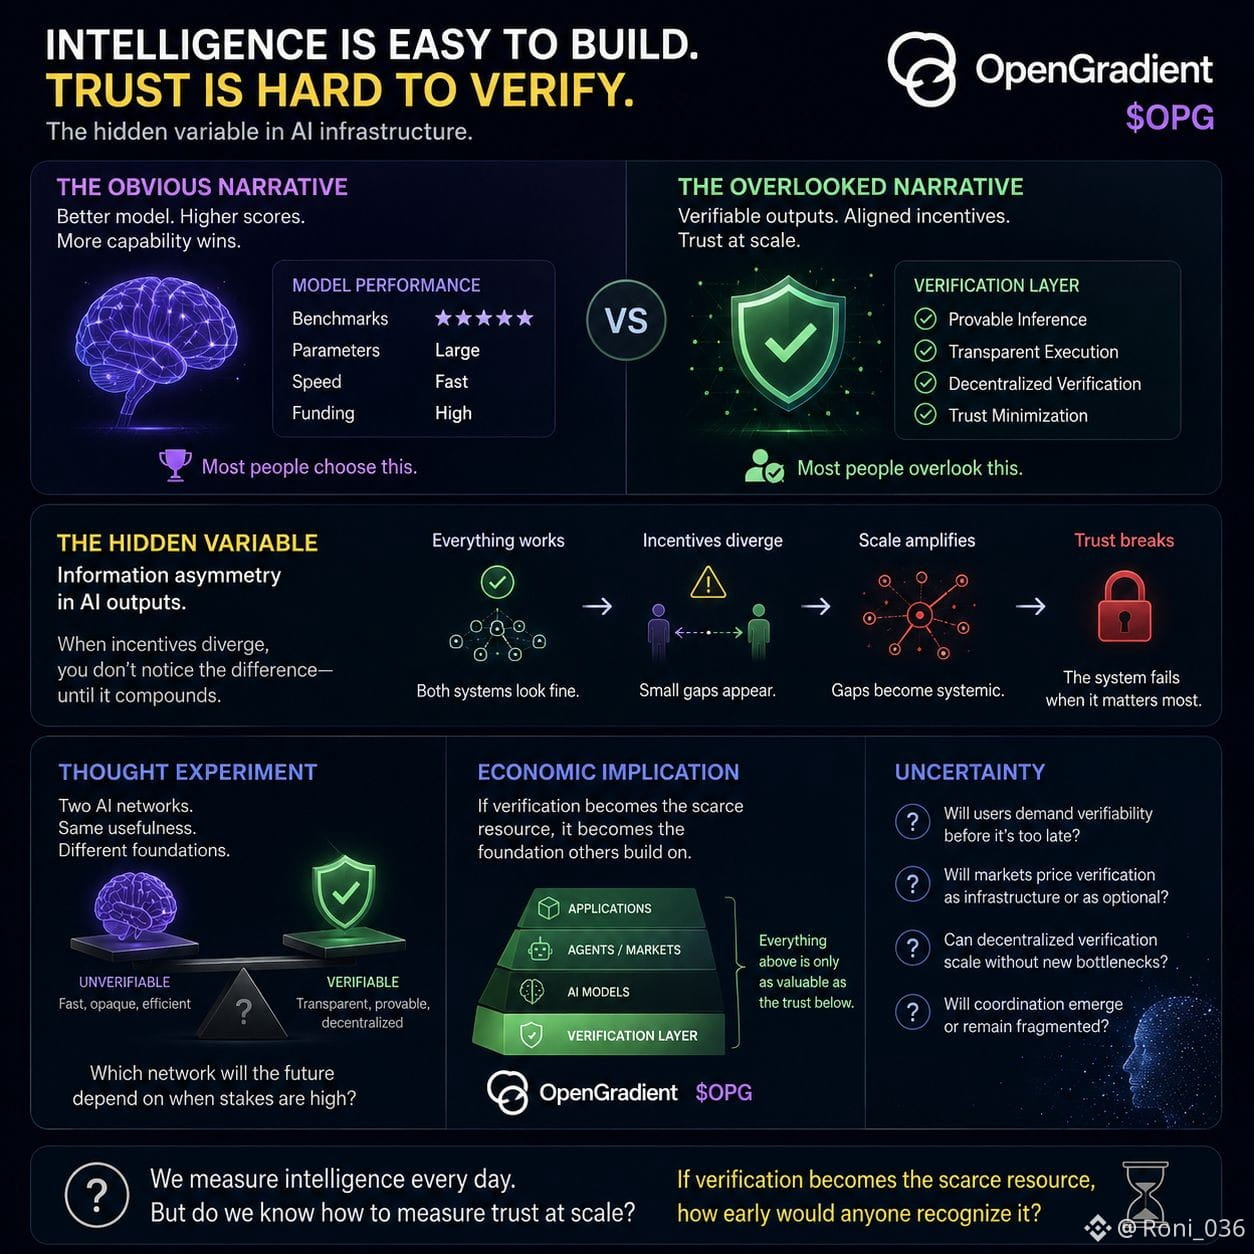
Um tem um modelo maior, mais financiamento e pontuações de benchmark mais altas.
O outro gasta a maior parte do seu esforço tornando as saídas do modelo verificáveis.
A maioria das pessoas provavelmente escolheria o primeiro.
Essa parece ser a narrativa óbvia em torno da infraestrutura de IA também. Melhores modelos ganham. Mais inteligência ganha. Mais capacidade atrai mais usuários.
No começo, eu pensei o mesmo.
Mas quanto mais eu penso sobre isso, mais me pergunto se a inteligência está sendo medida enquanto a verificação está simplesmente sendo assumida.
Imagine duas redes de IA produzindo saídas igualmente úteis.
Em uma rede, os usuários podem verificar independentemente como os resultados foram gerados. Na outra, a verificação existe principalmente através da reputação e confiança.
Ambas funcionam normalmente quando tudo vai bem.
A diferença só aparece quando os incentivos se tornam desalinhados.
Uma única saída não verificável pode não importar. Milhares provavelmente também não importam. Mas o que acontece quando mercados inteiros, agentes, aplicações e decisões automatizadas começam a depender de informações que não podem ser facilmente verificadas?
Visto por essa ótica, @OpenGradient $OPG parece menos uma questão sobre o desempenho da IA e mais uma questão sobre assimetria de informação.
Não se trata de saber se a inteligência pode ser criada.
Mas se a inteligência pode ser confiável em larga escala.
Não tenho certeza se o mercado já decidiu qual problema é realmente mais difícil.
E se a verificação eventualmente se tornar o recurso escasso, quão cedo alguém reconheceria isso?
#opg $OPG @OpenGradient
Um tem um modelo maior, mais financiamento e pontuações de benchmark mais altas.
O outro gasta a maior parte do seu esforço tornando as saídas do modelo verificáveis.
A maioria das pessoas provavelmente escolheria o primeiro.
Essa parece ser a narrativa óbvia em torno da infraestrutura de IA também. Melhores modelos ganham. Mais inteligência ganha. Mais capacidade atrai mais usuários.
No começo, eu pensei o mesmo.
Mas quanto mais eu penso sobre isso, mais me pergunto se a inteligência está sendo medida enquanto a verificação está simplesmente sendo assumida.
Imagine duas redes de IA produzindo saídas igualmente úteis.
Em uma rede, os usuários podem verificar independentemente como os resultados foram gerados. Na outra, a verificação existe principalmente através da reputação e confiança.
Ambas funcionam normalmente quando tudo vai bem.
A diferença só aparece quando os incentivos se tornam desalinhados.
Uma única saída não verificável pode não importar. Milhares provavelmente também não importam. Mas o que acontece quando mercados inteiros, agentes, aplicações e decisões automatizadas começam a depender de informações que não podem ser facilmente verificadas?
Visto por essa ótica, @OpenGradient $OPG parece menos uma questão sobre o desempenho da IA e mais uma questão sobre assimetria de informação.
Não se trata de saber se a inteligência pode ser criada.
Mas se a inteligência pode ser confiável em larga escala.
Não tenho certeza se o mercado já decidiu qual problema é realmente mais difícil.
E se a verificação eventualmente se tornar o recurso escasso, quão cedo alguém reconheceria isso?
#opg $OPG @OpenGradient