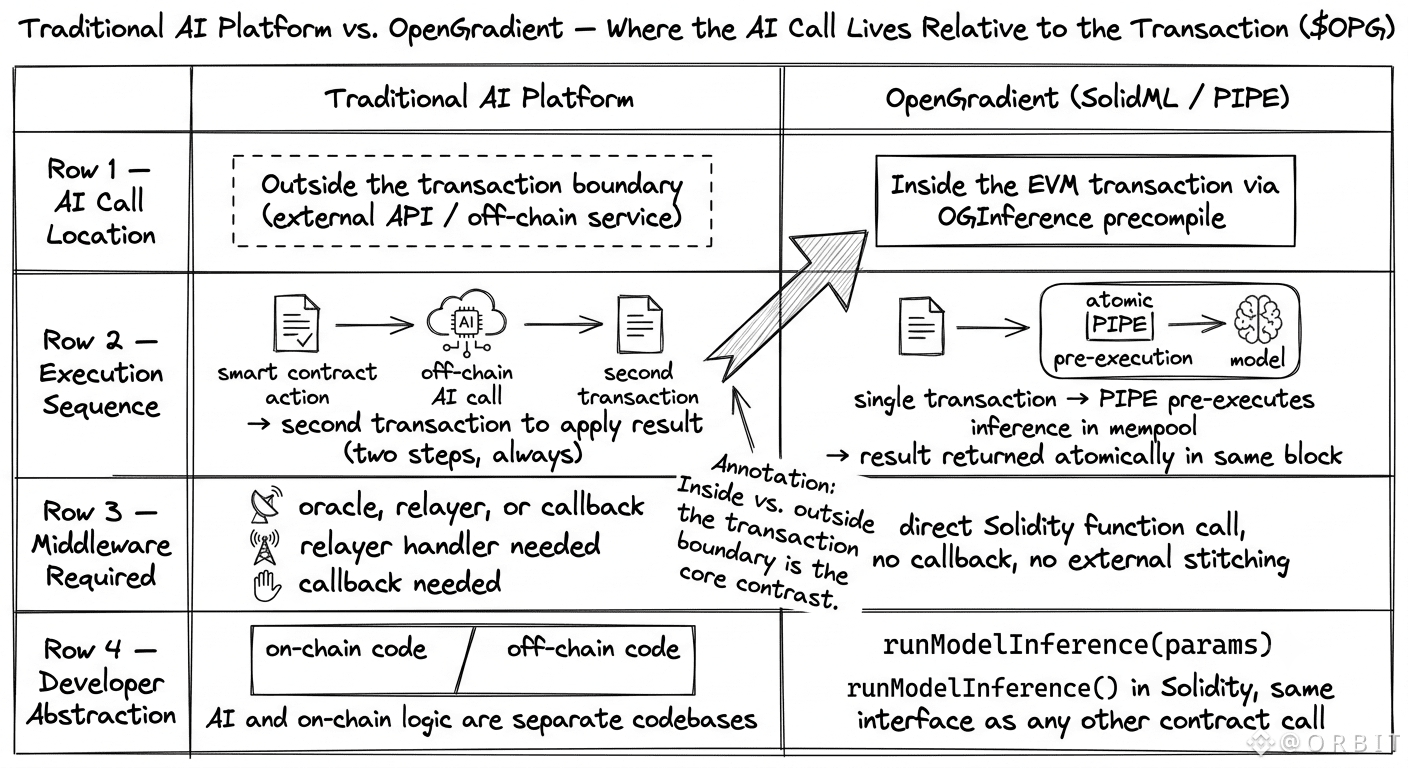
A coisa que separou a OpenGradient de qualquer plataforma de IA tradicional que eu já testei não é a história de verificação — é o primal de execução. @OpenGradient $OPG #OPG construiu um pré-compilado Solidity chamado OGInference que permite que um contrato inteligente chame um modelo de IA da mesma forma que chama qualquer outra função. runModelInference(). Uma linha. O resultado volta de forma atômica, dentro da mesma transação EVM. Sem callback de oracle. Sem roundtrip de API externa. Sem esperar uma segunda transação para fechar o ciclo.
Essa é uma escolha arquitetônica genuinamente diferente. OpenAI, Anthropic, todo provedor de nuvem — a inferência deles vive fora do limite da transação. A chamada de IA e a ação em cadeia são sempre dois passos separados, sempre costurados por middleware ou um relayer off-chain. PIPE — o Motor de Pré-Execução de Inferência Paralelizada — executa as inferências no mempool antes da construção do bloco, então, quando o bloco chega, o resultado já está lá. Sem congestionamento, sem sobrecarga EVM.
A listagem na Upbit em 15 de junho levou OPG a $357.69M em volume de 24 horas, um aumento de 606%. Tudo bem. Mas nenhum desse volume veio de protocolos DeFi chamando runModelInference() na sua lógica Solidity. Essa superfície de desenvolvedor está mal utilizada ainda.
E essa é a parte que eu continuo pensando. A coisa mais significativamente diferente sobre essa rede — IA como um primal de transação nativa — também é a coisa que requer que os desenvolvedores on-chain realmente reconstruam sua pilha em torno disso.
Então, a inferência atômica de IA é um novo primal que muda o desenvolvimento on-chain, ou continua de nicho até que os ecossistemas de ferramentas existentes decidam adotá-la?