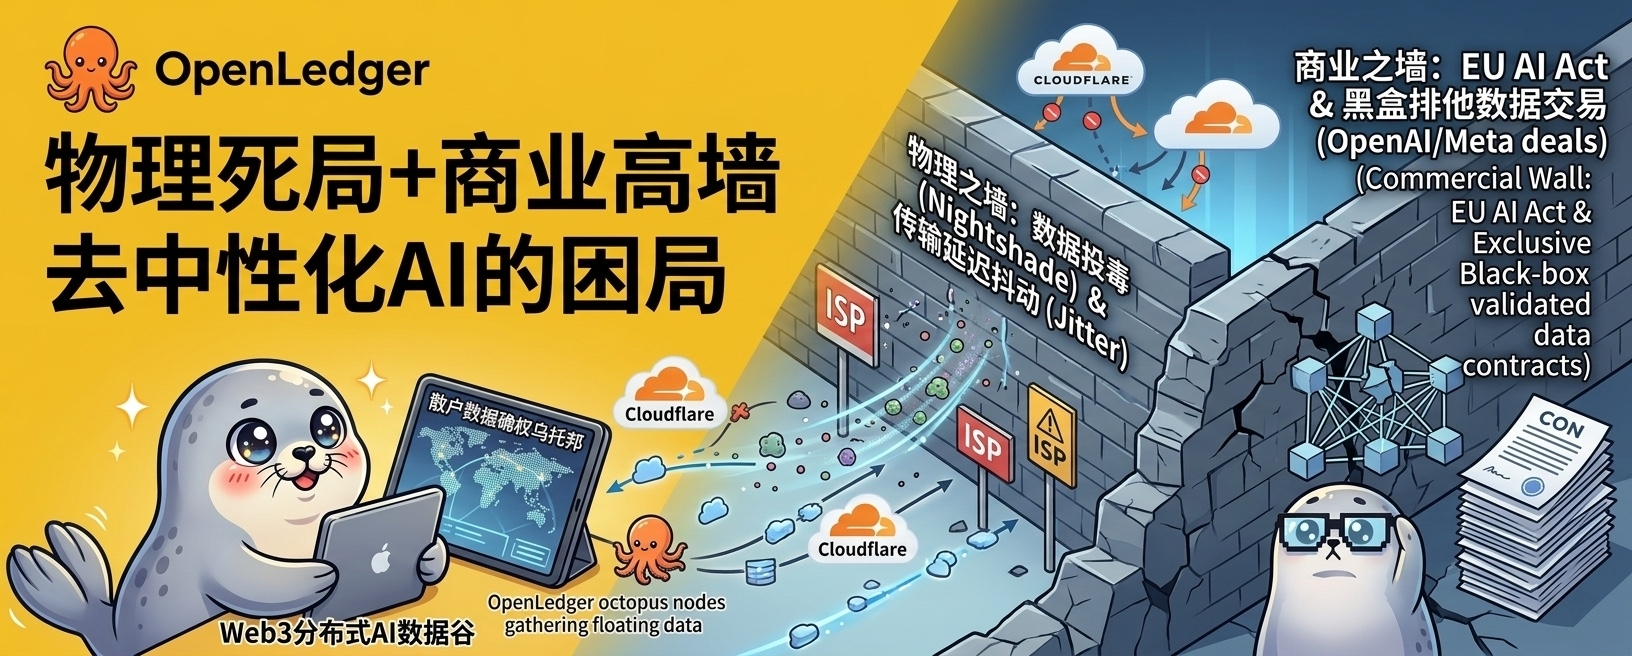

Em junho, o nordeste está no meio da temporada de chuvas, o ar úmido e a chuva incessante lá fora me deixaram inquieto. Justamente hoje é o último momento da missão $OPEN #CreatorPad , e o ar ao redor está carregado de apelos para entrar no jogo e gritos de “igualdade de dados na era da IA”. Preparei um café forte e amargo, olhando para a tela do computador onde a antiga notícia sobre a parceria entre OpenLedger e Story Protocol para o “direito automático de royalties em IA” chamou atenção, mergulhando em uma longa e dolorosa montanha-russa emocional.
Hoje, quando me forcei a sair de uma visão legal única e olhar para o todo com a perspectiva de um engenheiro de redes e a lógica de machine learning, a primeira sensação de deslumbramento estourou como uma bolha, deixando apenas um frio na alma — percebi que essa narrativa grandiosa é tão frágil diante das leis físicas, da segurança dos dados e das barreiras legais do mundo real, como um pedaço de papel encharcado.
Um começo impressionante: eu também já aplaudi de pé.
Temos que admitir que o plano desenhado pela @OpenLedger em parceria com o Story Protocol tem uma forte ressonância em termos puramente lógicos. Na cadeia de valor tradicional da IA, criadores, limpadores de dados e nós de borda estão sempre na base da cadeia alimentar. Gigantes como OpenAI e Google, com seu poder computacional e equipes jurídicas massivas, extraem dados gratuitos de todo o mundo para treinar seus modelos sem remorso. A proposta de Datanets (conjuntos de dados de propriedade comunitária) e ModelFactory da #OpenLedger atinge exatamente esse ponto. A combinação com o Story Protocol cria um ciclo que parece quase perfeito: pequenos investidores contribuem com dados através de nós, a OpenLedger utiliza o Proof of Attribution para registrar na blockchain cada contribuição que você faz para o modelo de IA; assim que esse modelo gera chamadas (Inference) na comercialização, o protocolo subjacente do Story Protocol aciona automaticamente, e os royalties são liquidadas em tempo real para os primeiros contribuidores de dados através de micropagamentos (Micro-transactions) usando o token OPEN.
Isso não é o que imaginamos como a utopia de IA distribuída e absolutamente justa do Web3? Para ser honesto, quando vi esse design pela primeira vez, quase me levantei para aplaudir. Mas é exatamente essa lógica interna que me fez, nos dias seguintes, sentir uma dor crescente a cada nova vulnerabilidade que eu descobria.
A vulnerabilidade fatal sob a sombra do 'Nightshade': o consenso descentralizado não consegue resistir ao 'envenenamento de dados'.
A OpenLedger sempre enfatizou que suas Datanets podem produzir materiais de treinamento de alta qualidade. Mas há um grande paradoxo lógico aqui: o mecanismo de consenso de uma rede descentralizada só pode validar se os dados 'concordaram', mas não pode verificar a 'verdade absoluta' dos dados no mundo físico.
Já em 2023, uma ferramenta de envenenamento de IA chamada Nightshade explodiu na comunidade geek. Veja a imagem abaixo. O terror dessa coisa é que ela pode alterar imagens ou textos em nível de pixel de uma forma invisível a olho nu. Você vê um gato, mas o vetor subjacente do modelo de IA o reconhece como um cachorro.
Agora, o que aconteceria se trouxéssemos essa ferramenta aterradora para a rede distribuída da OpenLedger?
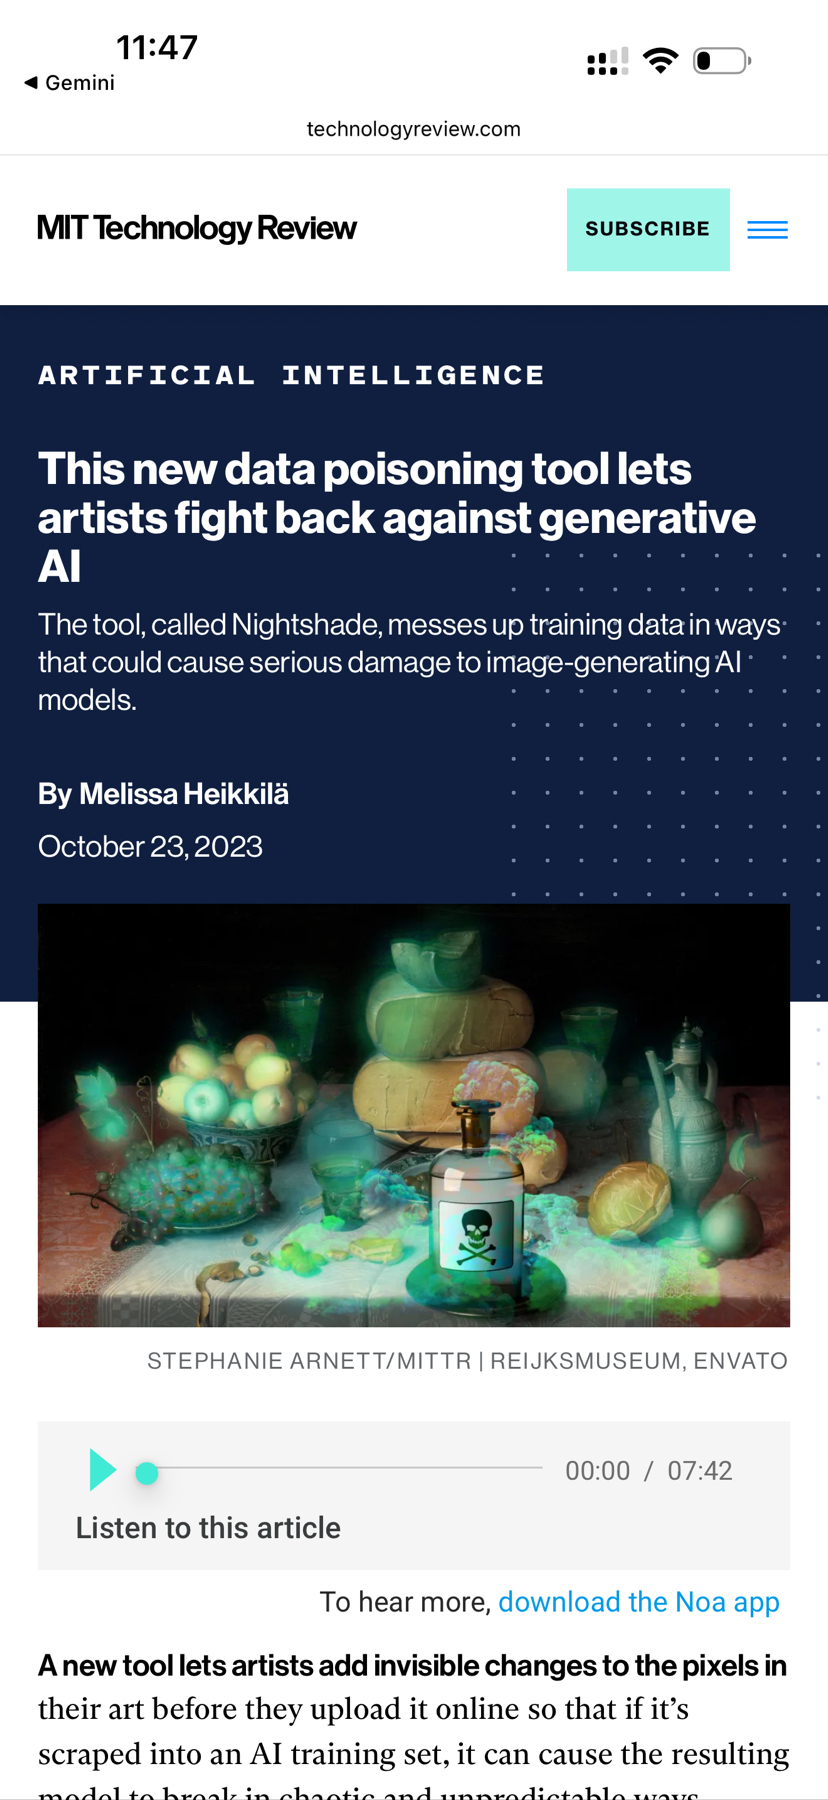
Em uma rede descentralizada e sem permissão, qualquer nó pode submeter dados. Se um grupo de hackers mal-intencionados, ou concorrentes, usar ferramentas como o Nightshade para realizar 'envenenamento invisível' em dados massivos, e depois dispersar esses dados através de milhares de nós anônimos para a rede OpenLedger, o algoritmo de consenso da rede apenas verificará se os hashes ou formatos desses dados estão em conformidade. Os nós, por interesse comum, podem até votar a favor desses 'dados tóxicos'. E qual é o resultado? Assim que o modelo de IA B2B compra esse conjunto de dados descentralizados contaminados, todo o peso da rede neural do modelo será devastado, o que em aprendizado de máquina chamamos de 'colapso do modelo'.
Nas grandes empresas centralizadas, a limpeza de dados tem um rigoroso mecanismo de isolamento e responsabilidade; mas em uma rede totalmente distribuída, quem se responsabiliza pelo 'envenenamento'? Se nem a 'pureza' dos dados pode ser garantida em 100% na prática, qual unicórnio de IA avaliado em bilhões vai confiar suas vidas a um modelo grande em uma rede anônima que pode ser envenenada a qualquer momento? Ao pensar nisso, eu realmente prendi a respiração. A chamada 'certificação de dados' pressupõe que os dados sejam 'bons dados'. Se não conseguimos nos proteger contra envenenamento adversarial, o que essa rede produz é lixo digital caro.
A maldição física do jitter: o pesadelo dos pipelines de IA corporativa.
O segundo ponto que quebrou minha linha de defesa é a dura realidade das barreiras físicas de hardware. Se você tem acompanhado as novidades do Vale do Silício, deve saber que empresas como a Groq, que projetam LPUs (unidades de processamento de linguagem) para inferência de IA, ou a nova arquitetura Blackwell da Nvidia, estão obsessivamente focadas em um indicador: latência ultra baixa e alta coerência de throughput de dados. O pipeline de processamento de dados da IA comercial moderna exige que a latência de transmissão entre bancos de dados vetoriais e unidades de computação chegue ao nível de microssegundos. E que tipo de rede a OpenLedger está tentando construir? Ela quer depender de terminais espalhados pelo mundo, com ambientes de rede completamente variados, para realizar a limpeza e vetorização de dados distribuídos.
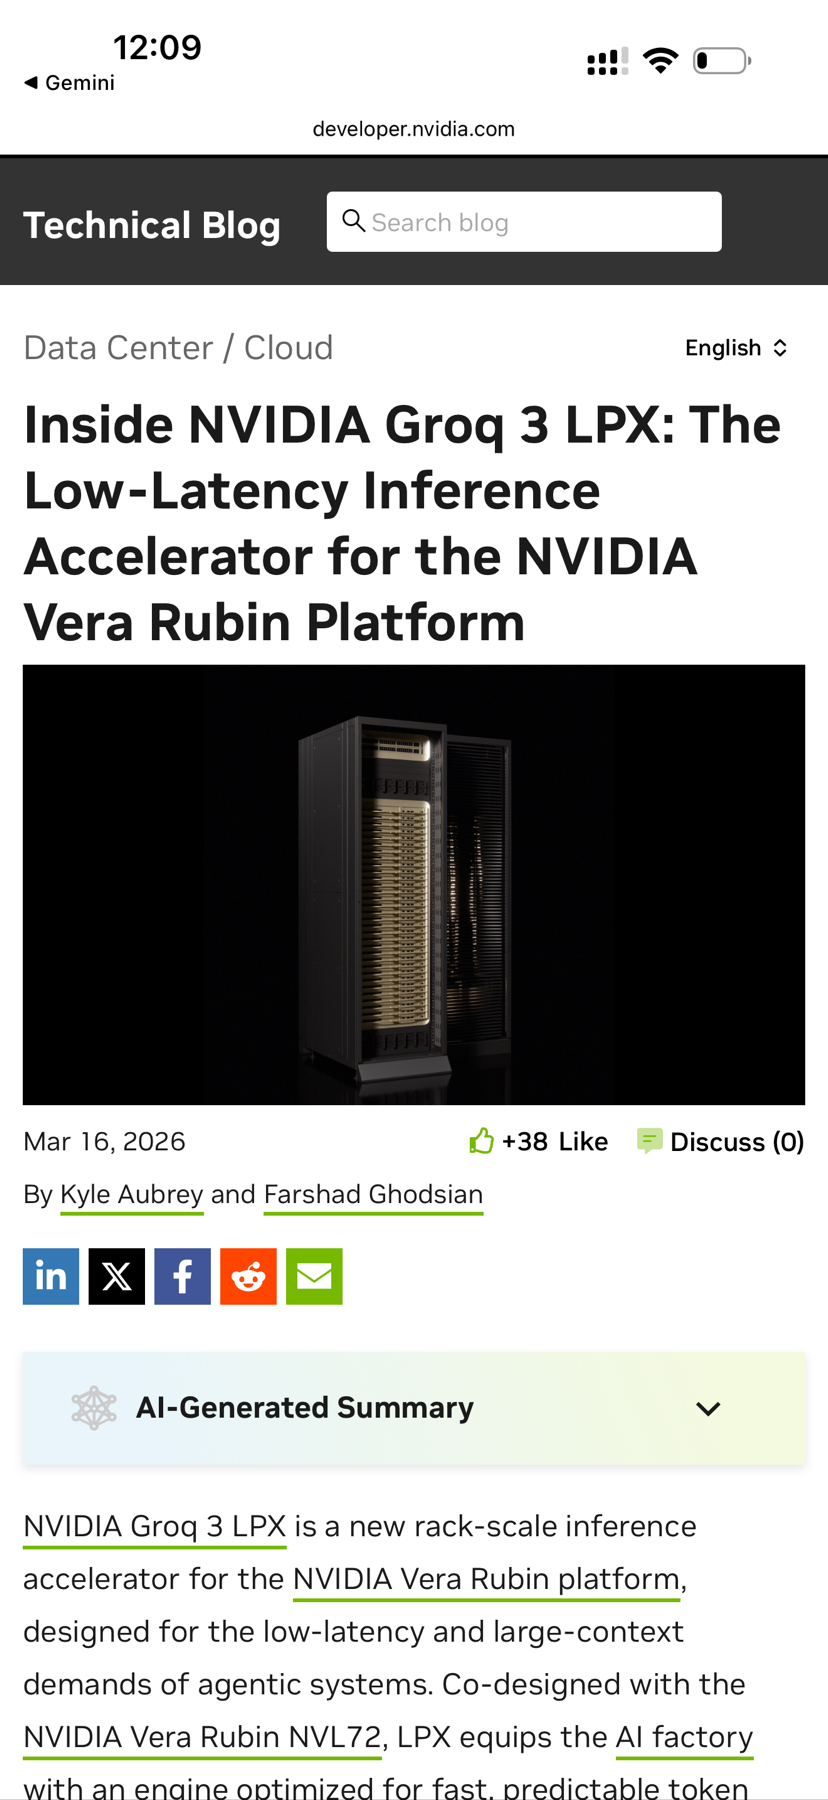
Tive uma conversa profunda com um colega que tem experiência prática em implantação em nuvem, e achei essa arquitetura absurda. Se o seu nó no Japão encontra congestionamento na rede ou se o nó no Oriente Médio tem a largura de banda reduzida hoje, toda a cadeia de processamento de dados vai ter uma explosão instantânea de 'latência e jitter'. Para aplicações de IA corporativa que exigem estabilidade absoluta e feedback em tempo real, essa latência de transmissão de algumas centenas de milissegundos ou até segundos, e a taxa de perda de pacotes, são um desastre inaceitável. Eles tentam desafiar as leis da física da propagação à velocidade da luz e da topologia de rede com uma política de 'descentralização'. É como querer puxar um motor de um Boeing 747 que precisa de sincronização extrema usando dez mil tratores improvisados. O conceito é sexy, a prática é magra.
Quando sobrepus essas duas armadilhas físicas, a sensação inicial de encantamento foi substituída por uma racionalidade quase fria.
O custo invisível dos IPs de pequenos investidores.
No processo de esfriar as emoções, há outra dimensão que me deixou gelado: o cerco físico que já ocorreu no mundo real contra a coleta de dados descentralizada.
Em suma, quando um nó de banda larga doméstica toca inadvertidamente o firewall de um site alvo, o IP residencial é instantaneamente marcado como 'fonte de ataque malicioso' pelo CDN internacional. Esse golpe pesado atinge diretamente os capilares nos quais a OpenLedger depende para sobreviver, e lança uma sombra densa sobre a narrativa de 'todos contribuem, todos se beneficiam'.
A falta de um ciclo comercial: sob a sombra da Lei de IA da UE, quem paga pela 'auto-satisfação em blockchain'?
Ainda mais desolador é o completo descolamento desse mecanismo automático de royalties da lógica legal e comercial real. Temos que admitir uma realidade brutal: a 'direitos autorais' e 'royalties' definidos por redes descentralizadas não têm capacidade alguma de forçar reembolsos e conformidade no domínio legal tradicional dos gigantes da IA do Web2. Em 2026, as estratégias legais centrais de empresas como OpenAI e Meta já evoluíram para levantar a bandeira do 'uso justo', ou assinar diretamente acordos de autorização de dados em black box com grandes grupos de mídia. Esses gigantes do B2B, que dominam a narrativa da indústria, não encontram nenhum incentivo comercial para se conectar a um protocolo de liquidação de royalties descentralizado que opera em uma zona cinzenta legal composta por investidores anônimos globais. Sem a entrada desses maiores compradores, o mecanismo de pagamento automático de royalties da OpenLedger acabará se tornando apenas um 'autoengano' dentro de sua própria ecologia.
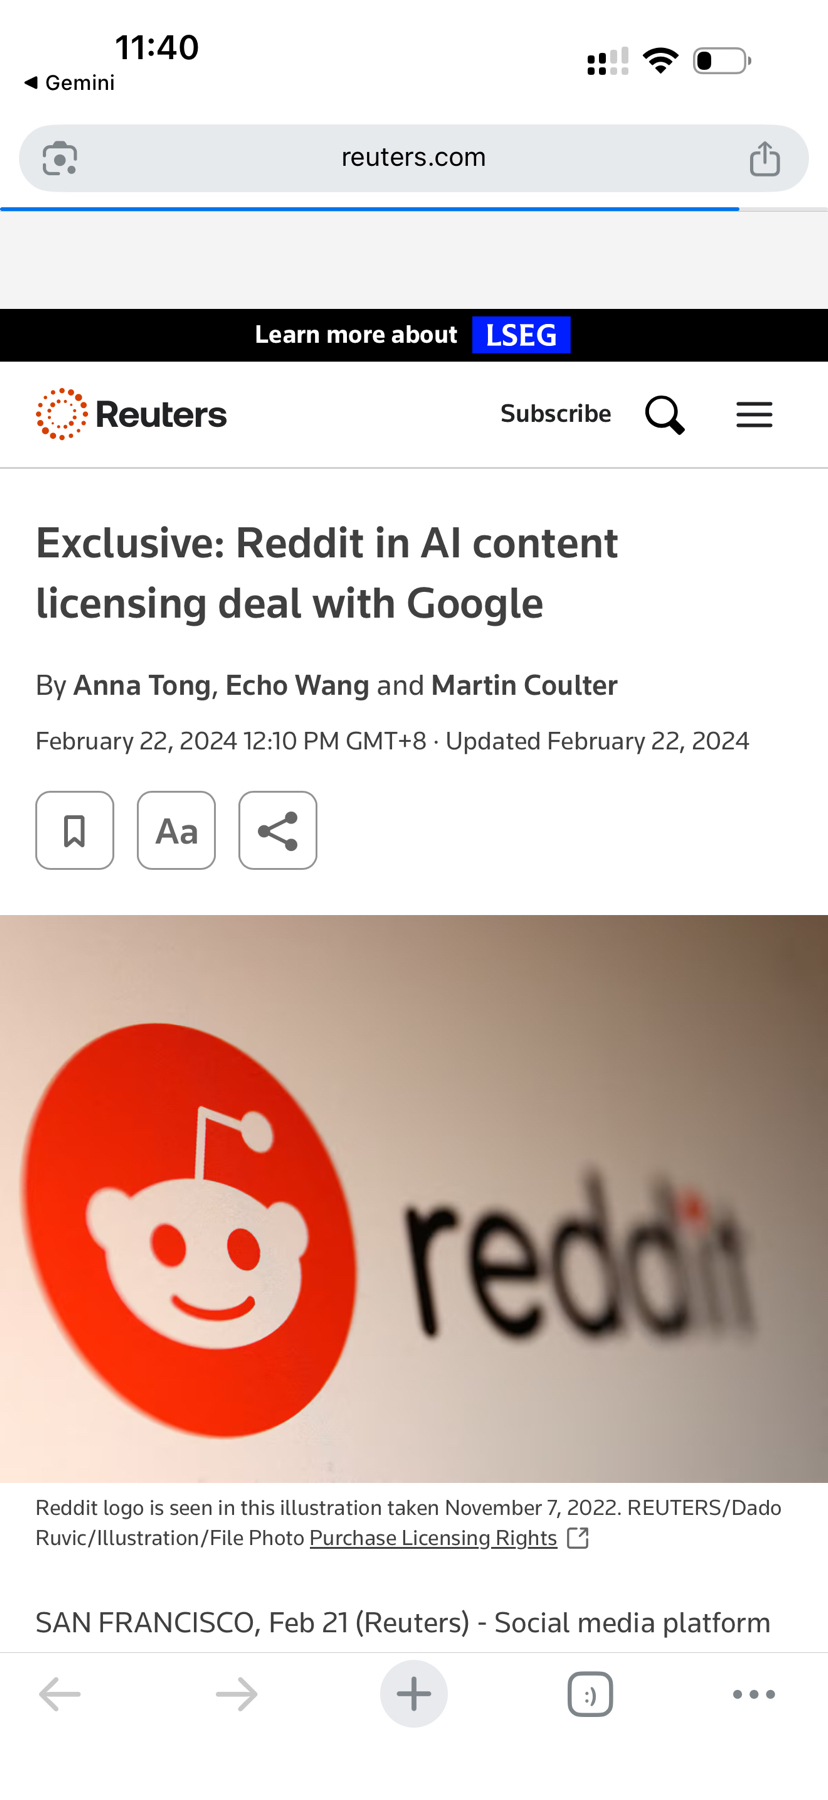
Por exemplo, segundo uma reportagem da Reuters, em 2024, o Google e o Reddit também fecharam um acordo de dados de IA de 60 milhões de dólares por ano.
E a cortina de ferro da regulamentação da UE praticamente fechou essa estrada já estreita. Com a implementação gradual da Lei de IA da UE, a 'limpeza' dos dados de treinamento de modelos grandes foi elevada a uma altura política e legal sem precedentes. De acordo com os requisitos de implementação faseados da lei, a partir de agosto de 2025, os provedores de modelos de IA geral devem publicar um resumo 'detalhado o suficiente' do conteúdo dos dados de treinamento e executar rigorosamente políticas de governança de dados e conformidade de direitos autorais; os dados de entrada de sistemas de IA de alto risco devem ser rastreáveis, sem viés e sem violação. Recentemente, a Comissão Europeia já exigiu que todos os fornecedores de modelos básicos que operam dentro da jurisdição apresentem relatórios de auditoria sobre as fontes de coleta e processos de limpeza de dados. Qualquer dado de origem desconhecida ou com risco de violação pode levar à retirada do modelo completo.
Sob as exigências quase severas de linhagem de dados, as Datanets da OpenLedger pisaram em cada mina. Seu pipeline distribuído depende de milhares de nós não verificados KYC em todo o mundo para upload e limpeza inicial; mesmo que apenas um desses nós insira maliciosamente um pouco de 'dados tóxicos' protegidos, a conformidade do conjunto de dados na cadeia vai desmoronar instantaneamente. Nenhuma empresa de IA comercial apostaria bilhões investidos em um modelo grande que carrega seu núcleo de negócios em uma rede anônima sem garantias de limpeza de dados. Não importa quão nobres sejam as ideais de descentralização, diante de um relatório de auditoria de conformidade frio, qualquer 'consenso comunitário' não pode substituir a eficácia legal da certificação em whitelist.
Conclusão | Mantenha a faísca, mas não pague mais por armadilhas físicas e ilusões comerciais.
A chuva lá fora ainda cai, e o café na xícara já esfriou. Não sou hater da equipe da OpenLedger, na verdade, sou um apoiador fervoroso da DeAI. Reconheço o avanço que a arquitetura OpenLoRA trouxe em eficiência de implantação com uma única GPU, e até a visão do fundador Pryce Adade-Yebesi é impressionante. Mas, ao tirar toda a camada superficial, vejo um consenso frágil que não consegue resistir a ataques de envenenamento de dados, uma infraestrutura básica que não aguenta os exigentes requisitos de latência de IA corporativa e um modelo de negócios que não encontra apoio em leis de copyright e estratégias de compra de gigantes. Isso não vem da minha desesperança com o setor DeAI+DePIN; ao contrário, eu realmente quero que este setor sobreviva, e não posso mais tolerar projetos que colocam nós, pequenos investidores, na linha de frente contra a fúria dos gigantes, sem compradores comerciais, isenções legais e proteção real de IP.
Antes que a equipe oficial apresente um verdadeiro relatório de testes de estresse de 'anti-envenenamento de dados' auditado por terceiros, comprovando que sua latência de rede pode atender às exigências de busca vetorial em nível industrial, e que mostrem um relatório financeiro real com pedidos de compra em conformidade de grandes empresas de IA do Web2, eu baixarei minhas expectativas a zero. Qualquer plano sobre 'milhares de royalties automáticos' deve, aos meus olhos, ser descontado dos riscos envolvidos. Manter um nível mínimo de participação, preservar a faísca, mas nunca expandir cegamente a exposição ao risco dos ativos - neste mês repleto de armadilhas narrativas, manter um ceticismo e racionalidade de engenheiro talvez seja a única dignidade que podemos deixar para nós mesmos.
Desliguei a tela, e aquele frio ainda não desapareceu.