
O que realmente chama minha atenção ao analisar os mecanismos de auditoria de segurança na plataforma OpenLedger não é a eficiência criptográfica dos contratos de "auditoria cega"; existe uma enxurrada de projetos oferecendo soluções de software para bloquear o acesso de terceiros ao conteúdo armazenado. Mas a pergunta mais urgente, e a estrutura de pensamento de Karl, é se esse fechamento total protege a integridade do conhecimento ou se oferece um ambiente perfeito para a passagem de manipulações comportamentais que são impossíveis de serem rastreadas programaticamente.
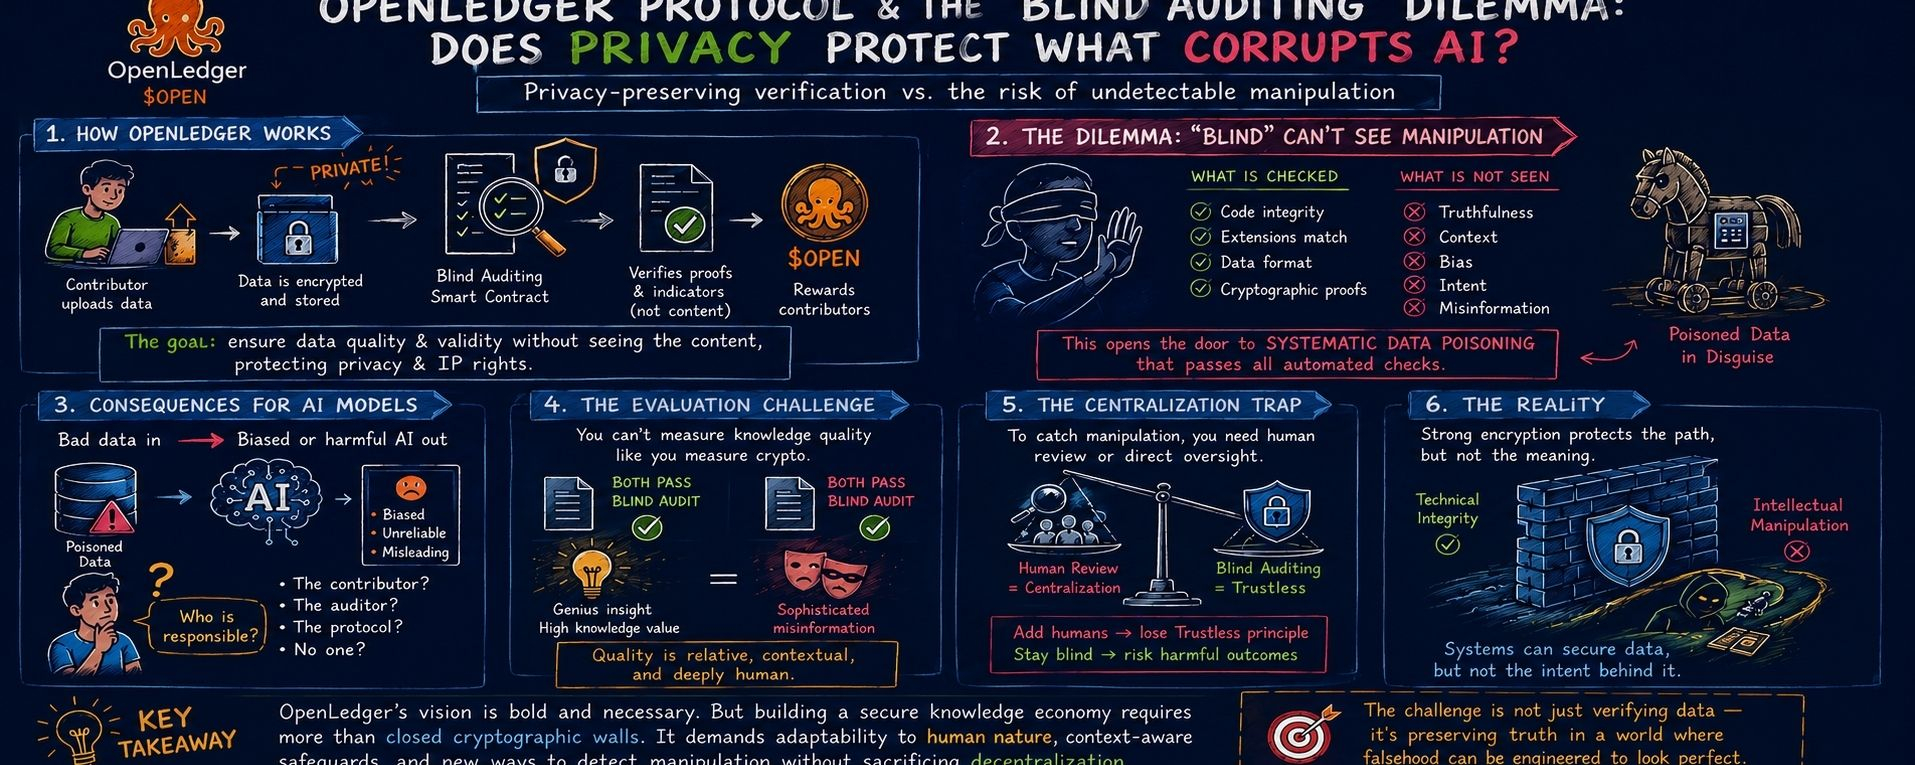
A tese parece perfeita do ponto de vista teórico; pois o protocolo busca garantir a qualidade e a validade dos dados por meio de contratos inteligentes que verificam indicadores sem tocar na essência do material carregado, para preservar a privacidade dos contribuidores e seus direitos de propriedade por meio do $OPEN. Esse equilíbrio parece coerente, mas a transformação dos mecanismos de criptografia em uma ferramenta para classificar verdades é onde os desafios se entrelaçam e sua retidão inevitável se perde.
A visão técnica da rede pressupõe que o isolamento dos dados e a ocultação de sua visualização criam automaticamente um ambiente seguro, mas vejo nesse direcionamento uma simplificação excessiva de uma equação extremamente complexa. A capacidade de verificar a integridade dos códigos e a compatibilidade das extensões no livro-razão público sem inspecionar o conteúdo cognitivo pode abrir espaço para uma enorme “porta dos fundos” para o que é conhecido como “envenenamento de dados” (Data Poisoning). Há um fio muito tênue entre preservar a identidade digital da informação e permitir a transmissão de desinformação sofisticada, e as criptografias rigorosas nem sempre possuem consciência suficiente para determinar onde está esse fio.
Esse dilema se enraíza ao considerar a responsabilidade dos modelos finais; a descentralização e o ocultamento do conteúdo proporcionam uma sensação de segurança incondicional até que algoritmos de IA comecem a revelar vieses catastróficos ou resultados enganosos em razão de terem sido alimentados com dados estruturalmente corrompidos que foram transmitidos sob o manto da privacidade. Nesse momento, quem assume a responsabilidade? Um protocolo que depende totalmente de criptografia pode enfrentar uma limitação estrutural para rastrear as raízes de uma violação comportamental, enquanto a transição para a verificação humana ou a supervisão direta recolocaria o sistema imediatamente no quadrado do centralismo e apagaria o slogan “não há necessidade de confiança” sobre o qual o projeto foi construído.
O lado avaliativo do conteúdo impõe dilemas adicionais; os dados destinados à inteligência artificial não podem ser medidos quanto à qualidade como moedas digitais padronizadas, pois seu valor é relativo e depende totalmente do contexto e do significado humano. Dois softwares podem passar no teste de “auditoria cega” com a mesma pontuação numérica, mas um deles contém um fluxo cognitivo genial, enquanto o outro traz uma desinformação cuidadosamente redigida com uma roupagem técnica impecável. Com isso, apostar na automação da qualidade dos ativos intelectuais sem compreender sua natureza pode revelar-se mais complexo do que a literatura técnica do projeto faz crer.
Essa contradição não diminui a ambição da OpenLedger; ao contrário, mostra que construir uma economia de conhecimento segura exige algo além de simples muros cegos de criptografia. O resultado final não vai depender apenas de quão sólidos são os contratos de “verificação cega”, mas de quão flexível é o protocolo para lidar com a natureza humana, caprichosa e hábil em explorar brechas regulatórias; os códigos podem garantir a integridade do percurso técnico, mas se mostram impotentes diante da proteção do conteúdo contra a falsificação intelectual sistemática.