Eu continuo voltando pra mesma pergunta, e honestamente, eu ainda não consigo chegar a uma resposta clara…
Todo mundo tá falando sobre cripto de IA agora. O barulho tá insano. Você vê redes de GPU, marketplaces de modelos, plataformas de agentes—dezenas de projetos correndo pra definir como dados, modelos e agentes autônomos interagem. Mas quando eu realmente tento escolher qual deles tá construindo uma infraestrutura de verdade, e não só hype, eu fico confuso.
É Bittensor com sua enorme rede de sub-rede? Fetch.ai empurrando todos esses "agentes autônomos"? Render com sua rede de aluguel de GPU? Ou é algo mais discreto como OpenLedger?
É aqui que as coisas ficam interessantes...
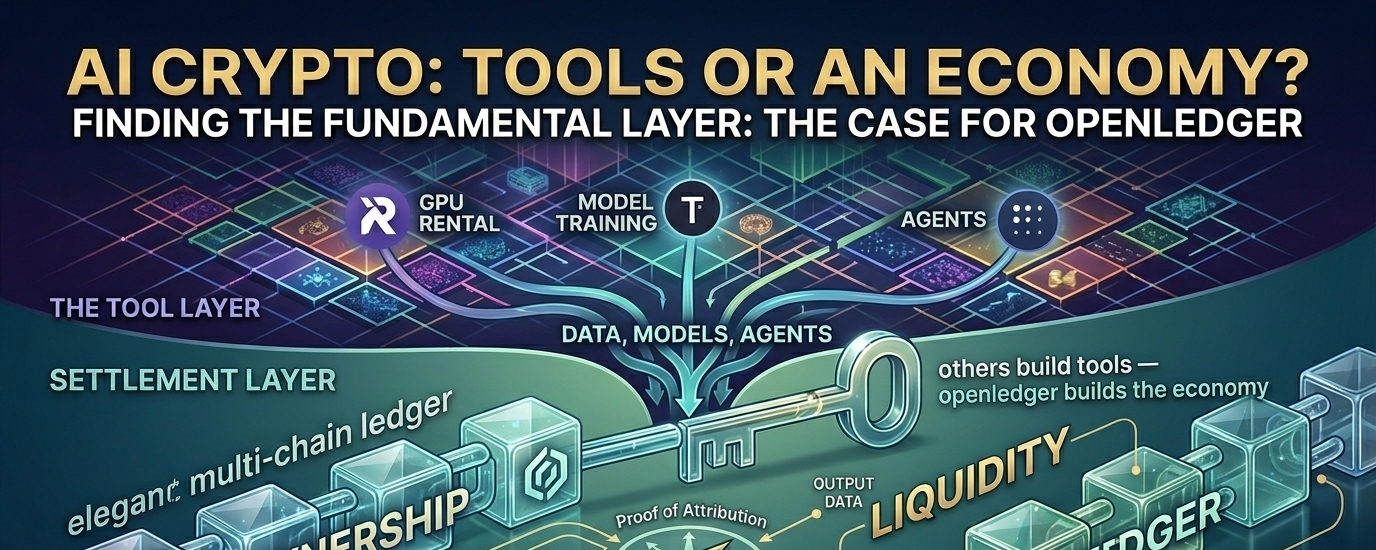
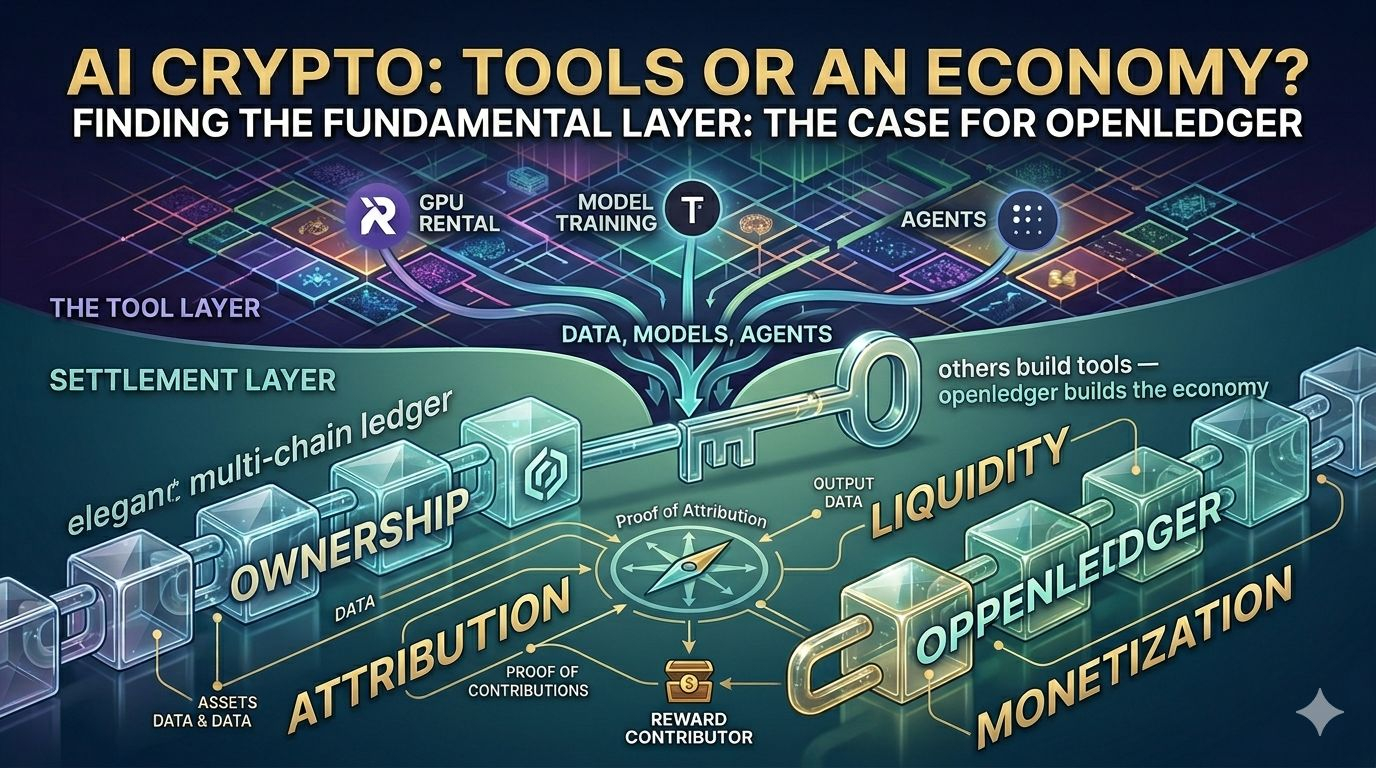
Eu paro e penso aqui… porque quase todo projeto de IA em cripto está resolvendo apenas uma parte da pilha de IA. É como se todos estivessem construindo ferramentas, mas ninguém estivesse construindo a economia ao redor dessas ferramentas.
A Render te dá poder de GPU. O Bittensor coordena o treinamento de modelos entre nós. A Fetch.ai constrói agentes que podem realizar tarefas. A SingularityNET é um mercado para serviços de IA. Todos úteis, mas algo está faltando por baixo de tudo isso...
Quem possui os dados?
Quem recebe quando um modelo usa seus dados?
Como você prova de onde realmente veio o conhecimento de um modelo?
Como tudo isso se torna líquido, negociável, monetizável?
A maioria das pessoas ignora isso. Elas se concentram em computação, ou modelos, ou agentes... mas não na camada econômica que faz dados, modelos e agentes realmente fluírem como valor. Sem essa camada, você só tem ferramentas caras paradas, não uma economia.
Estive pensando em como a IA funciona hoje no mundo real, e é bagunçado. Grandes empresas pegam dados de toda parte. Elas treinam modelos. Vendem acesso. Os criadores de dados originais? Eles não vêem nada. Sem uma forma clara de atribuir dados à sua fonte, sem como rastrear como aqueles dados influenciaram um modelo, sem como pagar automaticamente as pessoas certas, sem como provar para as instituições que os dados são legítimos e estão em conformidade.
Os humanos não conseguem fazer isso manualmente em escala. Advogados, contratos, auditorias... é muito lento, muito caro, muito opaco.
Então a pergunta real não é "quem tem os melhores modelos?"
É: "Quem está construindo a infraestrutura onde dados, modelos e agentes podem se tornar ativos líquidos?"
É aqui que a OpenLedger continua chamando minha atenção...
A OpenLedger não está tentando ser outra rede de GPU. Não é apenas outro mercado de modelos. Não é apenas sobre agentes. Está se posicionando como a camada de liquidação para o valor da IA.
A ideia central é simples, mas é perigosa de uma boa maneira: cada conjunto de dados, modelo, adaptador e agente se torna um ativo verificável, atribuível e compensável na blockchain. Através de algo chamado Prova de Atribuição, ela rastreia como os dados influenciam os resultados e recompensa os contribuidores automaticamente. A cadeia compatível com EVM permite que modelos e agentes treinados sejam negociados, combinados e chamados facilmente.
Em outras palavras: a OpenLedger quer transformar a IA em uma economia líquida de inteligência, onde o valor flui de volta para os contribuidores, não apenas para as pessoas que possuem os modelos. Até 2026, já está listada na Binance com um suprimento circulante de cerca de 215.5M OPEN de um total de 1 bilhão, negociando em torno de $0.18.
Quando comparo isso com os outros grandes jogadores, as diferenças começam a afinar...
O Bittensor é tudo sobre treinamento de modelos descentralizado e competição de inteligência via sub-redes. É mais sobre treinamento coletivo e computação/inteligência geral. A OpenLedger, por outro lado, é mais como a camada de liquidação para a realização de valor da IA. O Bittensor pergunta "Como treinamos modelos coletivamente?" enquanto a OpenLedger pergunta "Como dados, modelos e agentes se tornam ativos negociáveis, monetizáveis e atribuíveis?". A OpenLedger não tenta superar o Bittensor em inteligência bruta. Ela traça um nicho diferente: monetização de dados e conformidade empresarial. Ainda não estou totalmente convencido de que isso vai superar o efeito de rede do Bittensor... mas o ângulo é diferente o suficiente para que ambos possam coexistir.
A Fetch.ai é forte em agentes de IA autônomos e sistemas multi-agente para tarefas como otimização de cadeia de suprimentos ou negociação de energia. É mais como middleware onde agentes interagem em mercados. A OpenLedger vai mais longe: quer incorporar todo o ciclo de vida na blockchain, não apenas a interação de agentes. A Fetch.ai é a "Camada de Agentes", enquanto a OpenLedger está se chamando de Camada de Liquidez. Se a Fetch.ai é sobre agentes interagindo em mercados, a OpenLedger é sobre modelos, dados e agentes como uma economia líquida onde tudo é atribuível e monetizável. Isso é uma afirmação ousada. Estou curioso, mas não convencido.
Render é uma rede de aluguel de GPU. Ela resolve a distribuição de poder computacional bruto. A OpenLedger não é outra rede de GPU. Ela aborda a camada de responsabilidade. Render diz "Aqui está o poder de GPU." A OpenLedger diz "Aqui está a camada onde as contribuições são reconhecidas, os resultados são verificáveis e o valor é atribuído". Eles não são concorrentes diretos. Na verdade, a OpenLedger faz parceria com a io.net para computação de GPU, que toca o espaço da Render, mas adiciona liquidez e atribuição por cima. Então a pergunta se torna: qual camada é mais fundamental a longo prazo? Computação ou a camada econômica/atributiva?
Preciso ser honesto aqui... há muitas partes móveis para a OpenLedger. Você precisa de Prova de Atribuição que realmente funcione em escala, um mercado de modelos funcional onde as pessoas negociam modelos e adaptadores, monetização real para os contribuidores de dados e adoção empresarial para IA explicável e fontes de dados em conformidade. Isso é muita coisa.
Mas aqui está o ponto real... até 2026, mais empresas vão precisar de IA explicável e fontes de dados em conformidade. Elas não podem mais pegar dados aleatórios da internet e treinar modelos. Precisam de transparência, auditabilidade e propriedade clara. A combinação transparente + líquida da OpenLedger pode atrair aplicações do mundo real, não apenas fundos especulativos. Ao construir na OP Stack como uma camada 2 do Ethereum, também é compatível com EVM, o que significa que os desenvolvedores podem realmente construir sobre isso sem aprender uma linguagem completamente nova.
Ainda assim, a execução é tudo. Se a equipe não conseguir entregar um mercado de modelos suave, verdadeira atribuição e liquidez real, isso se torna outro sonho de whitepaper. Estou observando de perto, mas ainda não estou totalmente convencido.
Mas se a OpenLedger realmente conseguir isso... seria a infraestrutura financeira da economia de IA, não apenas outro mercado. Pense nisso: os dados se tornam um ativo negociável com propriedade clara. Desenvolvedores podem monetizar modelos diretamente na blockchain. Instituições obtêm uma camada de implantação de IA em conformidade e escalável. Pontes de liquidez entre cadeias fragmentam ecossistemas. Isso é mais do que um token. É um portal para a economia de IA multi-chain. Se isso acontecer, $OPEN pode se tornar um projeto de destaque no setor de IA + Web3, semelhante a como o Ocean Protocol e o Bittensor definiram seus nichos. A narrativa subjacente é forte: Outros constroem as ferramentas — a OpenLedger constrói a economia. E é apoiada pela Polychain Capital, o que ao menos me diz que investidores sérios estão prestando atenção.
Não tenho uma resposta clara. O Bittensor tem efeito de rede e uma camada de treinamento forte. A Fetch.ai está impulsionando os agentes fortemente. A Render domina o nicho de computação de GPU. A OpenLedger está apostando em atribuição + liquidez como a camada que falta.
A pergunta continua voltando... qual camada é mais fundamental a longo prazo? Poder computacional bruto? Treinamento coletivo? Agentes autônomos? Ou a camada econômica que torna dados, modelos e agentes líquidos e atribuíveis?
Estou inclinando-me para a ideia de que, se a economia de IA realmente escalar, a camada econômica/atribuição se torna tão crítica quanto o próprio poder computacional. Talvez até mais. Porque as ferramentas se tornam commodities. Mas a economia ao redor delas? É aí que o valor se estabelece.
Mas ainda não sei se a OpenLedger será a que vai possuir essa camada... ou se alguém vai superá-los na execução. Tudo que eu sei é: os projetos que se concentram apenas em ferramentas, e não na economia ao redor delas, podem acabar como infraestrutura comoditizada. Aqueles que resolvem propriedade, atribuição e liquidez... esses podem ser os verdadeiros vencedores.
Ainda estou pensando sobre isso. Estou ainda observando. E, honestamente, é onde me sinto mais confortável—curioso, cético, mas me inclinando.
#bitcoin #crypto #Binance #CryptoExchangeNews $BTC