

Alguns anos atrás, eu supunha que o recurso mais importante em IA era a computação.
Quem tiver o maior poder de processamento vai ganhar. Essa suposição parecia óbvia na época. Ultimamente, porém, tenho prestado atenção em algo muito menos emocionante. Não é inteligência. Nem mesmo precisão.
Ou mais especificamente, o que acontece quando a memória das máquinas começa a se comportar de forma diferente da memória humana.
Os humanos esquecem as coisas o tempo todo. Esquecemos conversas, detalhes, nomes, erros. Às vezes, esquecer é saudável. Sistemas legais inteiros são construídos para limitar quanto tempo certas informações seguem as pessoas. Mas quando uma economia esquece informações importantes, as consequências podem ser surpreendentemente caras.
Essa distinção fica martelando em mim quando observo a infraestrutura de IA.
A maioria das pessoas ainda fala sobre IA como se o problema central fosse gerar respostas melhores. Mas, quanto mais observo as empresas experimentando IA, menos convencido eu fico de que melhores respostas sejam o verdadeiro gargalo. Em muitos casos, o problema aparece depois que a resposta é gerada.
De onde veio essa informação?
Quem contribuiu com isso?
Alguém consegue verificar isso?
E talvez o mais importante: se algo der errado seis meses depois, alguém consegue reconstruir o que aconteceu?
Essas perguntas soam entediantes até que dinheiro entre em cena.
Muitos projetos de IA competem na corrida pela inteligência. Modelos mais rápidos. Melhor raciocínio. Treinamento mais eficiente. @OpenLedger seems to be looking somewhere else. Quase por baixo da própria IA.
Do jeito que eu interpreto, o projeto está fazendo uma pergunta estranha: e se o recurso escasso não for inteligência, mas conhecimento rastreável?
No começo, pensei que isso soava como um exercício de branding em torno de propriedade de dados. Quanto mais eu pensei sobre isso, menos confortável eu me sentia com essa explicação.
Porque, uma vez que sistemas de IA começam a interagir entre si, a cadeia de conhecimento fica bagunçada muito rapidamente. Imagine dez sistemas de IA contribuindo para uma única saída. Um fornece pesquisa. Outro fornece dados de mercado. Outro contribui com registros históricos. Outros adicionam mecanismos de análise, filtragem ou ranqueamento. Eventualmente, uma resposta aparece. Todo mundo vê a resposta. Quase ninguém vê o caminho. Esse caminho oculto pode acabar importando mais do que a saída final.
Lembro de ter lido sobre uma instituição financeira testando fluxos de trabalho assistidos por IA. O que me interessou não foi se o modelo produzia resultados úteis. Foi a discussão sobre conformidade que veio depois. A organização não estava perguntando se a IA era inteligente. Estavam perguntando se poderiam explicar o processo de tomada de decisão para reguladores, caso fosse necessário. Isso parece uma categoria de problema diferente, por completo.
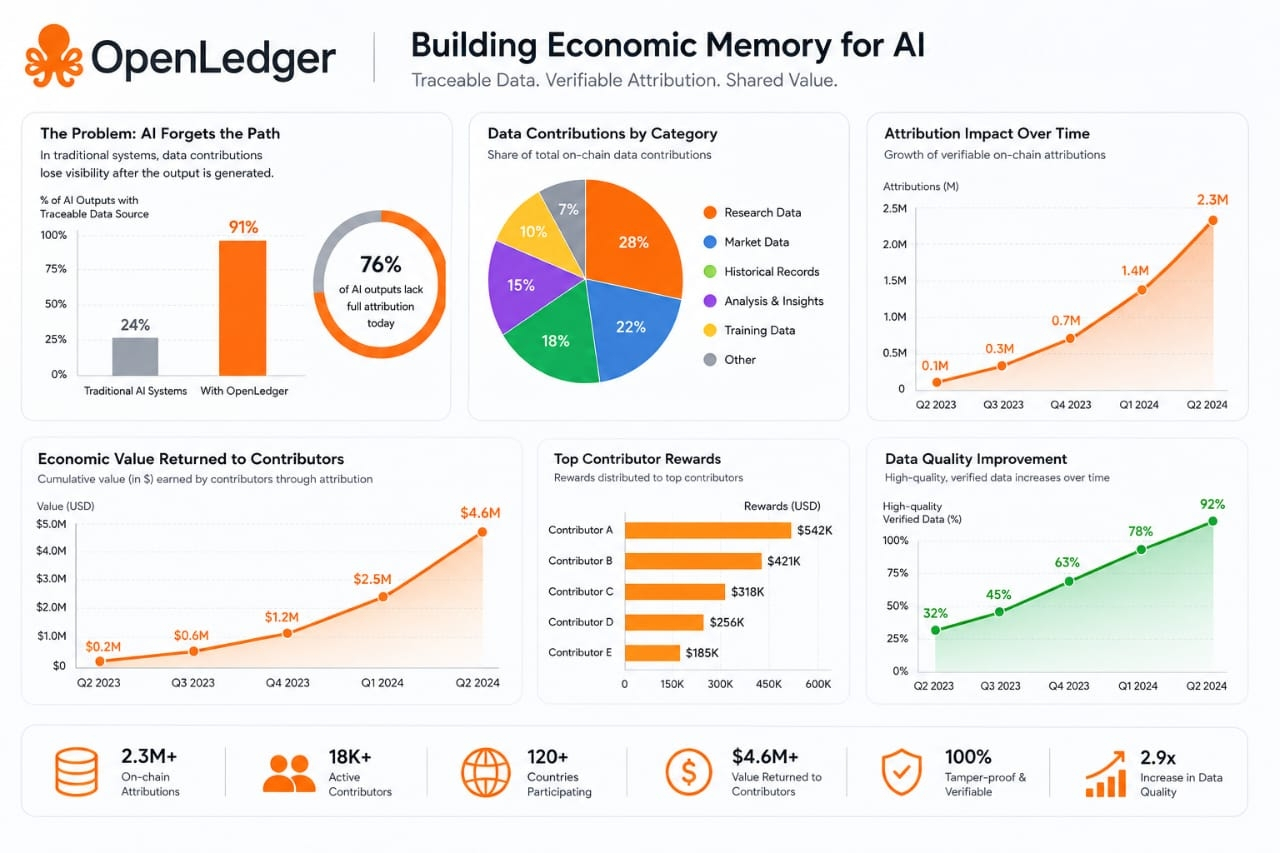
Uma economia tolera inteligência imperfeita por um tempo surpreendentemente longo. O que ela tem dificuldade em tolerar é a responsabilidade invisível.
É em parte por isso que o OpenLedger chamou minha atenção.
Nas cadeias de suprimento, registros de procedência importam porque as empresas precisam saber de onde os produtos se originaram. Na saúde, a documentação existe porque a memória não pode ser confiável por si só. Ainda assim, grande parte da IA opera como se a atribuição fosse opcional. Isso me parece estranho. Estamos construindo sistemas que cada vez mais influenciam decisões econômicas, enquanto tratamos a linhagem da informação como uma infraestrutura secundária. Talvez isso funcione enquanto a IA permanecer uma ferramenta de produtividade. Fico menos certo se a IA se tornar, ela própria, participante da atividade econômica.
A tese do OpenLedger começa a parecer mais interessante por essa perspectiva.
Se as contribuições de dados permanecerem rastreáveis, o conhecimento não simplesmente entra em um modelo e desaparece. Contribuintes podem, potencialmente, permanecer conectados à criação de valor a jusante. Mais importante: as cadeias de decisão se tornam observáveis. Proof of Attribution — a atribuição como prova — registra cada contribuição de dados como uma mudança permanente, verificável, no blockchain. Não em um banco de dados privado de uma empresa. Não em um log que possa ser revisado silenciosamente. Em um ledger em que o registro depende de matemática, não de boa vontade institucional.
O problema maior pode ser a memória econômica.
Quando um sistema perde o controle de onde o conhecimento se originou, ele gradualmente perde a capacidade de distinguir sinal de ruído. Contribuintes de alta qualidade ficam mais difíceis de identificar. Informação ruim e informação boa passam a competir em condições semelhantes. Por fim, os incentivos começam a se deslocar. Esse processo é lento. Quase invisível. Então, de repente, todo mundo percebe a queda da qualidade.
Já vi padrões semelhantes fora da IA. Mercados financeiros muitas vezes passam anos otimizando eficiência antes de perceber que, sem querer, removeram a transparência. Plataformas sociais otimizam engajamento antes de perceber que enfraqueceram a credibilidade. Sistemas raramente quebram de uma vez. Eles vão se desviando. A infraestrutura de IA pode enfrentar algo parecido.
Ainda assim, eu não acho que o caminho do OpenLedger seja simples. Existe aqui um trade-off que ninguém realmente discute. Todo mundo defende responsabilidade em teoria. O apoio fica bem mais fino quando a responsabilidade cria custos operacionais. Por isso, não vejo o OpenLedger como um vencedor garantido. O que acho interessante é a direção da aposta em si.
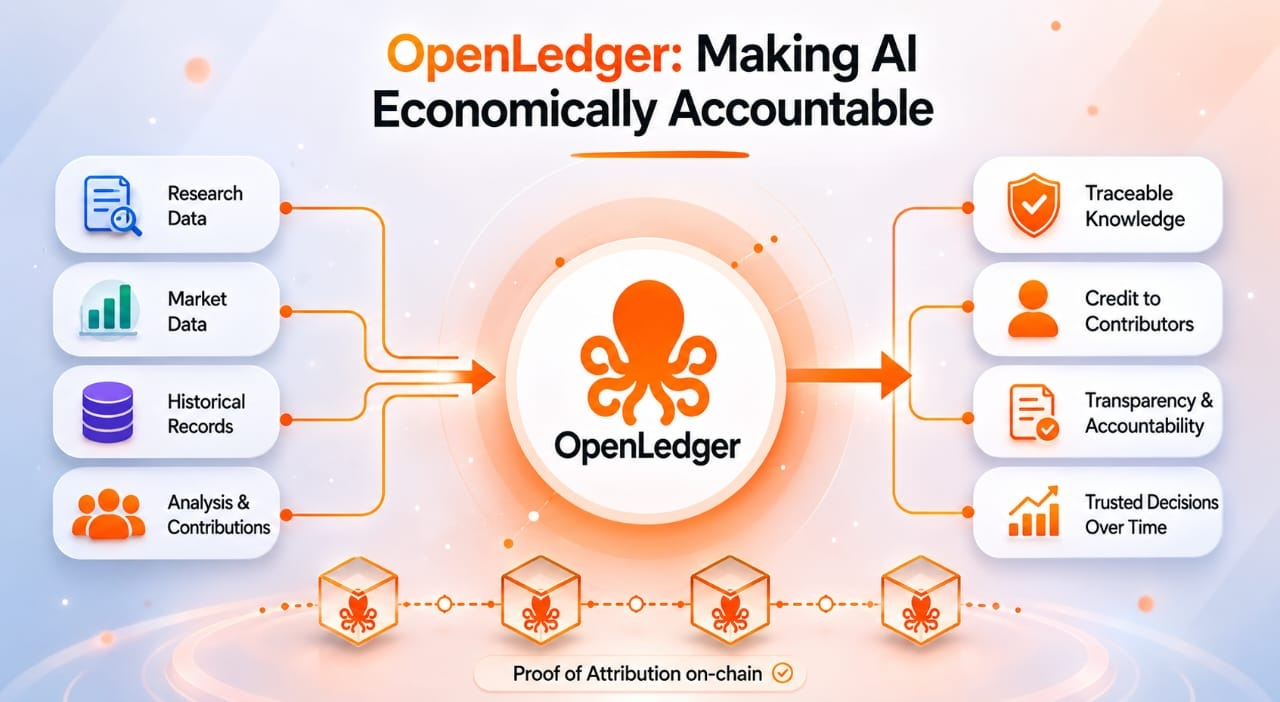
A indústria está obcecada em tornar a IA mais inteligente. O OpenLedger parece estar mais interessado em tornar a IA economicamente responsável. Esses objetivos não são os mesmos. E continuo me perguntando se o mercado está focando na escassez errada.
A computação fica mais barata com o tempo. Os modelos melhoram. Os custos de inferência caem. Mas registros confiáveis têm uma tendência estranha a se tornarem mais valiosos conforme os sistemas ficam mais complexos.
Talvez o esquecimento da IA pareça hoje um inconveniente técnico. Um problema de produto. Algo que engenheiros eventualmente resolvem. Ou talvez o esquecimento se torne a fonte oculta do risco que ninguém percebe até que mercados inteiros baseados em IA dependam de lembrar quem contribuiu, o quê, quando e por quê.
Essa é a aposta que o OpenLedger está fazendo.
Acho isso mais interessante do que a maioria das apostas que estão sendo feitas
