
No final da tarde, enquanto organizava alguns logs de projetos antigos no computador, parei para folhear algumas páginas dos meus registros de depuração de contratos inteligentes que escrevi à mão. Nele, estava cheio de curvas de consumo de gas em diversos casos extremos e ideias de como resolver falhas de sincronização de estado, e não consegui evitar um sorriso. Ao longo dos anos, coloquei muitas experiências práticas e dados em várias ferramentas para validar minhas ideias, e percebi que as verdadeiras experiências de base que têm valor são frequentemente facilmente colhidas em plataformas centralizadas, enquanto os contribuidores têm dificuldade em receber recompensas justas por isso. Essa sensação me deixou naturalmente mais cauteloso em relação a projetos que afirmam querer reestruturar o valor dos dados.
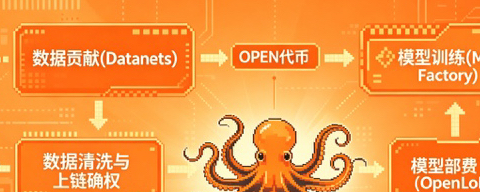
Com essa mentalidade, a Cardano recentemente começou a focar no projeto OpenLedger, que está ganhando atenção na comunidade. No início, não tinha grandes expectativas, pois já vi muitas soluções que ostentam o rótulo de AI, mas que apenas arranham a superfície. Mas depois de gastar alguns dias lendo atentamente ... o código do protocolo central deles, especialmente o módulo de rede de dados descentralizada chamado Datanets, percebi que eles estão realmente tentando seguir um caminho mais pragmático, utilizando a blockchain para garantir que o fluxo de valor no processo de inferência de AI seja verdadeiramente liquidado de forma verificável na cadeia.
A mecânica de AI pagável que eles propuseram tem como núcleo um design de contratos modulares e identificadores criptográficos, permitindo que cada chamada de modelo, contribuição de dados ou fornecimento de poder computacional seja claramente rastreável e receba a devida compensação. Imagine só, um desenvolvedor faz upload de seu módulo de extração de características treinado e, se uma equipe de quant utilizar esse módulo para ajudar na análise de mercado, o protocolo subjacente irá automaticamente dividir os custos e direcioná-los para os endereços relevantes, com base no peso de contribuição previamente definido. Essa abordagem é limpa em conceito, tentando descentralizar a distribuição que antes era monopolizada por grandes plataformas, dando a voz aos verdadeiros contribuidores.
Do ponto de vista de um engenheiro, ... o que mais admiro nessa arquitetura é seu conceito de modularidade. O Datanets organiza as camadas de dados, modelo e liquidação de forma relativamente independente, facilitando iterações futuras e upgrades locais, sem que um único erro em uma parte cause a falência do sistema inteiro. Eu mesmo segui a documentação e executei algumas chamadas de ponta a ponta na rede de testes; a barreira de entrada não é baixa, mas a lógica é clara. Para quem tem experiência em Solidity e sistemas distribuídos, em um ou dois dias é possível montar as interações básicas, e uma vez em funcionamento, a latência e as taxas se mostraram mais estáveis do que eu esperava. Claro, isso foi apenas um teste em pequena escala; o desempenho em cenários de alta concorrência real ainda precisa de mais tempo de observação.
Mas eu sei que qualquer tentativa assim esbarra em desafios reais de engenharia. A mecânica que depende fortemente de liquidações em tempo real na blockchain, ao lidar com tarefas de AI multimodais e de alta concorrência, enfrenta rapidamente problemas de latência de rede e pressão de sincronização de nós. Eu já passei por isso em outras blockchains em períodos de alta carga, onde atrasos de confirmação e flutuações repentinas de taxas bagunçaram muitos processos automatizados que eu havia projetado. Se a Datanets não conseguir iterar continuamente em expansão de nós e otimização de sharding, esse risco pode fazer com que alguns usuários sintam que os serviços centralizados tradicionais são mais confiáveis.
Além disso, atualmente, os tipos de dados que circulam na rede deles ainda são bastante concentrados, focando principalmente em registros estruturados relacionados a finanças e alguns conjuntos de treinamento públicos. Isso, sem dúvida, torna a validação inicial mais focada, mas também significa que ainda há uma distância significativa até que possam suportar aplicações de AI verdadeiramente diversificadas e intersetoriais. Se o ecossistema de desenvolvedores não conseguir se enriquecer rapidamente, injetando constantemente novos dados de alta qualidade, todo o ciclo de distribuição de valor pode facilmente cair em um ciclo de baixa atividade, tornando-se uma auto-suficiência de poucos nós.
Apesar desses problemas potenciais, mantenho um reconhecimento cauteloso nessa direção. Retornar o poder de precificação da oferta de AI das mãos de poucos gigantes e usar a tecnologia blockchain para reduzir a barreira para que desenvolvedores comuns monetizem seus recursos únicos é algo que merece uma tentativa séria. Pelo menos, isso oferece um novo caminho para quem possui conjuntos de dados nichados ou modelos otimizados.
Nos próximos meses, pretendo continuar a observar como um espectador as atividades reais na rede deles: o volume real de chamadas de contratos inteligentes, a curva de crescimento de endereços de upload de dados independentes na rede Datanets, e a estabilidade na liquidação entre módulos. Esses dados serão mais honestos do que qualquer white paper. Quando o período de observação terminar, decidirei se investirei mais energia com base no desempenho real. Em geral, mantenho um otimismo contido em relação a esse tipo de exploração que traz a sinceridade técnica para a camada de código - não porque soa revolucionário, mas porque não ignora a complexidade do mundo real nos detalhes da engenharia.