

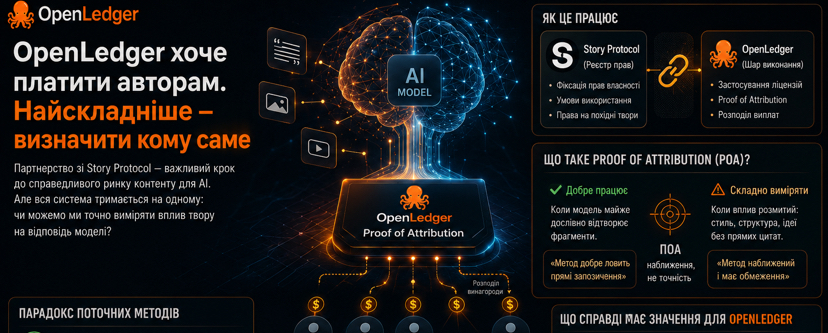

Ultimamente me pego tendo uma sensação estranha a cada vez que ouço a frase “A IA vai pagar aos autores”. Ela soa certa. Quase impossível ser contra. Mas quanto mais penso nisso — mais me deparo com uma pergunta simples: pagar pelo simples fato de sua obra estar presente em um conjunto de dados ou pagar pelo impacto real que ela tem na resposta do modelo?
E isso, a meu ver, são duas economias completamente diferentes.
Foi justamente nisso que pensei quando comecei a analisar a parceria da @@OpenLedger com a Story Protocol. A ideia é bonita: o conteúdo tem um proprietário, a IA recebe o direito de usá-lo e o autor é remunerado. A Story Protocol registra os direitos, e a OpenLedger cuida da atribuição e da distribuição dos pagamentos.
Mas tudo isso se apoia em um único fundamento — a Prova de Atribuição.
O problema é que a atribuição para grandes modelos de IA ainda não é precisa. O sistema identifica bem as correspondências diretas: quando o modelo reproduz um texto quase palavra por palavra. Mas entende muito pior a influência “difusa” — o estilo, a estrutura das ideias, a abordagem geral que o modelo assimilou sem copiar diretamente.
E aí surge algo interessante. É mais fácil pagar pelo que é mais simples de comprovar — uma citação ou uma cópia quase literal. E é mais difícil pagar pelo tipo de influência que aparece constantemente no treinamento real de IA.
Por isso, eu veria essa parceria não como uma “solução para o problema dos direitos autorais na IA”, mas antes como uma tentativa de construir um sistema para a parte da influência que somos capazes de medir hoje.
E aqui tenho curiosidade em saber a sua opinião. Se o seu conteúdo fosse usado para treinar uma IA, o que seria mais importante para você: uma atribuição o mais precisa possível ou o simples fato de que o sistema pelo menos tenta pagar os autores?
