tenho analisado a arquitetura do openledger ultimamente, principalmente em torno do sistema de atribuição e incentivos para contribuintes
a maioria das pessoas pensa que o openledger é apenas mais um token de IA + cripto, mas honestamente, a parte mais interessante é a tentativa de construir uma infraestrutura de coordenação em torno dos dados de IA
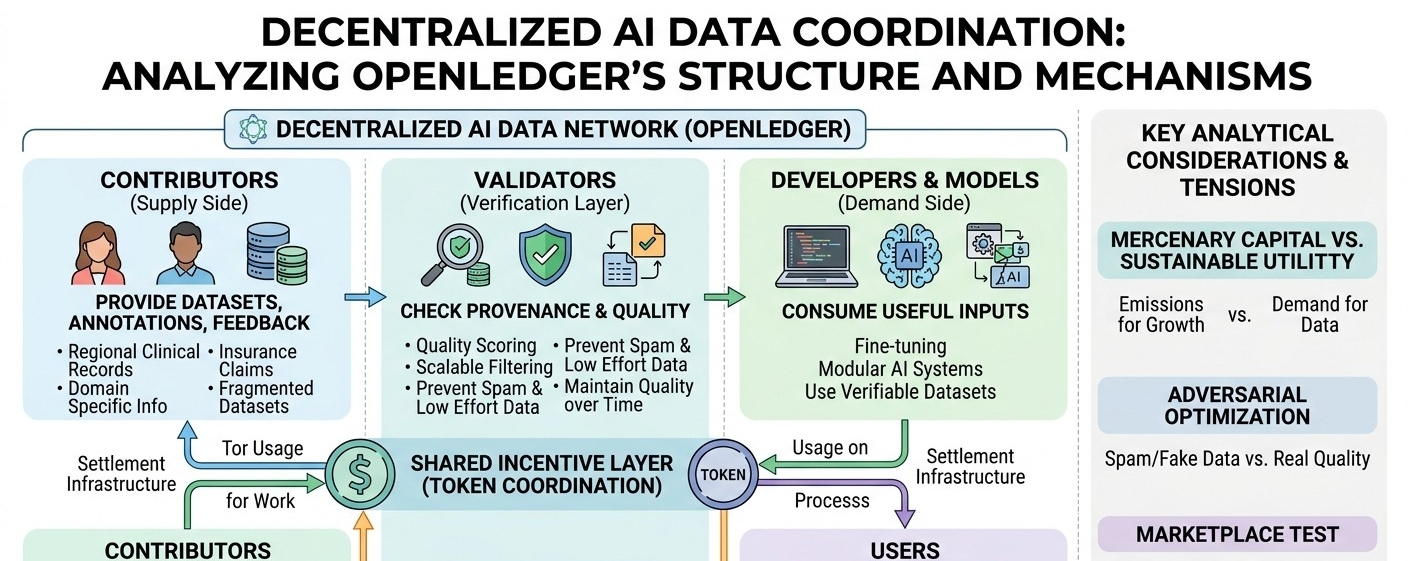
o que me chamou a atenção é como a rede tenta conectar contribuidores, validadores, desenvolvedores e usuários através de uma camada de incentivos compartilhados
contribuidores fornecem conjuntos de dados, anotações, ciclos de feedback ou informações específicas de domínio
validadores verificam a proveniência e qualidade
desenvolvedores consomem entradas úteis para modelos
usuários geram demanda através de aplicações ou inferência
em teoria, o token coordena valor entre todos eles
o sistema de contribuição descentralizado realmente faz sentido em certas áreas
um modelo de saúde treinado em registros clínicos regionais ou anotações de sinistros de seguros provavelmente precisa de conjuntos de dados fragmentados que sistemas centralizados nem sempre priorizam coletar
a openledger parece projetada em torno dessa suposição
que futuros sistemas de IA se tornem mais modulares e coordenados externamente em vez de totalmente integrados verticalmente
então há a camada de atribuição que honestamente parece a parte mais difícil de toda a arquitetura
se os contribuintes são recompensados com base na utilidade a jusante, como o protocolo sabe quais dados realmente importaram
e essa é a parte em que eu continuo pensando
modelos de IA absorvem padrões de entradas mistas
um pequeno conjunto de dados de alta qualidade pode importar mais do que milhões de exemplos genéricos
então a atribuição se torna probabilística muito rapidamente
talvez isso seja aceitável
os contribuintes provavelmente não precisam de precisão perfeita
eles só precisam de um sistema que pareça justo o suficiente e difícil de manipular
mas uma vez que as recompensas em token se tornam significativas, as pessoas otimizam em torno de quaisquer métricas que o protocolo mede
é aí que a tensão do incentivo aparece
se as emissões dominarem antes que a demanda real exista, os contribuintes podem fazer upload de conjuntos de dados duplicados, preenchimentos sintéticos, anotações de baixo esforço ou interações de spam simplesmente porque o sistema de recompensas permite
portanto, a camada de verificação importa tanto quanto a camada de contribuição em si
a openledger precisa de rastreamento de proveniência, pontuação de qualidade e filtragem escalável sem deslizar para moderação centralizada
filtros de menos e a rede se torna barulhenta
filtros demais e a premissa descentralizada enfraquece
o lado do mercado provavelmente é o verdadeiro teste a longo prazo
idealmente, os desenvolvedores pagam por conjuntos de dados verificados ou acesso a modelos, usuários geram demanda de inferência e contribuintes ganham com o uso real da rede em vez de apenas com emissões
nesta versão, o token se torna uma infraestrutura de liquidação em vez de apenas combustível de incentivo
mas toda a arquitetura depende da demanda futura de IA se tornar fragmentada o suficiente para precisar desse tipo de camada de coordenação
se grandes plataformas continuarem controlando treinamento, implantação e feedback do usuário internamente, os mercados de dados de IA descentralizados podem continuar relativamente de nicho
observando
taxas de uso reais versus emissões
qualidade dos conjuntos de dados contribuídos ao longo do tempo
demanda de desenvolvedores por dados externos atribuíveis
como disputas de atribuição escalam com a participação
ainda não há uma conclusão clara
a openledger pode estar construindo uma camada de coordenação sustentável para sistemas de IA distribuídos
ou pode estar testando se incentivos em tokens podem criar um mercado antes que o lado da demanda exista completamente