

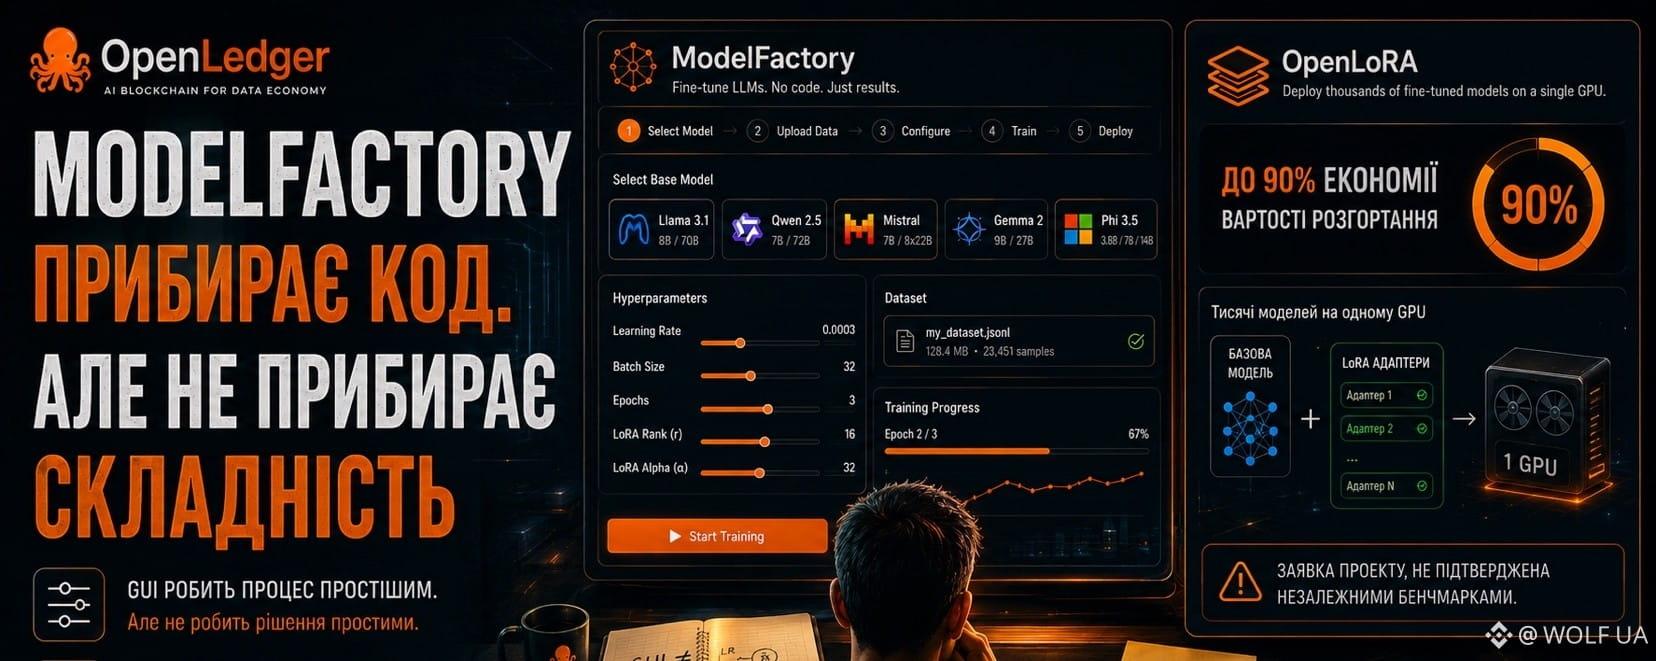

Hoje fiquei pensando no que fazer e decidi explorar o ModelFactory da @OpenLedger . Não por causa das descrições atraentes, mas por uma pergunta simples: onde termina o «acessível a todos» e começa a complexidade real?
A ideia, por si só, é muito boa. Em vez de escrever código, executar scripts em Python e lidar com ferramentas de ML, o utilizador tem uma interface gráfica. Escolhe um modelo, carrega os seus dados, configura os parâmetros e carrega em iniciar.
Para alguém que nunca trabalhou com fine-tuning, isso pode realmente eliminar uma enorme barreira de entrada.
Mas, enquanto lia a documentação, me peguei pensando em uma coisa: a interface elimina o código, mas não elimina as decisões.
Os controles deslizantes para learning rate, batch size ou epochs parecem simples. O problema é que eles não explicam quais valores fazem sentido para a sua tarefa. Se você configurar tudo ao acaso, o modelo pode quase não aprender nada ou, pelo contrário, começar a funcionar pior.
Tive a mesma impressão com o OpenLoRA. O conceito em si parece tecnicamente sólido: os adaptadores LoRA leves realmente permitem usar a GPU com mais eficiência. Mas, quando aparecem números como “até 90% de economia”, dá vontade de ver medições independentes, não uma apresentação.
Por enquanto, a situação me parece assim: já existe uma boa ideia de engenharia. A questão agora não é se funciona, mas até que ponto funciona fora de demonstrações e protótipos.
Aliás, gostaria de ouvir quem realmente já fez fine-tuning: em que momento a interface gráfica deixa de ser suficiente e você sente vontade de voltar a ter controle total pelo código?
