
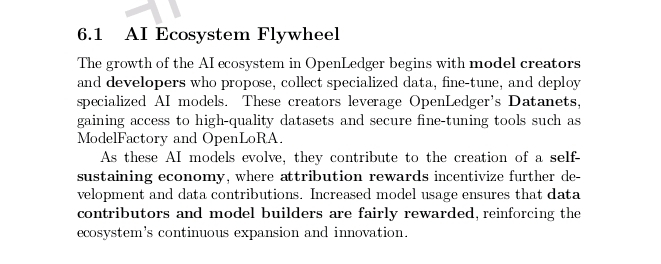

Irmãos, escutem o que eu vou dizer. Na semana passada, fiz uma besteira. A situação é a seguinte: eu solicitei a qualificação para ser um nó de validação da OpenLedger. Não é aquele grande nó, mas sim um que pequenos investidores podem participar. Sou responsável por checar a qualidade da saída do modelo. A cada rodada de inferência que o modelo faz, o sistema sorteia aleatoriamente alguns resultados e pede para os validadores darem notas. Se você concordar com a maioria, ganha um prêmio; se você estiver muito fora da curva, perde a sua .
Eu pensei: o que tem de difícil nisso? Só de olhar já dá pra saber se o modelo é bom ou não. Então, fiz um stake de uma grana e comecei a receber as tarefas, todo feliz.
A primeira tarefa era sobre a geração de comentários de código. A saída do modelo estava razoável, então dei uma nota de aprovação. Depois de enviar, percebi que a média das notas dos outros estava um pouco mais alta que a minha. Meu coração deu um aperto, mas não liguei muito. Veio a segunda tarefa, que perguntava: 'como saber se um endereço é um contrato inteligente'. A resposta gerada pelo modelo dizia que era só olhar o saldo! Isso estava claramente errado. Não pensei duas vezes e dei nota zero, além de escrever um comentário dizendo que essa resposta poderia enganar as pessoas.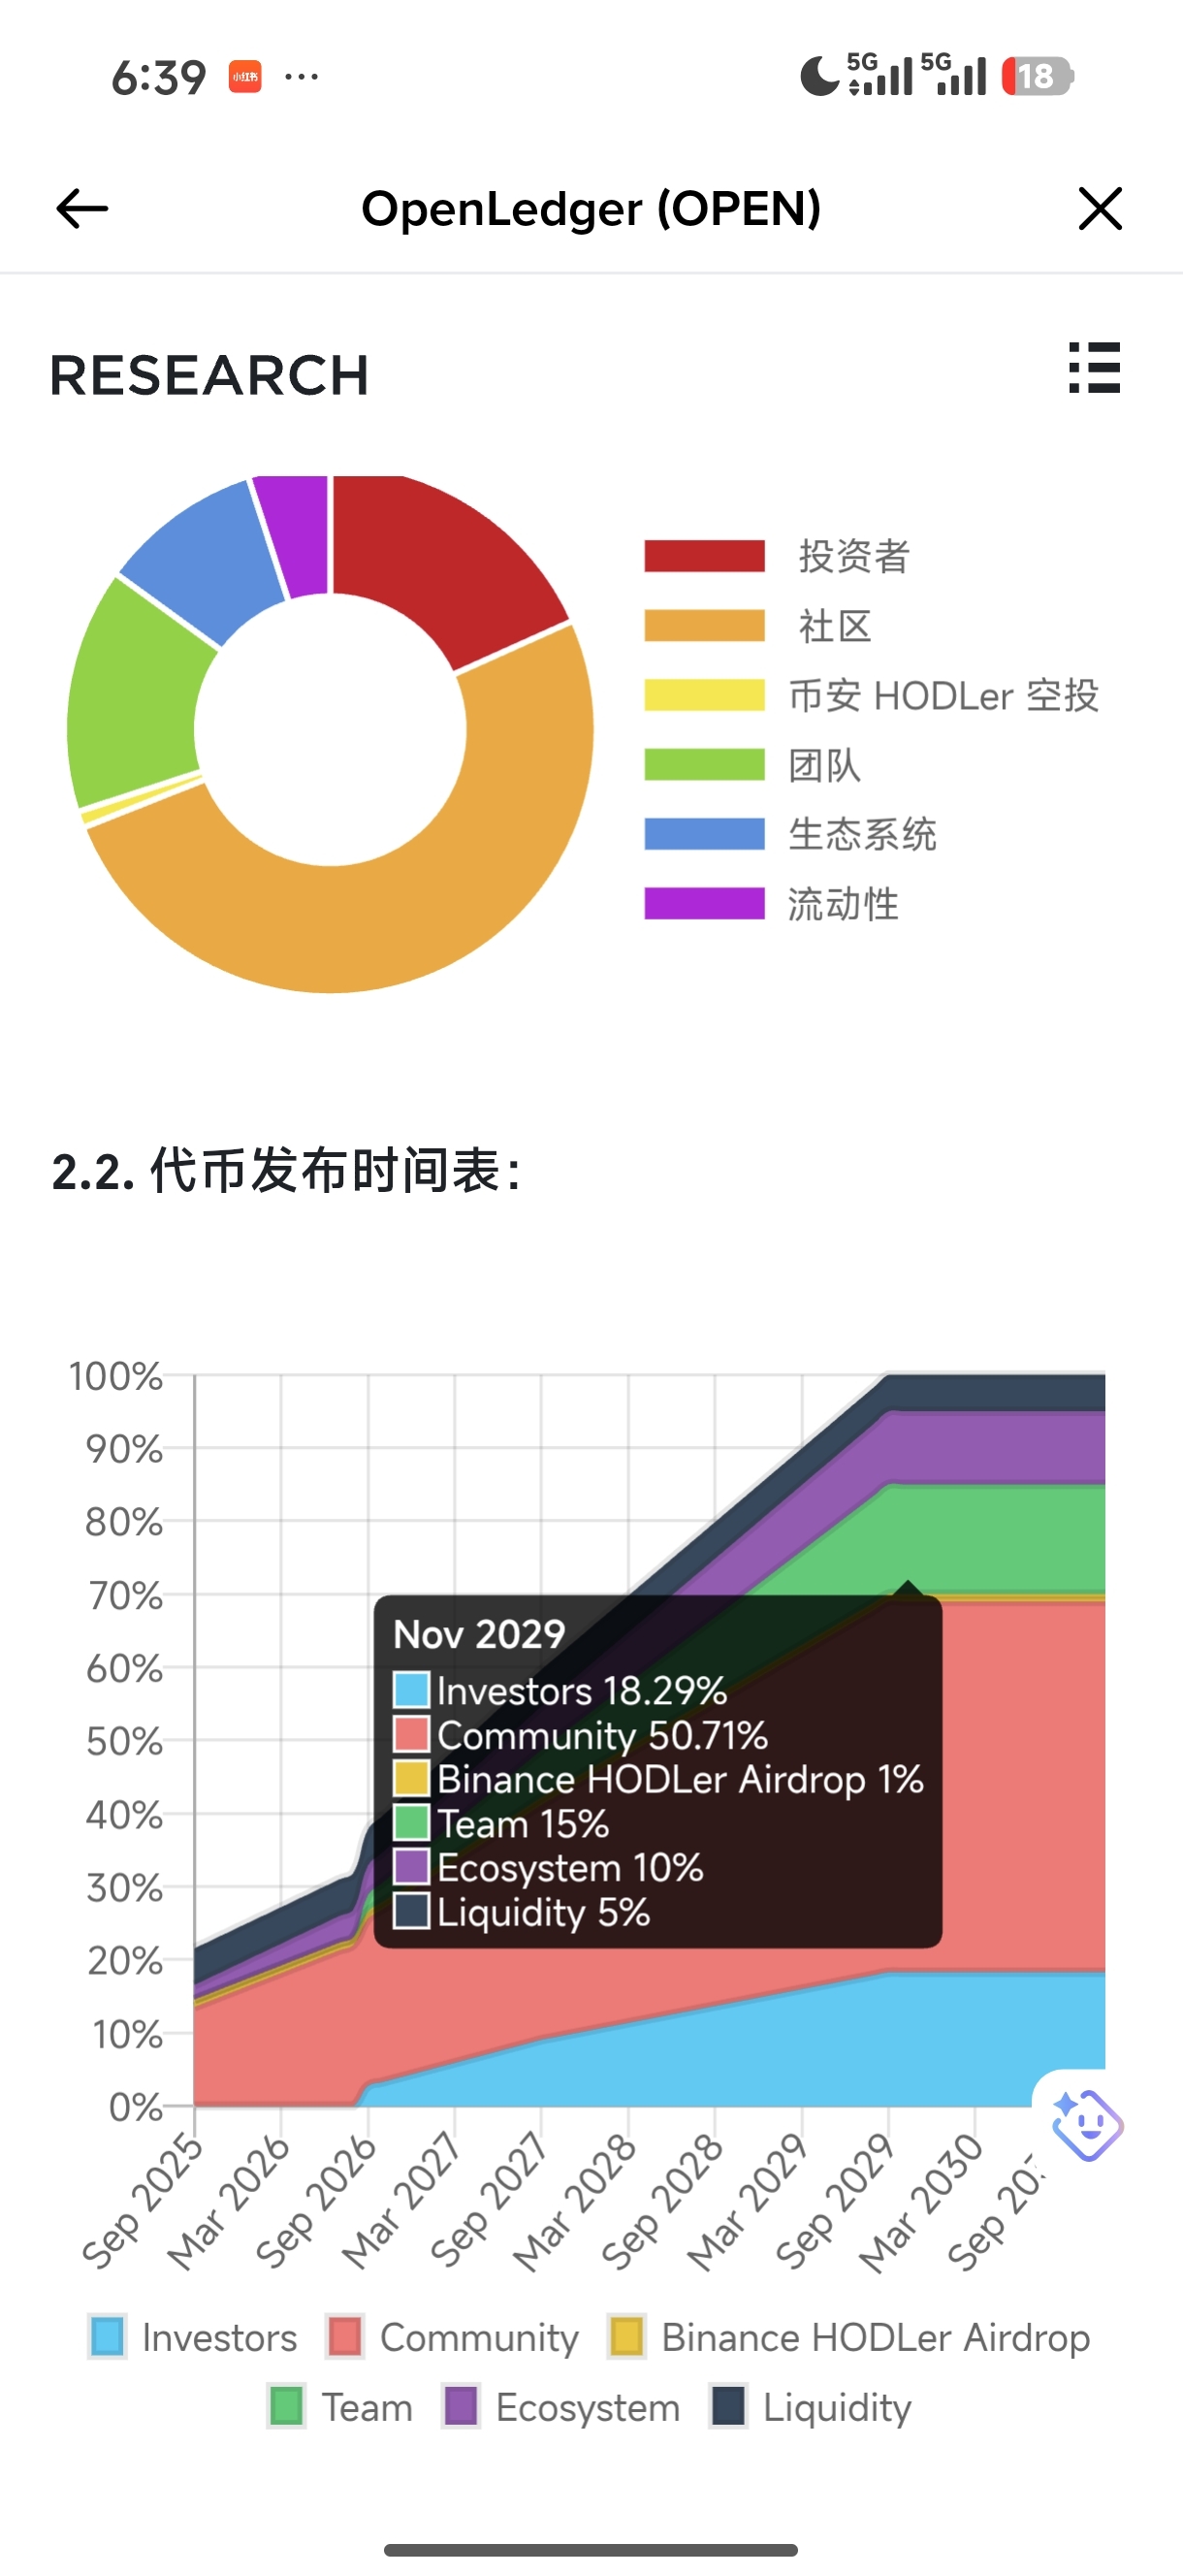
No dia seguinte, quando abri o painel, vi que haviam descontado de mim o valor de uma baita “fritada” de churrasco. Na hora eu fiquei em choque.
Só depois de ler com cuidado a explicação dos descontos é que entendi: no conjunto de dados de treinamento daquele modelo existe um tipo especial de padrão de interação on-chain. Nesse padrão, verificar o saldo realmente ajuda na avaliação. Mesmo que o modelo não deixe claro os pré-requisitos, o sistema entendeu que a resposta dele “é parcialmente válida em um contexto específico”, então não deveria receber zero.
Foi aí que eu entendi: ao ser um validador do OpenLedger, não é “chutar” com base no senso comum. Você precisa compreender os limites dos dados de treinamento do modelo: em quais conjuntos de dados ele foi ajustado (fine-tuned), em quais áreas ele é mais forte e quais são as limitações. Agora ficou claro. Eu não só não ganhei dinheiro—como ainda tive que pagar um churrasco a mais. Foi ainda mais doloroso do que quando, anos atrás, na minha primeira compra de Bitcoin, eu me enrolei e perdi. Quando o Bitcoin dá prejuízo, pelo menos dá pra se consolar com a volatilidade; aqui foi culpa da minha falta de profissionalismo.
Depois eu aprendi a ser mais esperto. Antes de aceitar uma tarefa, eu verifico as informações básicas desse modelo: qual é o alcance dos dados em que ele foi treinado e que tipo de problemas ele consegue lidar melhor. Em seguida, cruzo com os critérios de validação na documentação, uma linha por vez, para atribuir a pontuação. Foram dois dias assim. Aos poucos, os prêmios foram recuperando o que eu tinha sido penalizado.
Lições que aprendi e quero contar aos meus irmãos: Primeiro, não pense que você entende de tudo. Às vezes a saída do modelo parece certa, mas você não sabe por que ela é certa. Segundo, se você não tiver certeza, o sistema permite pular essa tarefa—sem desconto. Terceiro, observe bastante os comentários e o padrão de pontuação de avaliadores excelentes. Aprenda com a lógica de decisão deles.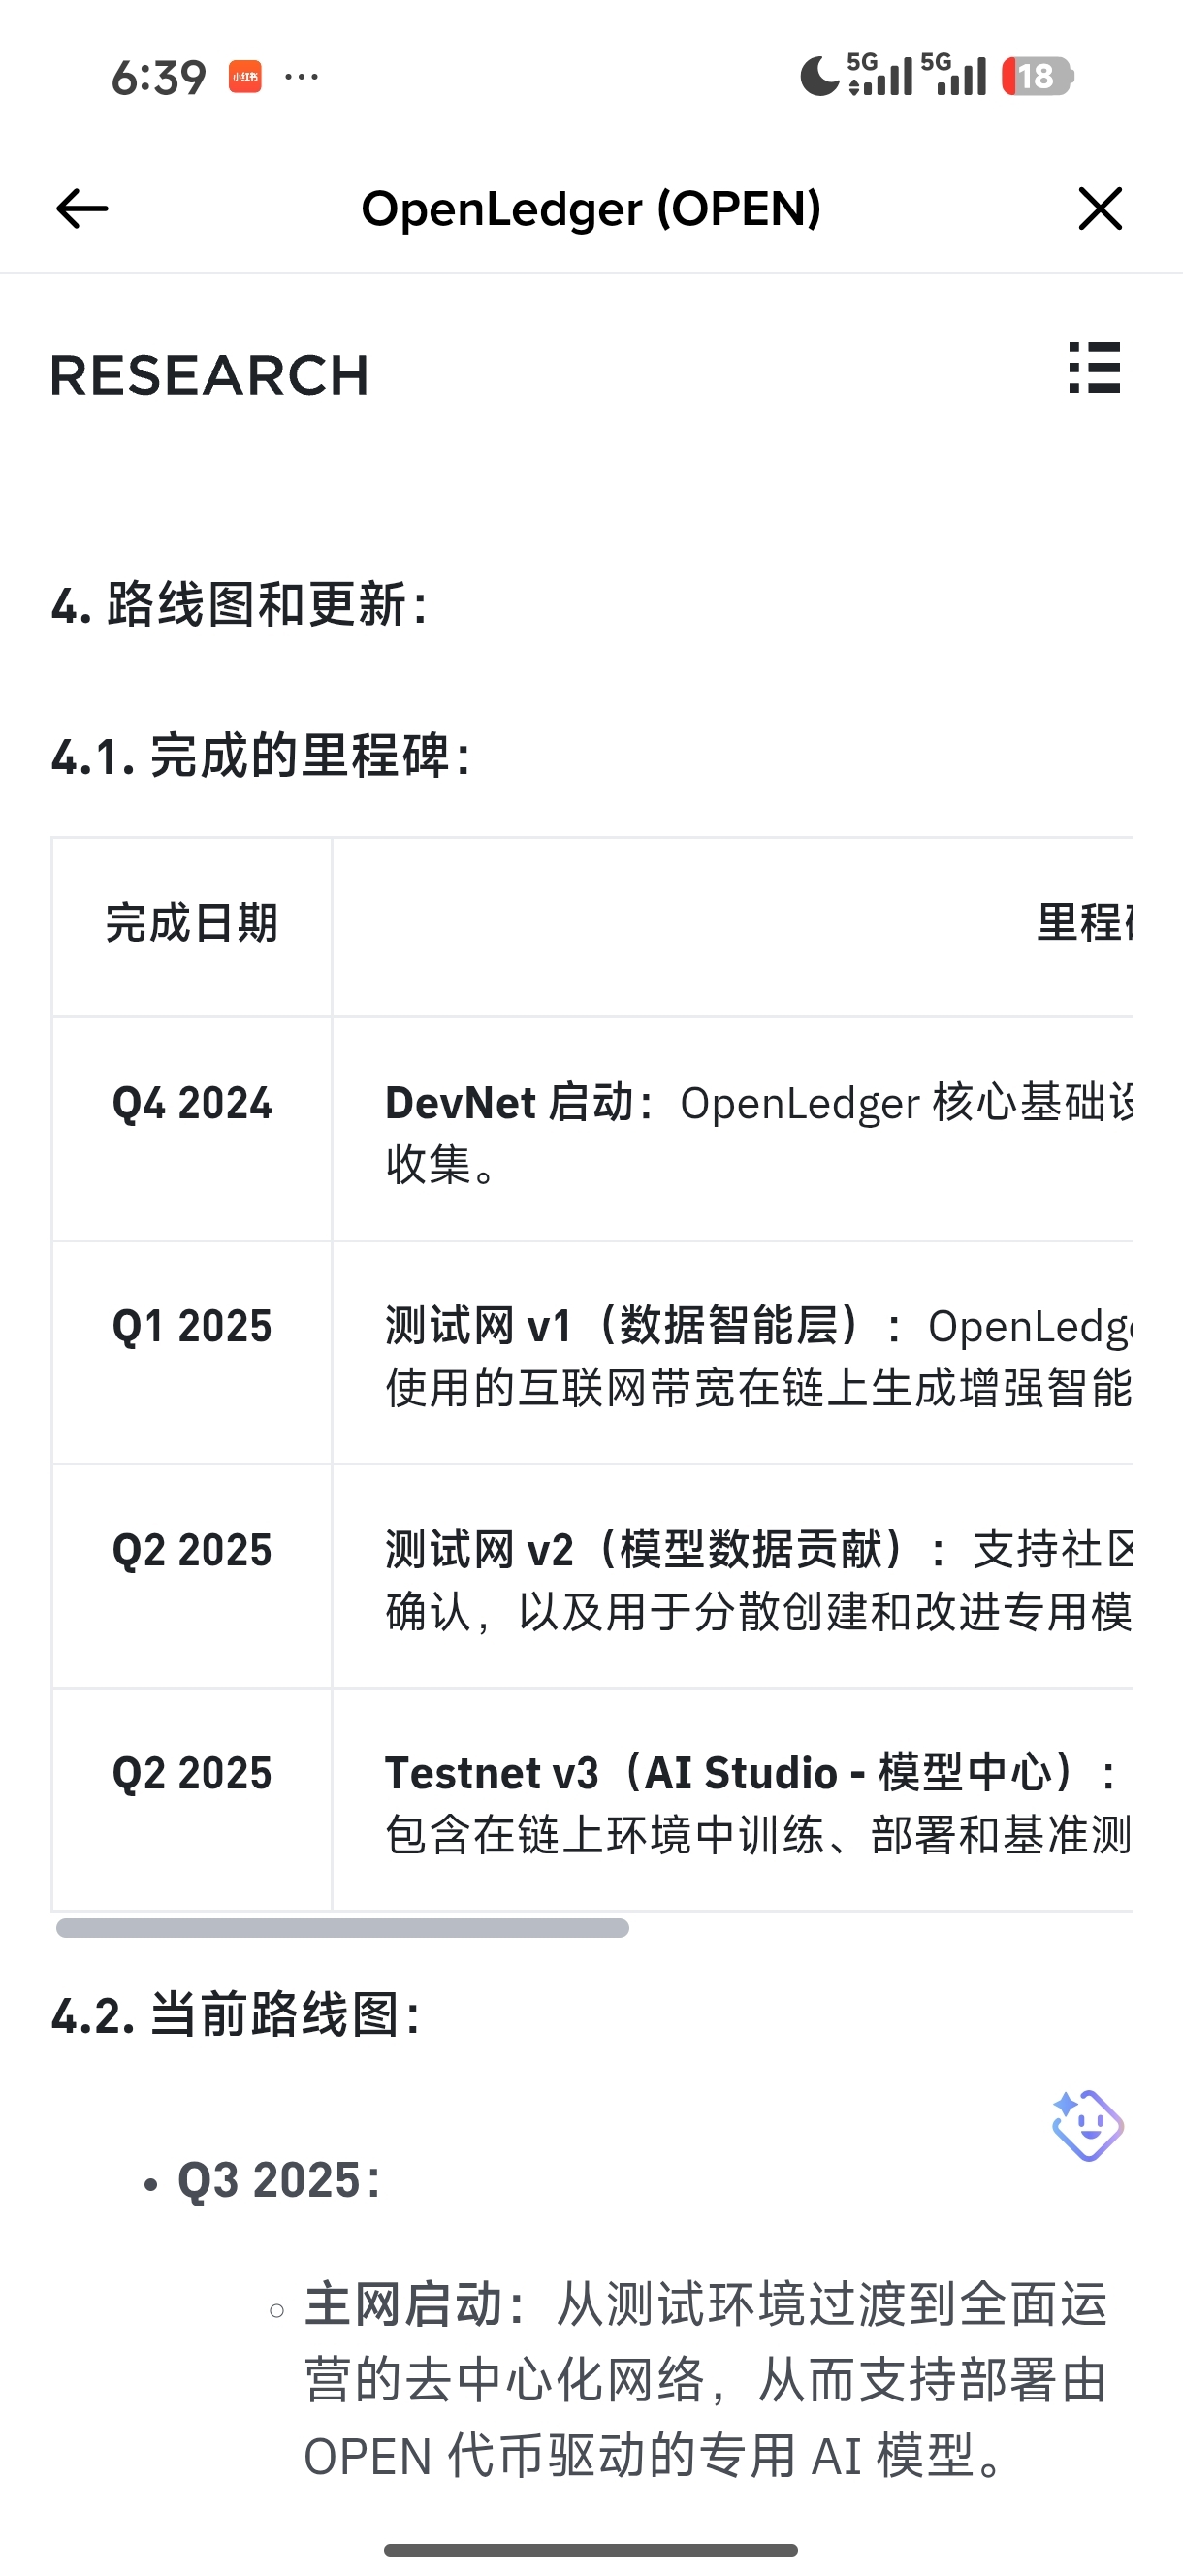
Em resumo, este mecanismo do OpenLedger entrega o controle de qualidade do modelo para a comunidade: quem é diligente, trabalha; quem é preguiçoso, foge. Na cadeia, tudo fica claro à primeira vista. Isso é diferente do consenso de pura força computacional do Bitcoin e do Ethereum. No Bitcoin, os mineradores calculam hashes; no Ethereum, a validação depende de staking e bloqueio de fundos. Mas no consenso do OpenLedger há mais uma dimensão: a capacidade de julgamento das pessoas. Minha estratégia agora é aceitar apenas tarefas de validação de áreas com as quais eu já estou familiarizado. Por exemplo, perguntas e respostas relacionadas a segurança de blockchains, ou validação de formato de dados. O resto eu simplesmente ignoro. Prefiro não ganhar nada a avaliar de forma aleatória.
Falando a verdade, quando fui penalizado eu fiquei bem frustrado. Mas agora, pensando bem, isso me fez pesquisar com seriedade a estrutura de validação do OpenLedger. Foi muito mais do que eu aprendi só lendo o whitepaper.
Próximo passo, vou organizar uma nota com orientações de como pontuar e validar, e publicar no fórum da comunidade. Espero ajudar os irmãos que estão começando e não querem cair nas mesmas armadilhas que eu#OpenLedger