Irmão, eu venho mexendo com modelos de IA há quase um ano. O que mais me estressa não é programar, mas sim conseguir dados limpos.
Mês passado, eu queria ajustar um modelo de revisão de contratos legais, focando em identificar cláusulas enganosas em contratos de aluguel. Eu passei três dias na internet catando um monte de amostras de contratos bagunçados. Alguns com formatos errados, outros com cláusulas que não faziam sentido. No final, não consegui usar nada.
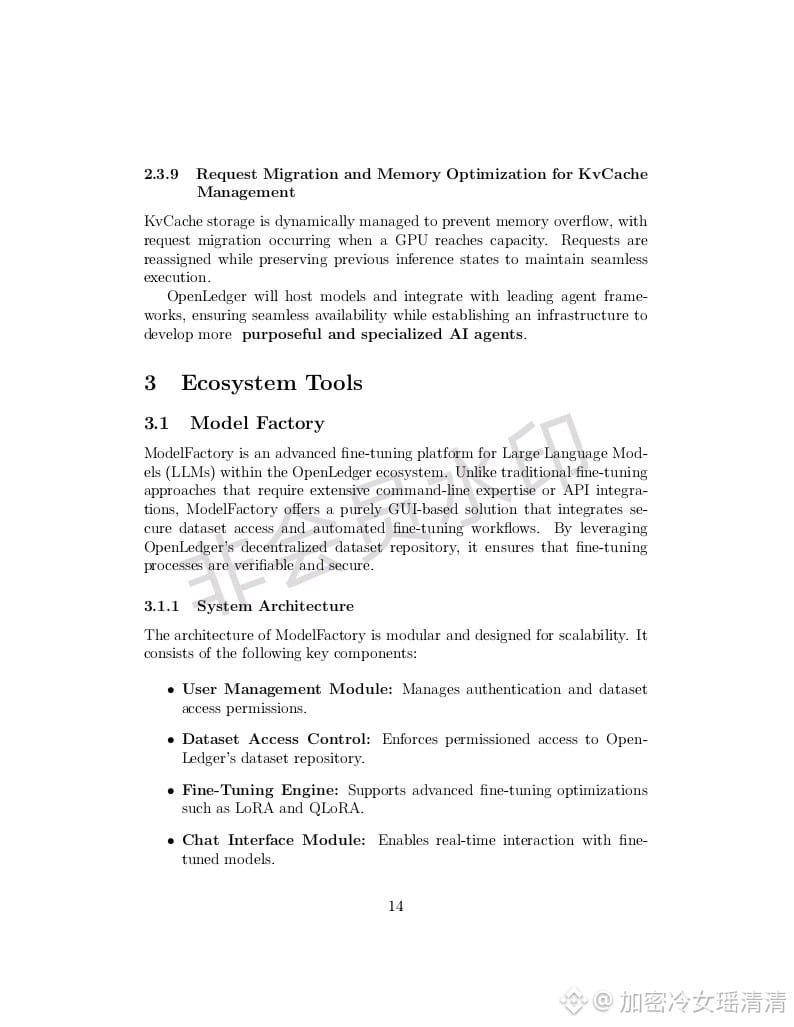
Depois, eu simplesmente selecionei um dataset de contratos pronto na ModelFactory do @OpenLedger . A equipe profissional limpou tudo, e cada cláusula tem etiquetas de tipo, tudo bem claro. Com alguns cliques, eu já consegui puxar pra treinar.
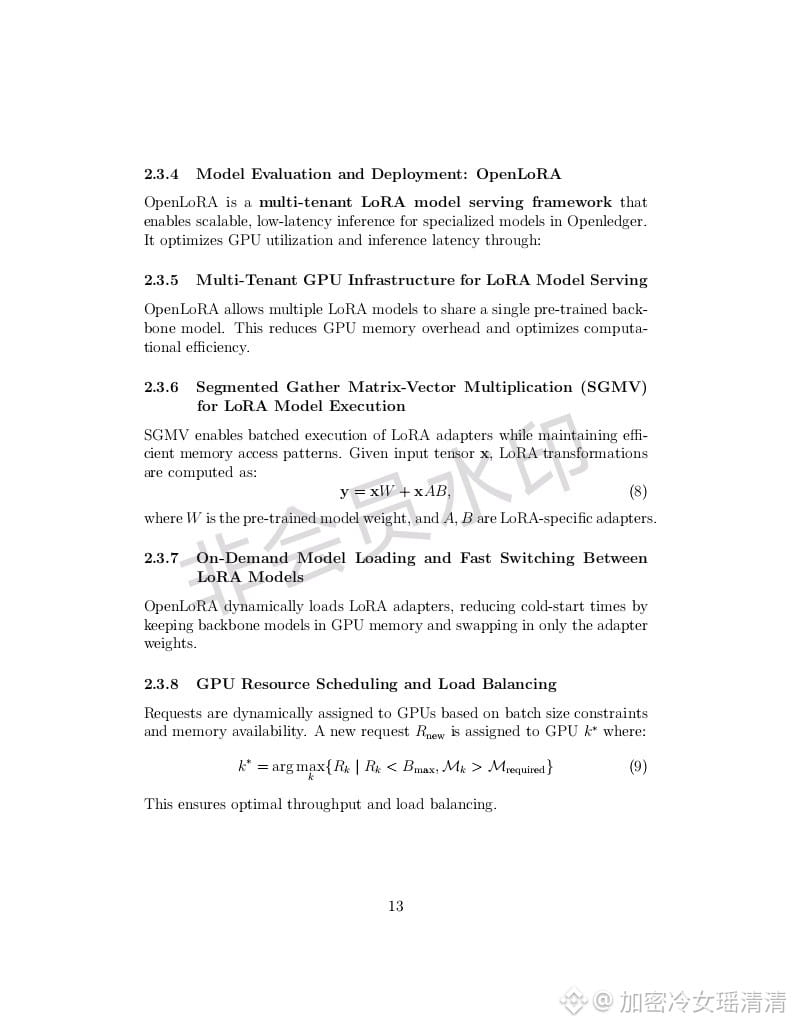
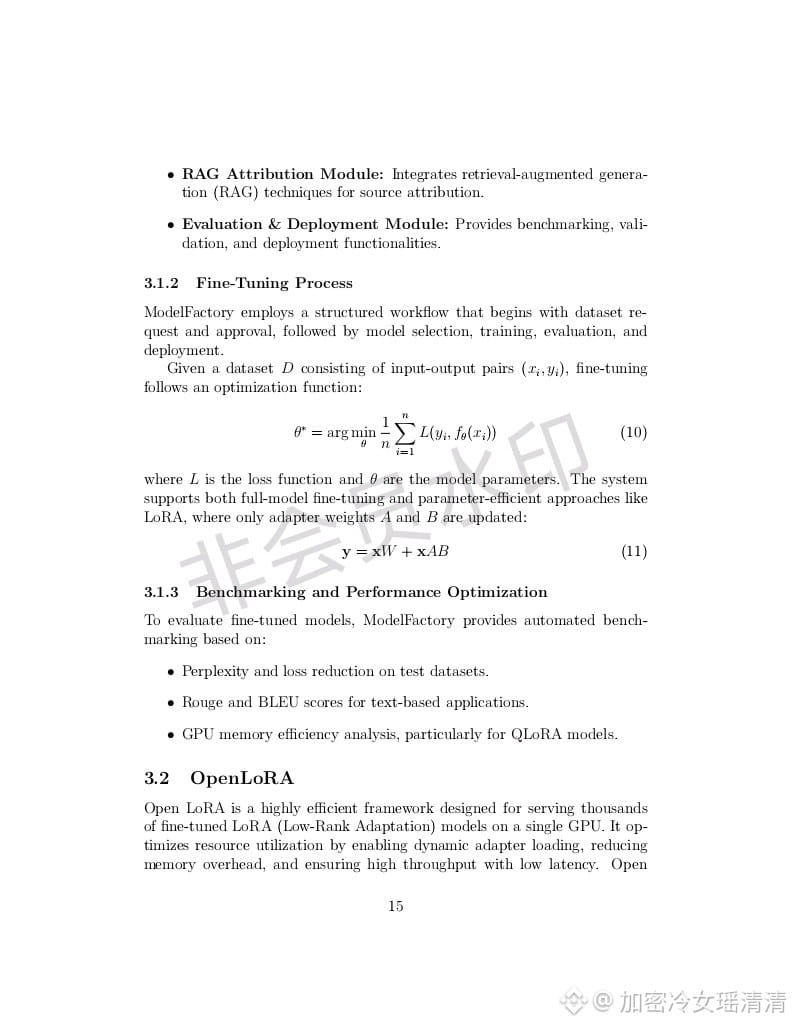
No whitepaper, diz que essa ModelFactory suporta ajustes LoRA e QLoRA, então até eu, que sou meio novato em código, consegui mexer. Não precisei escrever linha de comando; só escolhi o modelo na página, liguei o dataset e cliquei em começar, fui dormir. No dia seguinte, olhei e vi que o treinamento estava concluído. Testei alguns contratos e a taxa de acerto foi muito melhor do que quando eu fiz manualmente.
O melhor é que esse modelo não é só pra mim. Posso implantá-lo na plataforma, e cada vez que alguém usar, eles pagam $OPEN e o sistema divide automaticamente. Eu fico com minha parte pela contribuição do modelo, quem forneceu os dados fica com a parte dos dados, e quem fez o stake recebe pela manutenção.
Isso é completamente diferente do $BTC , que é tipo minerar e vender por conta própria, e também é outra história de $ETH , que só implanta um contrato e não gera receita contínua. Isso é uma máquina de divisão de lucros que opera automaticamente.
Eu fiz as contas: se dezenas de pessoas usarem meu modelo de contrato todo dia, no final do mês, já dá pra pagar o aluguel. E, quanto mais uso, o modelo vai se otimizando com o feedback, ficando cada vez mais preciso.
Agora estou preparando meu segundo modelo, desta vez focado em triagem de currículos. Já encontrei os dados, e vou começar no fim de semana. #OpenLedger
Mês passado, eu queria ajustar um modelo de revisão de contratos legais, focando em identificar cláusulas enganosas em contratos de aluguel. Eu passei três dias na internet catando um monte de amostras de contratos bagunçados. Alguns com formatos errados, outros com cláusulas que não faziam sentido. No final, não consegui usar nada.
Depois, eu simplesmente selecionei um dataset de contratos pronto na ModelFactory do @OpenLedger . A equipe profissional limpou tudo, e cada cláusula tem etiquetas de tipo, tudo bem claro. Com alguns cliques, eu já consegui puxar pra treinar.
No whitepaper, diz que essa ModelFactory suporta ajustes LoRA e QLoRA, então até eu, que sou meio novato em código, consegui mexer. Não precisei escrever linha de comando; só escolhi o modelo na página, liguei o dataset e cliquei em começar, fui dormir. No dia seguinte, olhei e vi que o treinamento estava concluído. Testei alguns contratos e a taxa de acerto foi muito melhor do que quando eu fiz manualmente.
O melhor é que esse modelo não é só pra mim. Posso implantá-lo na plataforma, e cada vez que alguém usar, eles pagam $OPEN e o sistema divide automaticamente. Eu fico com minha parte pela contribuição do modelo, quem forneceu os dados fica com a parte dos dados, e quem fez o stake recebe pela manutenção.
Isso é completamente diferente do $BTC , que é tipo minerar e vender por conta própria, e também é outra história de $ETH , que só implanta um contrato e não gera receita contínua. Isso é uma máquina de divisão de lucros que opera automaticamente.
Eu fiz as contas: se dezenas de pessoas usarem meu modelo de contrato todo dia, no final do mês, já dá pra pagar o aluguel. E, quanto mais uso, o modelo vai se otimizando com o feedback, ficando cada vez mais preciso.
Agora estou preparando meu segundo modelo, desta vez focado em triagem de currículos. Já encontrei os dados, e vou começar no fim de semana. #OpenLedger