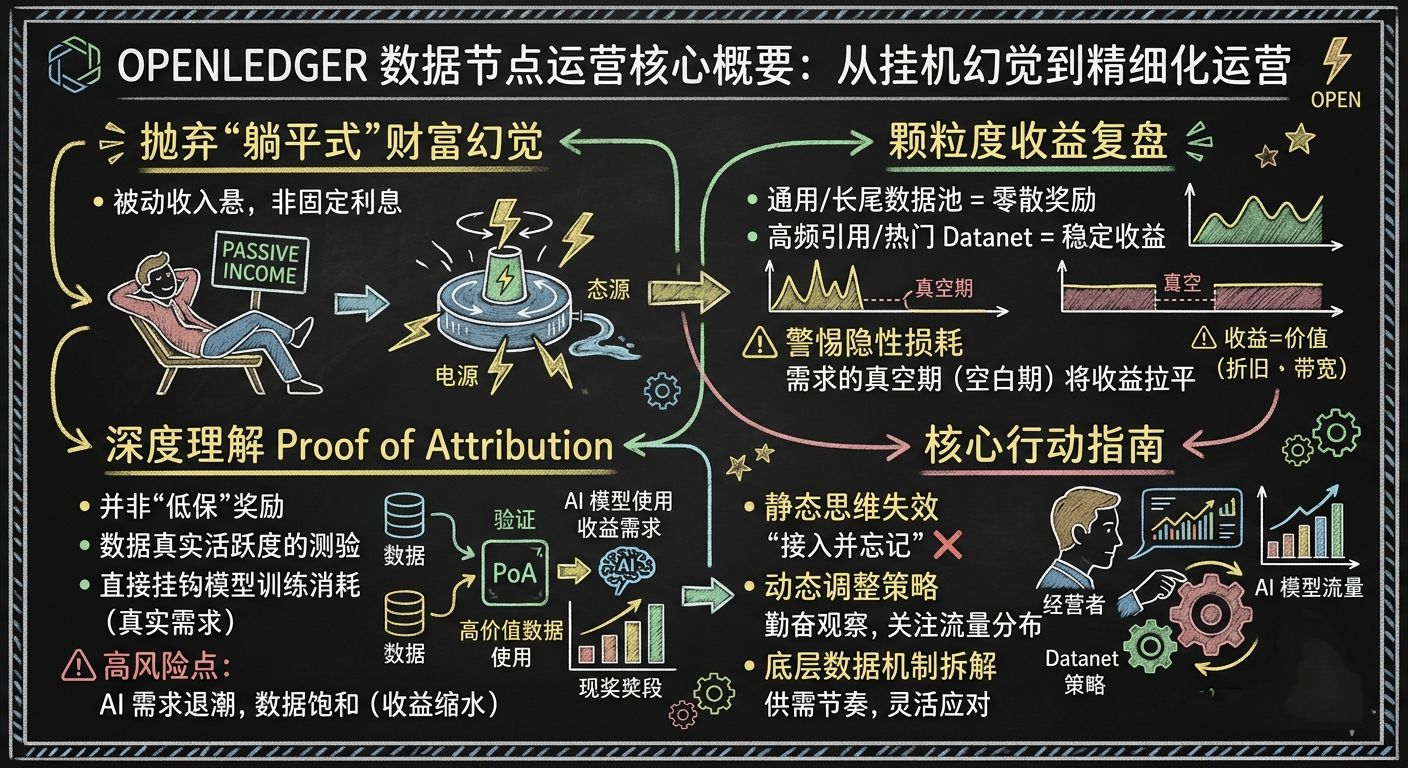
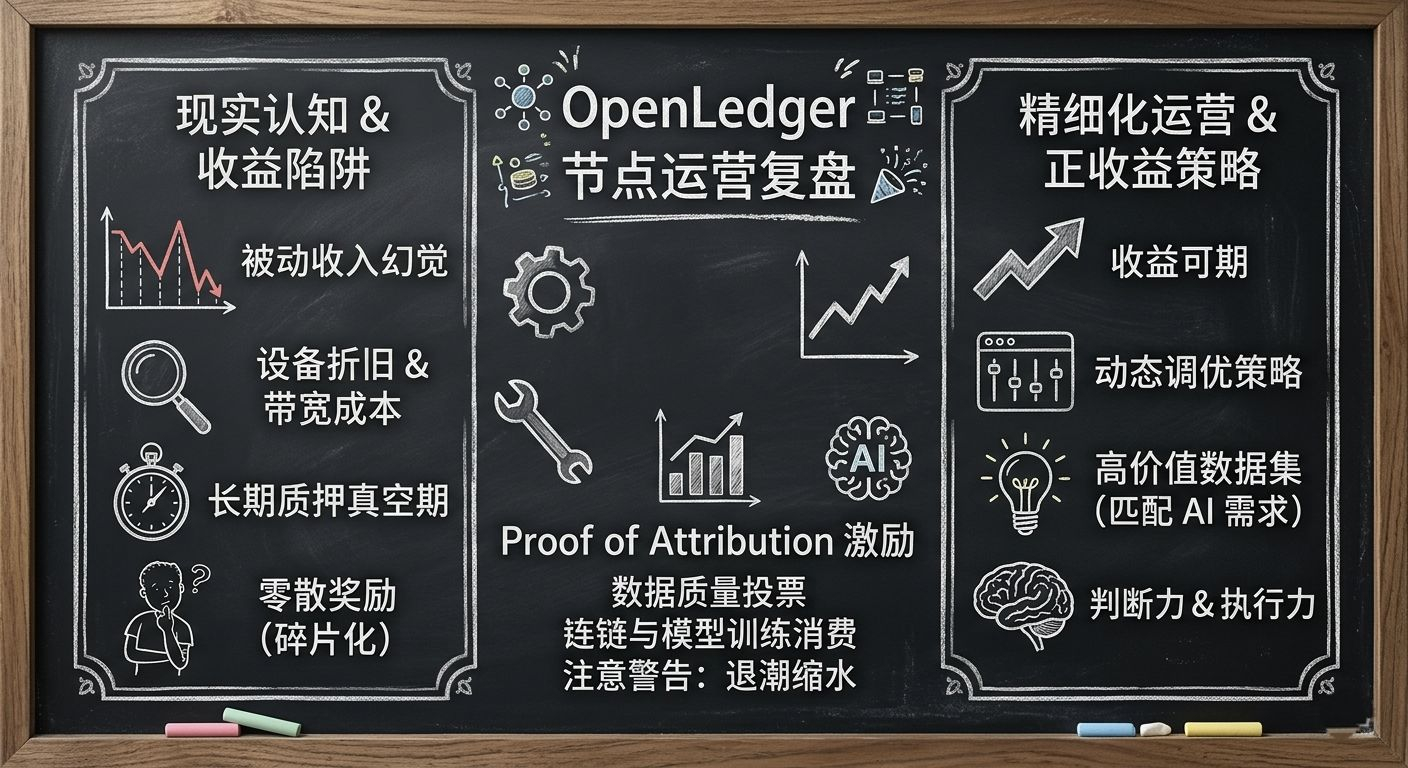
Recentemente, adicionei alguns dispositivos ao ecossistema de @OpenLedger e fiz uma análise aprofundada dos retornos granularizados do Datanet nesse tempo. Minha mentalidade agora está muito mais estável do que quando entrei no jogo. Muita gente encara os nós de dados da IA de forma simplista, achando que basta ligar os equipamentos e que o saldo de $OPEN na conta vai crescer automaticamente, essa ilusão de riqueza passiva é, na verdade, um sonho acordado para muitos novatos.
Revisei alguns registros de interações anteriores e percebi que, ao focar apenas em prolongar o tempo de atividade, ao conectar aqueles pools de dados long tail e pouco populares, os retornos fragmentados, após descontar os custos de energia e perda de rede, têm um ROI surpreendentemente baixo. Muitos se deixam levar pela expectativa de airdrops, mas esquecem que dados de baixa qualidade, no contexto do treinamento de IA, não têm poder de barganha. No máximo, estão contribuindo com uma carga ineficaz para o protocolo. Para realmente estabelecer um modelo de retorno sustentável no OpenLedger, o cerne está na compreensão da tokenização dos dados. Você precisa entender que um nó não é apenas um terminal físico, mas também um portal de dados que precisa ser ajustado dinamicamente. Ao comparar, descobri que aqueles nós que conseguem gerar retornos estáveis estão, sem exceção, alinhados com as demandas de treinamento dos modelos mainstream do Datanet. Existe uma enorme lacuna cognitiva: a maioria das pessoas só olha para o APY atual e ignora que a demanda de poder computacional para treinamento de IA oscila de forma escalonada. Se você não se preparar bem com o cache de dados antes do pico de demanda, sua largura de banda e capacidade de armazenamento estarão, na maior parte do tempo, apenas girando em falso.
Falando do mecanismo de incentivos muito comentado de #OpenLedger . Após um longo período de observação, percebi profundamente que a chamada distribuição de retornos é, na essência, a precificação em tempo real de conjuntos de dados de alto valor dentro do ecossistema. Se seus dados não atingirem diretamente o caminho crítico para o ajuste fino do grande modelo ou para a geração aumentada de busca, não importa quanto tempo seu nó estiver online, o mecanismo de recompensa filtrará isso por meio do peso algorítmico.
Falando de forma direta, na pista de $OPEN , estratégias de configuração estáticas já não têm mais validade. O espaço de lucro futuro pertence apenas àqueles que realmente tratam os nós como fábricas de dados para operar de forma refinada. Lembre-se, as recompensas do OpenLedger nunca foram pelo tempo que seus dispositivos ficaram online, mas sim pela sua capacidade como fornecedor de dados de avaliar e executar nesta onda de transformação da IA.
Revisei alguns registros de interações anteriores e percebi que, ao focar apenas em prolongar o tempo de atividade, ao conectar aqueles pools de dados long tail e pouco populares, os retornos fragmentados, após descontar os custos de energia e perda de rede, têm um ROI surpreendentemente baixo. Muitos se deixam levar pela expectativa de airdrops, mas esquecem que dados de baixa qualidade, no contexto do treinamento de IA, não têm poder de barganha. No máximo, estão contribuindo com uma carga ineficaz para o protocolo. Para realmente estabelecer um modelo de retorno sustentável no OpenLedger, o cerne está na compreensão da tokenização dos dados. Você precisa entender que um nó não é apenas um terminal físico, mas também um portal de dados que precisa ser ajustado dinamicamente. Ao comparar, descobri que aqueles nós que conseguem gerar retornos estáveis estão, sem exceção, alinhados com as demandas de treinamento dos modelos mainstream do Datanet. Existe uma enorme lacuna cognitiva: a maioria das pessoas só olha para o APY atual e ignora que a demanda de poder computacional para treinamento de IA oscila de forma escalonada. Se você não se preparar bem com o cache de dados antes do pico de demanda, sua largura de banda e capacidade de armazenamento estarão, na maior parte do tempo, apenas girando em falso.
Falando do mecanismo de incentivos muito comentado de #OpenLedger . Após um longo período de observação, percebi profundamente que a chamada distribuição de retornos é, na essência, a precificação em tempo real de conjuntos de dados de alto valor dentro do ecossistema. Se seus dados não atingirem diretamente o caminho crítico para o ajuste fino do grande modelo ou para a geração aumentada de busca, não importa quanto tempo seu nó estiver online, o mecanismo de recompensa filtrará isso por meio do peso algorítmico.
Falando de forma direta, na pista de $OPEN , estratégias de configuração estáticas já não têm mais validade. O espaço de lucro futuro pertence apenas àqueles que realmente tratam os nós como fábricas de dados para operar de forma refinada. Lembre-se, as recompensas do OpenLedger nunca foram pelo tempo que seus dispositivos ficaram online, mas sim pela sua capacidade como fornecedor de dados de avaliar e executar nesta onda de transformação da IA.