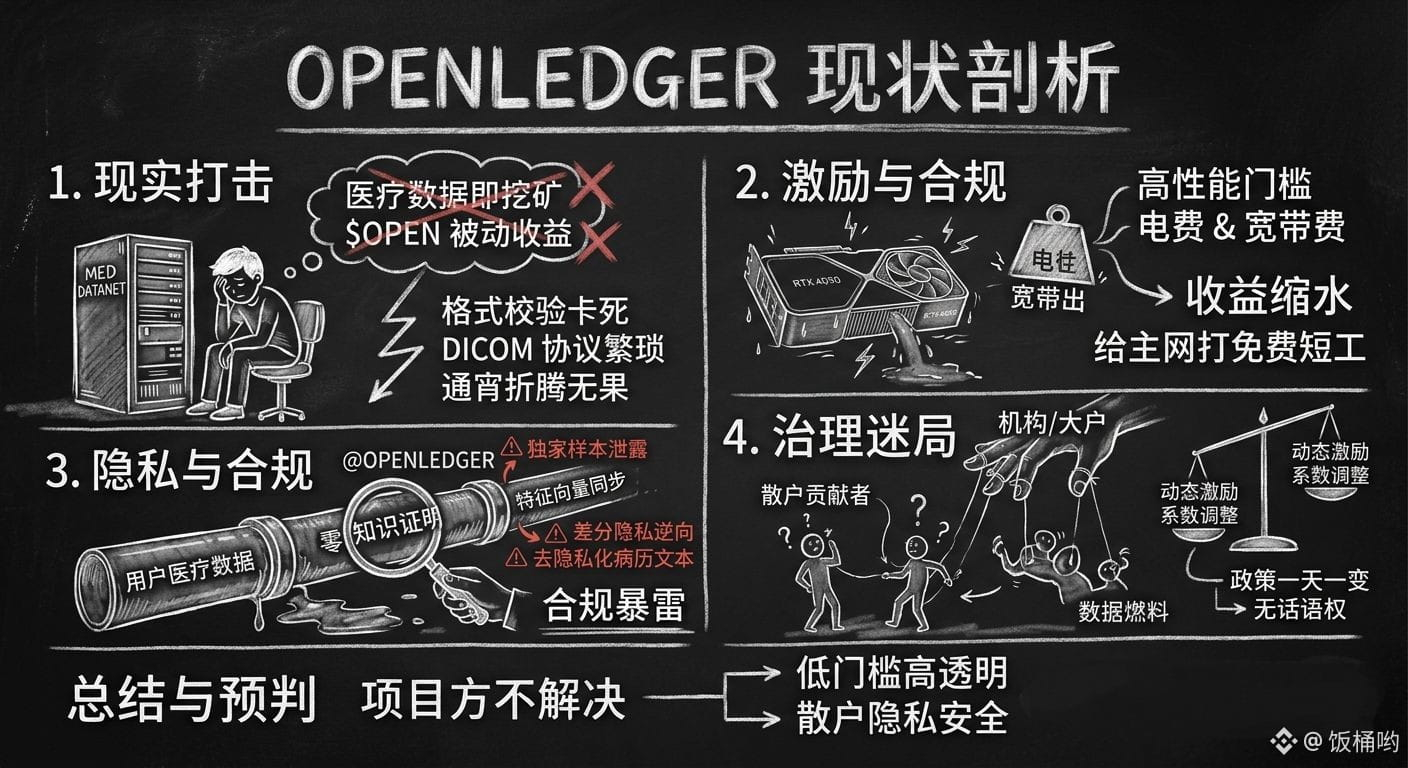
Nos últimos dias, vi a galera falando sobre a plataforma de anotação de imagens médicas AI @OpenLedger na praça. Fui impulsionado e enviei um conjunto de dados de cortes de pele que meu estúdio havia acumulado para o Med DataNet. O resultado? Passei a noite inteira me quebrando para tentar, mas fiquei travado na parte de validação de formato, quase enlouquecendo com aquele protocolo complicado de conversão DICOM e a lógica de alinhamento de rótulos.
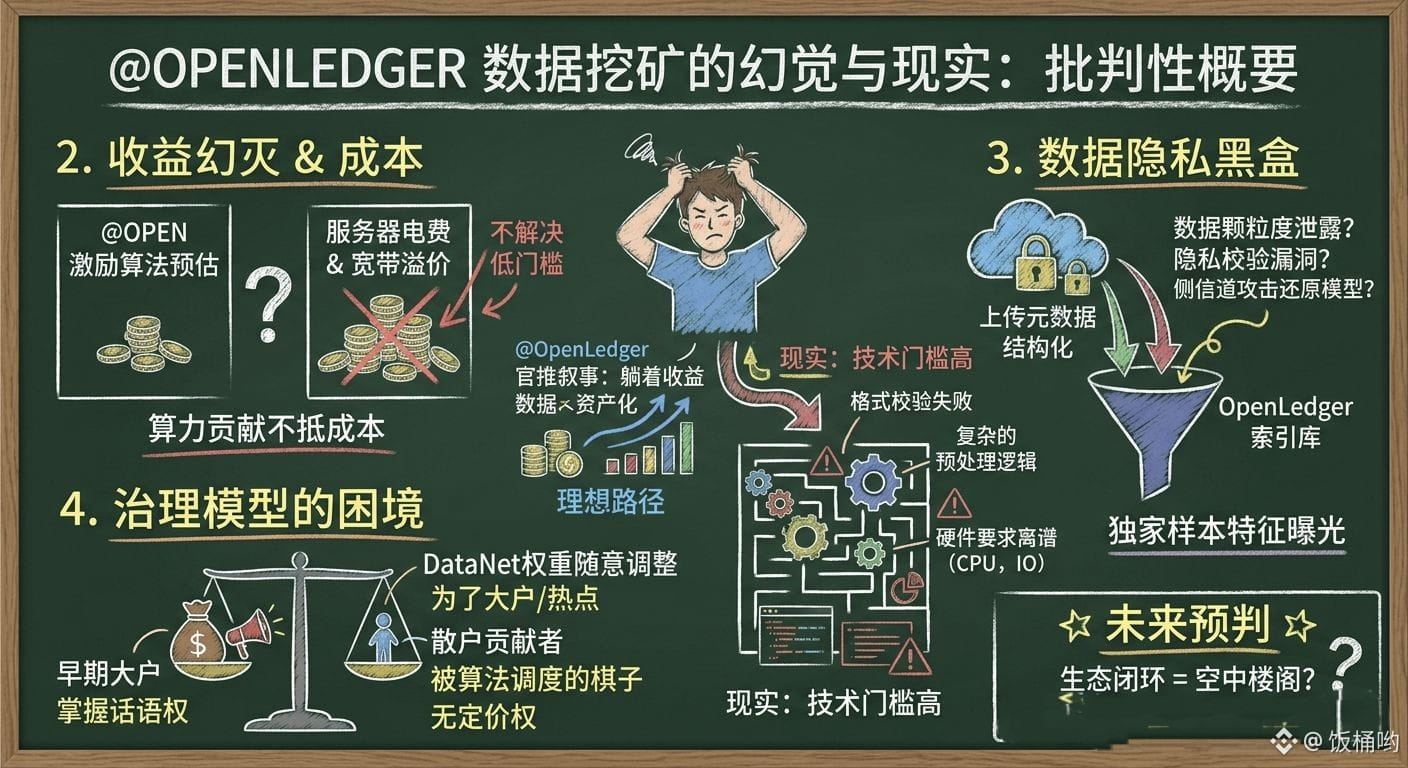
Eu admito que antes fui seduzido pela narrativa grandiosa de mineração de dados médicos que eles estavam promovendo, sonhando que, ao enviar meus ativos guardados, conseguiria colher um rendimento passivo de $OPEN . Mas quando fui implantar o nó de validação, a realidade me deu um tapa na cara. No documento oficial, chamam isso de construção colaborativa de baixo custo, mas na verdade, os requisitos de throughput de memória e largura de banda são assustadoramente altos. Passei três dias rodando em minha estação de trabalho top de linha com uma 4090, e ao calcular segundo a nova fórmula de incentivos dinâmicos deles, descontando a conta de luz cheia e o custo da banda larga comercial, o que recebi em $OPEN mal dá para comprar um café, foi pura mão de obra gratuita para a mainnet.
Mais assustador do que a diminuição dos rendimentos é o buraco sem fundo da titularidade e conformidade dos dados subjacentes. @OpenLedger adora falar sobre suas provas de conhecimento zero e criptografia homomórfica, dizendo que conseguem tornar os dados utilizáveis mas invisíveis. Mas na prática, para conseguir um peso de incentivo alto, você tem que empacotar e sincronizar os vetores de características dos dados e os textos de prontuários despersonalizados. Embora digam que os dados médicos são armazenados de forma descentralizada e anônima, quem pode garantir que os nós de roteamento do nível de busca não serão hackeados através de engenharia reversa por privacidade diferencial? Se ocorrer uma vazamento de amostra exclusiva, quem vai levar a culpa não somos nós, os mineradores digitais que fornecem os dados? #OpenLedger
O que é ainda mais desanimador é a atmosfera de governança da comunidade em torno do $OPEN agora. As políticas mudam todo dia, e nós, pequenos investidores, não temos nem direito à informação, quanto mais à voz. Para resumir, somos apenas combustível sendo colhido repetidamente pelos algoritmos dos tubarões. Agora, estou completamente desencantado. Se a @OpenLedger realmente está revolucionando a forma como os materiais de produção de IA são distribuídos, ou se está apenas usando a camada de IA descentralizada para criar uma nova onda de ilusões de tráfego, isso nem precisa ser discutido. É isso aí, se a equipe do projeto não levar a sério a segurança da privacidade e a transparência dos rendimentos dos pequenos investidores, confiar só em alguns grandes players na comunidade para fazer o jogo de vai-e-vem, essa narrativa chamada Web3+AI não passa de miragem.
Eu admito que antes fui seduzido pela narrativa grandiosa de mineração de dados médicos que eles estavam promovendo, sonhando que, ao enviar meus ativos guardados, conseguiria colher um rendimento passivo de $OPEN . Mas quando fui implantar o nó de validação, a realidade me deu um tapa na cara. No documento oficial, chamam isso de construção colaborativa de baixo custo, mas na verdade, os requisitos de throughput de memória e largura de banda são assustadoramente altos. Passei três dias rodando em minha estação de trabalho top de linha com uma 4090, e ao calcular segundo a nova fórmula de incentivos dinâmicos deles, descontando a conta de luz cheia e o custo da banda larga comercial, o que recebi em $OPEN mal dá para comprar um café, foi pura mão de obra gratuita para a mainnet.
Mais assustador do que a diminuição dos rendimentos é o buraco sem fundo da titularidade e conformidade dos dados subjacentes. @OpenLedger adora falar sobre suas provas de conhecimento zero e criptografia homomórfica, dizendo que conseguem tornar os dados utilizáveis mas invisíveis. Mas na prática, para conseguir um peso de incentivo alto, você tem que empacotar e sincronizar os vetores de características dos dados e os textos de prontuários despersonalizados. Embora digam que os dados médicos são armazenados de forma descentralizada e anônima, quem pode garantir que os nós de roteamento do nível de busca não serão hackeados através de engenharia reversa por privacidade diferencial? Se ocorrer uma vazamento de amostra exclusiva, quem vai levar a culpa não somos nós, os mineradores digitais que fornecem os dados? #OpenLedger
O que é ainda mais desanimador é a atmosfera de governança da comunidade em torno do $OPEN agora. As políticas mudam todo dia, e nós, pequenos investidores, não temos nem direito à informação, quanto mais à voz. Para resumir, somos apenas combustível sendo colhido repetidamente pelos algoritmos dos tubarões. Agora, estou completamente desencantado. Se a @OpenLedger realmente está revolucionando a forma como os materiais de produção de IA são distribuídos, ou se está apenas usando a camada de IA descentralizada para criar uma nova onda de ilusões de tráfego, isso nem precisa ser discutido. É isso aí, se a equipe do projeto não levar a sério a segurança da privacidade e a transparência dos rendimentos dos pequenos investidores, confiar só em alguns grandes players na comunidade para fazer o jogo de vai-e-vem, essa narrativa chamada Web3+AI não passa de miragem.