

OpenLedger e a Estranha Sensação de que a IA Talvez Finalmente Esteja Batendo na Mesma Parede.
Eu já estou no mundo cripto há tempo suficiente para parar de reagir toda vez que um projeto afirma que está “redefinindo” alguma coisa.
Na maior parte das vezes, essas palavras são só embalagens recicladas em torno dos mesmos incentivos antigos. Novo token, nova marca, a mesma realidade subjacente: alguns poucos insiders capturam o valor, a multidão fornece liquidez e, eventualmente, a narrativa segue para outro lugar.
É provavelmente por isso que eu tenho ficado mais devagar para me empolgar com qualquer coisa ligada à IA ultimamente. O espaço já parece superlotado de promessas gigantescas. Toda semana surge outro protocolo afirmando que vai descentralizar a inteligência, tokenizar agentes, reinventar a computação ou substituir a própria internet. Depois de um tempo, tudo se mistura no mesmo ruído de fundo.
Mas de vez em quando algo chama minha atenção, não porque eu de repente acredite nisso, mas porque parece focado em um problema que realmente existe.
OpenLedger é um desses projetos para mim.
Não estou dizendo que funciona. Não estou dizendo que vence. Não estou sequer dizendo que o modelo é sustentável. Sinceramente, ainda não sei.
Mas eu continuo percebendo que a questão de fundo que ele está levantando parece mais real do que a maioria das narrativas sobre IA que circulam por aí no universo cripto agora.
A pergunta é simples: se os modelos de IA estão se tornando alguns dos sistemas mais valiosos do mundo, por que quase ninguém sabe mais de onde realmente vem o valor?
Isso parece óbvio à primeira vista, mas quanto mais fundo você pensa nisso, mais estranha começa a parecer toda a economia da IA.
A maioria dos sistemas de IA hoje é construída sobre oceanos de dados reunidos de pessoas que, em geral, nunca veem compensação, propriedade ou sequer reconhecimento. Escritores, artistas, pesquisadores, usuários de fóruns, desenvolvedores, comunidades de nicho, arquivos aleatórios da internet — tudo isso é absorvido por modelos que, no fim, se tornam produtos que valem bilhões.
E, de algum modo, todo mundo simplesmente aceitou que isso é normal.
Talvez porque os sistemas tenham se tornado grandes demais para serem questionados. Talvez porque as empresas que os constroem tenham avançado mais rápido do que a regulação. Talvez porque ninguém conseguisse rastrear de forma realista a atribuição depois que os modelos atingiram certa escala.
Essa última parte importa.
Durante anos, um dos maiores problemas em IA tem sido a própria atribuição. Quando um modelo é treinado com dados suficientes, rastrear a influência se torna difuso. Tudo vira uma caixa-preta. Às vezes uma caixa-preta útil, mas ainda assim uma caixa-preta.
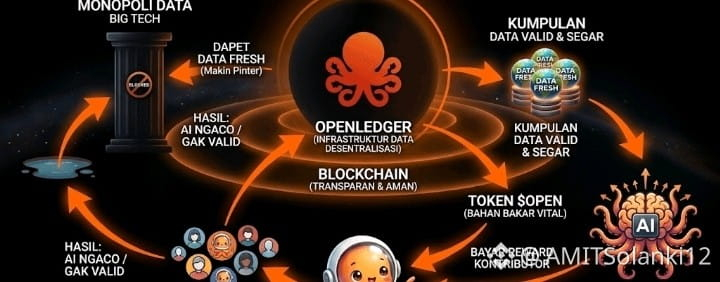
É aí que a OpenLedger fica girando em torno com essa ideia de Proof of Attribution.
O conceito parece ambicioso demais quando você o lê pela primeira vez. O protocolo tenta conectar as saídas do modelo aos dados que as influenciaram e, então, recompensar os contribuidores de forma proporcional por meio da rede.
Já vi o cripto tentar coisas parecidas antes, em formas diferentes. Royalties musicais. Economias de criadores. Incentivos de armazenamento. Mercados de atenção. Mercados de dados.
A maioria deles acabou esbarrando na mesma parede: medir a contribuição de forma significativa é brutalmente difícil.#OpenAIToConfidentiallyFileForIPO $OPEN

#