OpenLedger e a Estranha Sensação de que a IA Talvez Finalmente Esteja Batendo na Mesma Parede.
Já estou no mundo cripto há tempo suficiente para parar de reagir toda vez que um projeto afirma que está “redefinindo” algo.
Na maior parte do tempo, essas palavras são apenas embalagens reaproveitadas em torno dos mesmos incentivos de sempre. Novo token, nova marca, a mesma realidade subjacente: alguns poucos insiders capturam o valor, a multidão fornece liquidez e, eventualmente, a narrativa se move para outro lugar.
Provavelmente é por isso que eu tenho ficado mais lento para me empolgar com qualquer coisa ligada a IA ultimamente. O setor já parece superlotado de promessas exageradas. Toda semana há outro protocolo dizendo que vai descentralizar a inteligência, tokenizar agentes, reinventar a computação ou substituir a própria internet. Depois de um tempo, tudo se mistura no mesmo ruído de fundo.
Mas de vez em quando alguma coisa chama minha atenção — não porque eu de repente passei a acreditar nisso, mas porque parece focada em um problema que realmente existe.
OpenLedger é um desses projetos que, para mim, faz sentido.
Não estou dizendo que funciona. Não estou dizendo que vence. Nem estou dizendo que o modelo é sustentável. Honestamente, ainda não sei.
Mas eu continuo notando que a pergunta subjacente que ele está fazendo parece mais real do que a maioria das narrativas de IA que circulam no cripto agora.
A pergunta é simples: se modelos de IA estão se tornando alguns dos sistemas mais valiosos do mundo, por que quase ninguém sabe de onde vem o valor, de fato, agora?
Isso parece óbvio à primeira vista, mas quanto mais você pensa a respeito, mais estranho começa a parecer o funcionamento de toda a economia da IA.
A maior parte dos sistemas de IA hoje é construída sobre oceanos de dados coletados de pessoas que, na maioria das vezes, nunca veem compensação, propriedade ou nem mesmo reconhecimento. Escritores, artistas, pesquisadores, usuários de fóruns, desenvolvedores, comunidades de nicho, arquivos aleatórios da internet — tudo isso é absorvido por modelos que, eventualmente, viram produtos valendo bilhões.
E, de alguma forma, todo mundo apenas aceitou que isso é normal.
Talvez porque os sistemas ficaram grandes demais para questionar. Talvez porque as empresas que os construíram andaram mais rápido do que a regulamentação. Talvez porque ninguém conseguisse rastrear atribuição de forma realista quando os modelos atingiram um certo nível de escala.
Essa última parte importa.
Por anos, um dos maiores problemas em IA tem sido a atribuição em si. Depois que um modelo treina com dados suficientes, rastrear influência fica desfocado. Tudo vira uma caixa-preta. Uma caixa-preta útil às vezes, mas ainda assim uma caixa-preta.
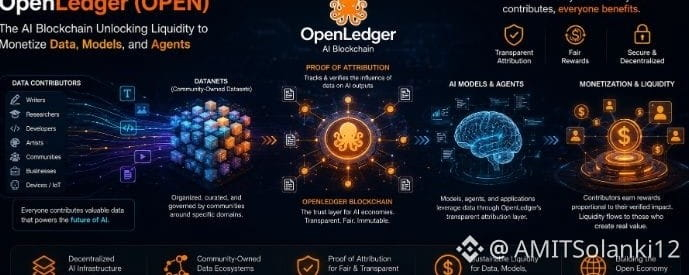
É aí que o OpenLedger fica voltando com essa ideia de Proof of Attribution.
O conceito soa quase ambicioso demais quando você lê pela primeira vez. O protocolo tenta conectar as saídas do modelo de volta aos dados que as influenciaram; em seguida, recompensar os contribuidores de forma proporcional por meio da rede.
Eu já vi o cripto tentar coisas parecidas antes, de formas diferentes. Royalties de música. Economias de criadores. Incentivos de armazenamento. Mercados de atenção. Plataformas de dados.
A maior parte deles eventualmente encontrou a mesma barreira: medir contribuição de um jeito significativo é brutalmente difícil.$OPEN