
AI အေးဂျင့်တွေနဲ့ပတ်သက်တဲ့ ပြဿနာတစ်ခုကို မကြာခဏ သတိမထားမိကြပါဘူး။ သူတို့ ပိုအသုံးဝင်လာလေလေ၊ ကိုင်တွယ်ဖို့လိုအပ်တဲ့ အရေးကြီးအချက်အလက်တွေကလည်း ပိုများလာလေလေပါပဲ။
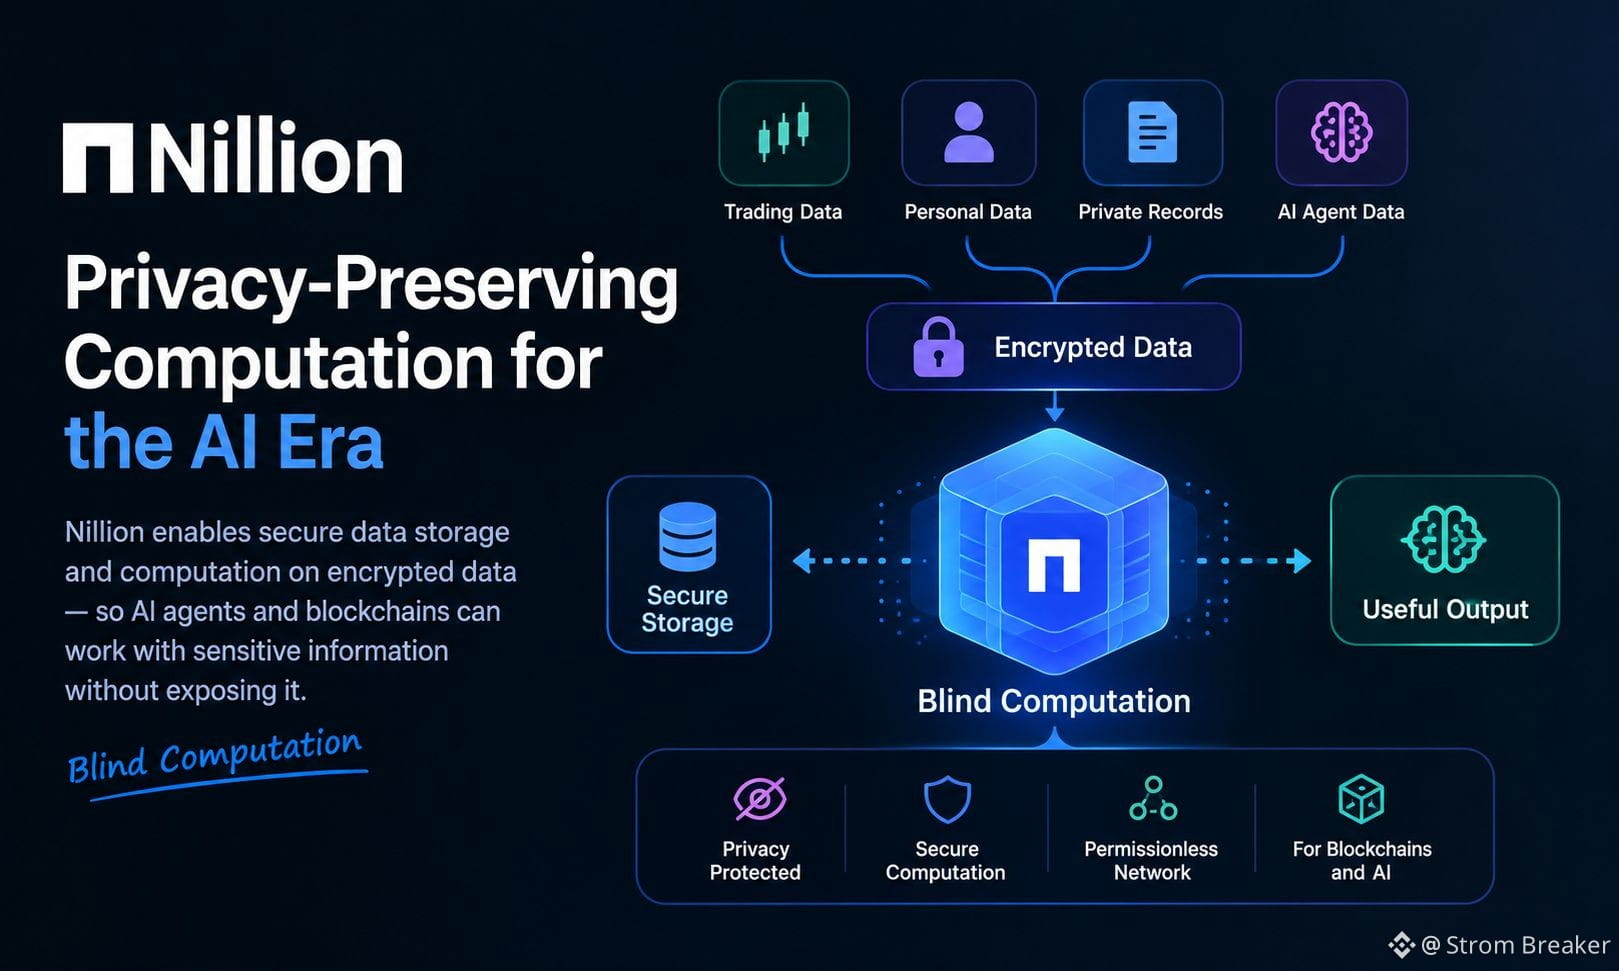
ကုန်သွယ်ရေးမဟာဗျူဟာတွေကို စီမံခန့်ခွဲတာ၊ လျှို့ဝှက်မှတ်တမ်းတွေကို ဝင်ရောက်ကြည့်ရှုတာ၊ ဒါမှမဟုတ် ကိုယ်ရေးကိုယ်တာအချက်အလက်တွေအပေါ် အခြေခံပြီး ဆုံးဖြတ်ချက်ချတာတွေ လုပ်ဆောင်နေတဲ့ အေးဂျင့်တစ်ခုကို စဉ်းစားကြည့်ပါ။ စိန်ခေါ်မှုက မော်ဒယ်ကို ပိုထက်မြက်အောင်လုပ်ဖို့တင် မဟုတ်ပါဘူး။ အဲဒီအချက်အလက်တွေကို မလိုအပ်ဘဲ ဖော်ထုတ်ခြင်းမရှိဘဲ စနစ်က အသုံးပြုနိုင်အောင် လုပ်ဖို့လည်း ဖြစ်ပါတယ်။
ဒါကြောင့်ပဲ Nillion ကို စိတ်ဝင်စားမိတာပါ။
သူတို့ရဲ့ မျက်ကွယ်ပြုတွက်ချက်မှုနည်းလမ်းက အခြေခံအဆောက်အအုံ လည်ပတ်သူတိုင်းကို မူရင်းအချက်အလက်တွေ မြင်ခွင့်ပေးစရာမလိုဘဲ ကာကွယ်ထားတဲ့ ဒေတာတွေကို အသုံးပြုနိုင်အောင် အာရုံစိုက်ထားပါတယ်။ လျှို့ဝှက်ချက်ခွဲဝေခြင်းနဲ့ လျှို့ဝှက်တွက်ချက်မှုလို နည်းပညာတွေကို အသုံးပြုပြီး Nillion ဟာ ဒေတာကို ရယူနိုင်ခွင့်နဲ့ ဒေတာအသုံးချနိုင်မှုကို သီးခြားခွဲထားနိုင်မယ့် နည်းလမ်းအမျိုးမျိုးကို စူးစမ်းနေပါတယ်။
ကျွန်တော့်အာရုံကို ဖမ်းစားမိတာက ပိုကျယ်ပြန့်တဲ့ အကျိုးဆက်ပါ။ ကိုယ်ရေးအချက်အလက်လုံခြုံမှုရှိဖို့ဆိုတာ ဒေတာကို လုံးဝအသုံးမပြုနိုင်အောင် လုပ်ရမယ်လို့ မဆိုလိုပါဘူး။ အကောင်းဆုံးဆိုရင် အကျိုးရှိတဲ့အလုပ်တွေ ဆက်လုပ်နိုင်စေပြီး ဒေတာကနေ ဘာတွေသိရှိနိုင်မလဲဆိုတာကို ထိန်းချုပ်နိုင်ခြင်းကို ဆိုလိုပါတယ်။
သေချာတာကတော့ အသေးစိတ်အချက်တွေက အရေးကြီးပါတယ်။ ကိုယ်ရေးအချက်အလက်လုံခြုံမှုဆိုင်ရာ နည်းပညာတစ်ခုစီမှာ လုံခြုံရေးဆိုင်ရာ ယူဆချက်တွေ၊ စွမ်းဆောင်ရည်ကုန်ကျစရိတ်တွေနဲ့ ကန့်သတ်ချက်တွေ မတူညီကြပါဘူး။ လက်တွေ့အသုံးချမှုတွေမှာ ဒီစနစ်တွေကို ဆော့ဖ်ဝဲရေးသားသူတွေ ထိရောက်စွာ အသုံးပြုနိုင်မနိုင်အပေါ် မူတည်ပြီး လက်ခံအသုံးပြုမှုက ဆုံးဖြတ်သွားမှာပါ။
ဒါပေမဲ့ AI အေးဂျင့်တွေမှာ တာဝန်ယူမှု ပိုများလာတာနဲ့အမျှ လုံခြုံတဲ့ ဒေတာကိုင်တွယ်မှုဟာ ရွေးချယ်စရာအင်္ဂါရပ်တစ်ခုထက် သူတို့ရဲ့ အခြေခံအဆောက်အအုံရဲ့ မရှိမဖြစ်အစိတ်အပိုင်းတစ်ခု ဖြစ်လာနိုင်ပါတယ်။
တကယ့်မေးခွန်းကတော့ ကိုယ်ရေးအချက်အလက်ကို ထိန်းသိမ်းပေးတဲ့ တွက်ချက်မှုနည်းလမ်းတွေဟာ လုံလောက်အောင် လက်တွေ့ကျလာပြီး ဆော့ဖ်ဝဲရေးသားသူတွေက အထူးပြုစိန်ခေါ်မှုတစ်ခုလို သဘောထားတာကို ရပ်ကာ ပုံမှန်အားဖြင့် ဒီနည်းလမ်းတွေနဲ့ပဲ စတင်တည်ဆောက်လာနိုင်မလား ဆိုတာပါ။
#nil $NIL @Nillion
ကုန်သွယ်ရေးမဟာဗျူဟာတွေကို စီမံခန့်ခွဲတာ၊ လျှို့ဝှက်မှတ်တမ်းတွေကို ဝင်ရောက်ကြည့်ရှုတာ၊ ဒါမှမဟုတ် ကိုယ်ရေးကိုယ်တာအချက်အလက်တွေအပေါ် အခြေခံပြီး ဆုံးဖြတ်ချက်ချတာတွေ လုပ်ဆောင်နေတဲ့ အေးဂျင့်တစ်ခုကို စဉ်းစားကြည့်ပါ။ စိန်ခေါ်မှုက မော်ဒယ်ကို ပိုထက်မြက်အောင်လုပ်ဖို့တင် မဟုတ်ပါဘူး။ အဲဒီအချက်အလက်တွေကို မလိုအပ်ဘဲ ဖော်ထုတ်ခြင်းမရှိဘဲ စနစ်က အသုံးပြုနိုင်အောင် လုပ်ဖို့လည်း ဖြစ်ပါတယ်။
ဒါကြောင့်ပဲ Nillion ကို စိတ်ဝင်စားမိတာပါ။
သူတို့ရဲ့ မျက်ကွယ်ပြုတွက်ချက်မှုနည်းလမ်းက အခြေခံအဆောက်အအုံ လည်ပတ်သူတိုင်းကို မူရင်းအချက်အလက်တွေ မြင်ခွင့်ပေးစရာမလိုဘဲ ကာကွယ်ထားတဲ့ ဒေတာတွေကို အသုံးပြုနိုင်အောင် အာရုံစိုက်ထားပါတယ်။ လျှို့ဝှက်ချက်ခွဲဝေခြင်းနဲ့ လျှို့ဝှက်တွက်ချက်မှုလို နည်းပညာတွေကို အသုံးပြုပြီး Nillion ဟာ ဒေတာကို ရယူနိုင်ခွင့်နဲ့ ဒေတာအသုံးချနိုင်မှုကို သီးခြားခွဲထားနိုင်မယ့် နည်းလမ်းအမျိုးမျိုးကို စူးစမ်းနေပါတယ်။
ကျွန်တော့်အာရုံကို ဖမ်းစားမိတာက ပိုကျယ်ပြန့်တဲ့ အကျိုးဆက်ပါ။ ကိုယ်ရေးအချက်အလက်လုံခြုံမှုရှိဖို့ဆိုတာ ဒေတာကို လုံးဝအသုံးမပြုနိုင်အောင် လုပ်ရမယ်လို့ မဆိုလိုပါဘူး။ အကောင်းဆုံးဆိုရင် အကျိုးရှိတဲ့အလုပ်တွေ ဆက်လုပ်နိုင်စေပြီး ဒေတာကနေ ဘာတွေသိရှိနိုင်မလဲဆိုတာကို ထိန်းချုပ်နိုင်ခြင်းကို ဆိုလိုပါတယ်။
သေချာတာကတော့ အသေးစိတ်အချက်တွေက အရေးကြီးပါတယ်။ ကိုယ်ရေးအချက်အလက်လုံခြုံမှုဆိုင်ရာ နည်းပညာတစ်ခုစီမှာ လုံခြုံရေးဆိုင်ရာ ယူဆချက်တွေ၊ စွမ်းဆောင်ရည်ကုန်ကျစရိတ်တွေနဲ့ ကန့်သတ်ချက်တွေ မတူညီကြပါဘူး။ လက်တွေ့အသုံးချမှုတွေမှာ ဒီစနစ်တွေကို ဆော့ဖ်ဝဲရေးသားသူတွေ ထိရောက်စွာ အသုံးပြုနိုင်မနိုင်အပေါ် မူတည်ပြီး လက်ခံအသုံးပြုမှုက ဆုံးဖြတ်သွားမှာပါ။
ဒါပေမဲ့ AI အေးဂျင့်တွေမှာ တာဝန်ယူမှု ပိုများလာတာနဲ့အမျှ လုံခြုံတဲ့ ဒေတာကိုင်တွယ်မှုဟာ ရွေးချယ်စရာအင်္ဂါရပ်တစ်ခုထက် သူတို့ရဲ့ အခြေခံအဆောက်အအုံရဲ့ မရှိမဖြစ်အစိတ်အပိုင်းတစ်ခု ဖြစ်လာနိုင်ပါတယ်။
တကယ့်မေးခွန်းကတော့ ကိုယ်ရေးအချက်အလက်ကို ထိန်းသိမ်းပေးတဲ့ တွက်ချက်မှုနည်းလမ်းတွေဟာ လုံလောက်အောင် လက်တွေ့ကျလာပြီး ဆော့ဖ်ဝဲရေးသားသူတွေက အထူးပြုစိန်ခေါ်မှုတစ်ခုလို သဘောထားတာကို ရပ်ကာ ပုံမှန်အားဖြင့် ဒီနည်းလမ်းတွေနဲ့ပဲ စတင်တည်ဆောက်လာနိုင်မလား ဆိုတာပါ။
#nil $NIL @Nillion