


2024.03.14
プロジェクト紹介
昨年 6 月に設立された Grass は、公開 Web データを AI データセットに変換することに重点を置いた分散型 Web スクレイピング ネットワークを構築しています。ネットワークはユーザーによって所有および運営されており、誰でも AI に取り組む最も簡単な方法です。詳細については、Goose が以前に投稿したチュートリアルを参照してください。携帯電話でもプレイできます。
現在、Whales の価格は市場内外で 4.6U/1,000 ポイントに達しており、75% のネットワーク条件下では、1 つのデバイス IP で 1 か月に約 50,000 ポイント、つまり 240U をマイニングできます。昔、グースはあなたにマイニングを頼んだが、多くの人はマイニングするのが面倒だったので、あと数台電話を切る限り、コンピュータや携帯電話の電源を入れたまま 240u をマイニングできると言いました。旧正月には親戚や友人の家に240uがいくつかあります。少し後悔していますか?後悔しているなら、早く宿題をやりに来てください! !
現在、GrassはSOL上で最初のLayer 2データRollupを発表し、特に長いバージョンと公式の文章バージョンに分けていますので、小さな仲間が理解できるようにしています。
長すぎ
Grassはこの計画を提案する前にDEPINとAIの概念しか持っていませんでしたが、現在は独自のAIパブリックチェーンを構築する計画を立てています。これは、Grassが以前のAI企業がデータをクリーンアップする単純なビジネスから、データ台帳機能とZKプロセッサ機能を追加した全く異なるビジネスモデルに拡張されることを意味します。一度Layer 2が構築されれば、その概念はSOL+DEPIN+AI+初のデータロールアップの概念に変わり、四重の概念が重なり合います。その具体的な価値については言及しませんが、仲間たちは急いで掘りに行くべきではないでしょうか?
デスクトップチュートリアル:
https://weibo.com/ttarticle/p/show?id=2309404997006383775962
モバイルチュートリアル:
https://weibo.com/ttarticle/p/show?id=2309404998038614573232
正片
Grass:史上初のLayer 2データRollup
過去数週間で、私たちはGrassがAIスタックで果たす役割を説明するいくつかの内容を発表しました。今、あなたはこのプロトコルが多くの機能を実行し、ビルダーがネットワークデータにアクセスしてモデルを訓練するのを助けることを理解しています。これはAIプロセスの重要な第一段階であり、すべての開発の出発点です。
Grassの場合、ノードのセットが居住デバイス上でホストされ、ネットワークから生データを取得し処理します。それはデータをクリーン化し、AI訓練のために構造化されたデータセットに変換します。最も重要なことは、それが世界中の数百万の人々が参加し報酬を得る方法でネットワークデータを取得することです。それはAIデータ提供のカテゴリーを独自に創出し、これが世界のいくつかの最大のAI企業が私たちと協力する理由でもあります。それはAIのデータ層です。
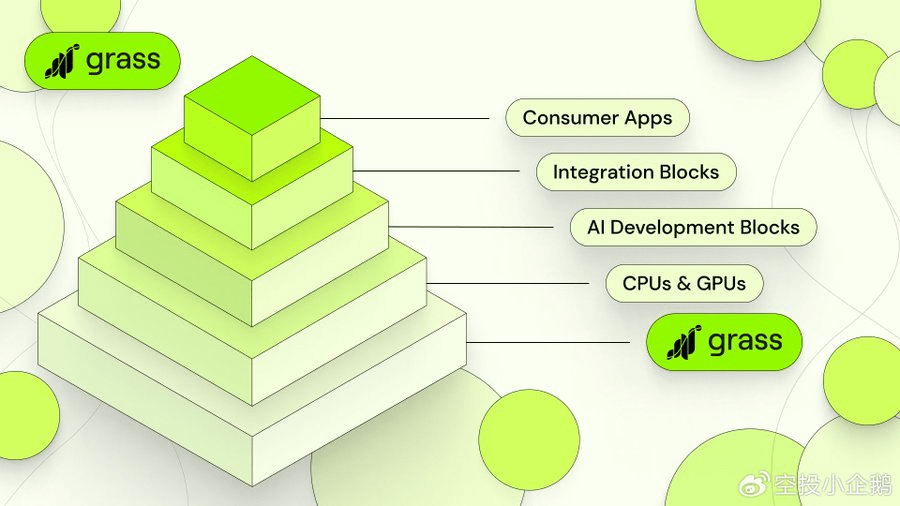
同時に、私たちは過去数週間にわたり人工知能の現在の状態について考えてきました。私たちは最も差し迫った問題は何か、AIインフラストラクチャの重要な一部として、私たちがこれらの問題を解決するために何ができるのか自問しました。
私たちの結論は、現在AIが直面している最大の問題はデータの透明性の欠如です。ニュースを見ればわかります。自問してください、なぜあるAIモデルがエロン・マスクをヒトラーと同列に扱うのでしょうか?あるいは、世界の歴史から全体の民族を抹消するのか?それは訓練時に誤ったデータを使用したからですか?それとも、もっと悪いことに、誤った答えを出すことを選択的に行う良いデータを使用したからですか?
答えは、私たちにはわからないからです。そして、私たちはそれがわからないのは知る手段がないからです。私たちはこれらのモデルがどのデータで訓練されたのかを知りません。なぜなら、それを証明するメカニズムがないからです。ユーザーがデータの出所を検証する手段がないからです。なぜなら、ビルダー自身がそれを検証する手段がないからです。
これがGrassが解決しようとしている問題であり、私たちは今その問題を解決するためのLayer 2データRollupを構築しています。あなたはどうやってそれを実現するのかと尋ねるかもしれません。
説明させてください。
Layer Twoがデータソースを構築する方法
世界はAIトレーニングデータの出所を証明する方法を必要としています。これがGrassが現在構築しているものです。すぐに、Grassノードが取得するデータは、そのデータが取得されたウェブサイトを検証するためのメタデータを記録します。その後、このメタデータは各データセットに永続的に組み込まれ、ビルダーがその出所を完全に確認できるようになります。そして、彼らはこの系譜をユーザーと共有し、ユーザーは安心してAIモデルと対話できることを確認できます。
これは重要な作業であり、毎分数千万のネットワークリクエストを取得するための作業を拡大するために、私たちのプロトコルを主要に拡張する必要があります。各リクエストは検証が必要で、これはどのL1が提供できるスループットよりも大きくなります。これが、私たちが能力の重大なアップグレードを処理するためにLayer 2ソリューションを構築する計画を発表した理由です。このL2は主権Rollupであり、ZKプロセッサを装備しており、メタデータをバッチ処理して検証し、私たちが生成する各データセットに持続的な系譜を提供します。これは、すべてのAI開発の基盤層が次の段階に進むために必要です。
これを行う利点は多くあります:それはデータ汚染に対抗し、オープンソースAI能力を与え、私たちが日常的に対話するモデルに透明性を提供します。
次に、私たちはシステムの基本設計を説明します。
Grassのアーキテクチャ
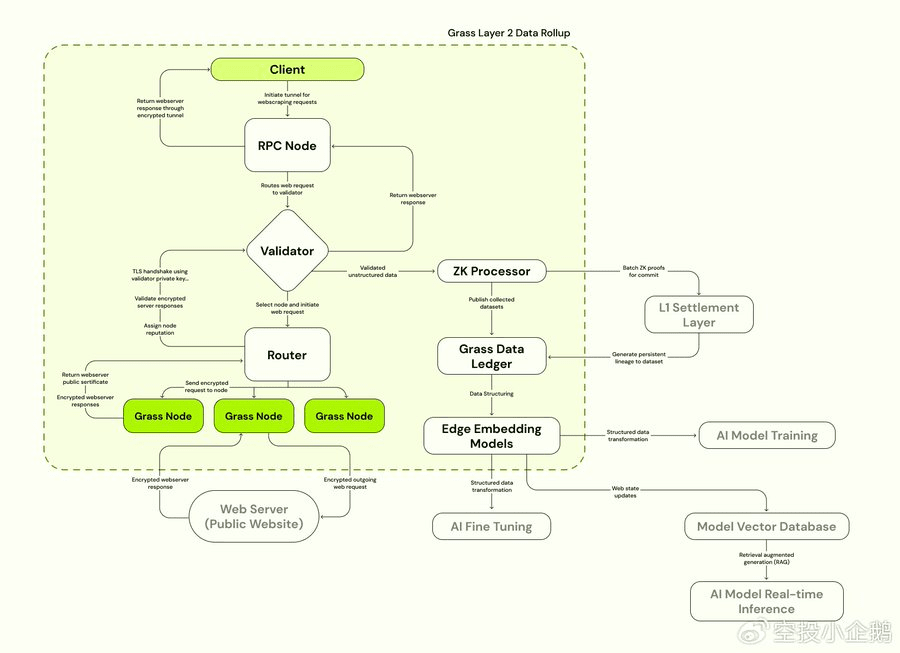
これらのアップグレードを理解する最も簡単な方法は、GrassデータRollupの図を参照することです。左側には、クライアントとWebサーバーの間にGrassのネットワークが表示され、従来の定義のように見えます。クライアントはネットワークリクエストを発出し、バリデーターを通じて最終的にGrassノードを経由してルーティングされます。クライアントがリクエストしたウェブサイトのサーバーはネットワークリクエストに応答し、そのデータが取得され、ラインに送信されることを許可します。次に、データはクリーンアップされ、処理され、次世代AIモデルの訓練に使用されるために準備されます。
L2グラフでは、右側に2つの主要な追加部分があり、Grassの主権Layer 2の導入に伴い追加されます:Grassデータ台帳とZKプロセッサ。
これら二つはそれぞれ独自の機能を持っているため、私たちはそれらを一つずつ説明します。
Grassデータ台帳
データ台帳はGrass上のすべてのデータの最終的な保存場所です。それはGrass上で取得されたデータセットの永続的な台帳であり、今や起源の瞬間からその血統を記録するためのメタデータが組み込まれています。各データセットのメタデータ証明はSolanaの決済層に保存され、決済データ自体も台帳を通じてアクセス可能になります。Grassが取得したデータを保存する場所の重要性には注意が必要ですが、私たちはすぐにこれについて話します。
ZKプロセッサ
上記で述べたように、ZKプロセッサの目的はGrassネットワーク上で取得されたデータセットの出所を記録するのを助けることです。このプロセスを想像してみてください。
ネットワーク上のノードが - 言い換えれば、Grassの拡張機能を使用しているユーザーが - 指定されたウェブサイトにネットワークリクエストを送信すると、それはノードがリクエストしたすべてのデータを含む暗号化された応答を返します。すべての目的において、これが私たちのデータセット誕生の瞬間であり、記録が必要な起源の瞬間です。
そして、これが私たちがメタデータを記録する際に捉えた瞬間です。それは多くのフィールドを含んでいます - セッションキー、取得したウェブサイトのURL、ターゲットウェブサイトのIPアドレス、取引のタイムスタンプ、もちろんデータ自体も含まれます。これは特定のデータセットがその主張するウェブサイトから来ていることを疑いなく確認するために必要なすべての情報であり、したがって特定のAIモデルが正しく - かつ忠実に - 訓練されていることを確実にします。
ZKプロセッサの役割は、これらのデータがチェーン上で決済される必要があるためですが、私たちはこれらのデータがすべてSolanaのバリデーターに見えることを望んでいません。また、将来Grass上で実行されるネットワークリクエストの数が膨大になることは、いかなるL1のスループット能力を超えることが避けられないでしょう - たとえそれがSolanaのような強力なL1であっても。Grassはすぐに数千万のネットワークリクエストを毎分実行するレベルに拡張され、各リクエストのメタデータがチェーン上で決済される必要があります。ZKプロセッサが証明を作成し、最初にそれらをバッチ処理しなければ、これらの取引をL1に提出することは不可能です。したがって、L2は私たちが設定した目標を達成する唯一の可能な方法です。
今、なぜこれは大きな問題なのか?
Layer 2の利点
データ台帳
データ台帳の重要性は、Grassの拡張を別の - そして根本的に異なる - ビジネスモデルに引き上げることです。プロトコルは自分自身でネットワークリクエストを送信し、ネットワーク上で自分のデータを取得するバイヤーを引き続き審査しますが、その活動の増加の一部は台帳に保存されているデータに関連することになります。この能力を持つことで、Grassは現在LLM訓練に使用されるデータを戦略的に取得し、拡大し続けるデータストレージにホストすることができます。
このストレージはモジュラーAIスタックのデータ層であり、ビルダーが無限に異なるモデルを訓練するための部分を選び出すことができます。これは本質的にインターネットの縮小モデルであり、構造化され、AIが摂取する準備ができたトレーニングデータを提供します。
ZKプロセッサ
私たちはZKプロセッサが重要である理由を詳細に説明しました。Grassデータセットの出所を記録するメタデータの証明を作成することを可能にすることで、それはビルダーとユーザーにAIモデルが実際に正しく訓練されているかどうかを検証するためのメカニズムを提供します。これはそれ自体が大きなことです。
しかし、私たちが以前に言及しなかった一つの事があります。
データセットの出所を記録するウェブサイトの他に、メタデータはデータセットがネットワーク上を通過したノードも示します。特に、これはノードがネットワークを取得するたびに、彼らの作業に対するクレジットを得ることができることを意味しますが、彼らの身元に関する情報は漏れません。
今、なぜこれが重要なのか?
これは重要です。なぜなら、どのノードがどの作業を完了したかを証明できるようになると、彼らに比例して報酬を与え始めることができるからです。あるノードは他のノードよりも価値があります。あるノードは彼らの同僚よりも多くのデータを取得します。そして、これらこそが過去数ヶ月で見られたネットワークの急速な拡張を促進するためにインセンティブを与える必要があるノードです。私たちはこのメカニズムが世界で最も需要のある地域への報酬を著しく向上させ、最終的にはこれらの場所の人々が登録し、ネットワークの容量を指数関数的に増加させることを奨励すると信じています。
言うまでもなく、ネットワークが大きくなればなるほど、私たちの取得能力も大きくなり、私たちが保存するネットワークデータのストレージも大きくなります。正のフィードバックループが不可避に生じ、より多くのデータが意味するのは、私たちがトレーニングデータを必要とするAIラボに提供できるものが増えるということです - それによってネットワークの持続的な成長を促進します。
結論
全体として、今日の人工知能分野におけるほとんどの顕著な問題は、モデルの訓練方法に対する可視性の欠如に起因しています。私たちは、オープンソース人工知能にデータソースを検証するシステムを与えることによってこれを解決できると信じています。私たちの解決策は、史上初のLayer 2データロールアップを構築することであり、すべてのデータセットの出所を記録するメカニズムを導入することを可能にします。
これらのデータのZK証明はL1決済層に保存され、メタデータ自体は最終的にはその基となるデータセットに関連付けられます。これらのデータセット自体は私たちのデータ台帳に保存されています。GrassはモジュラーAIスタックにデータ層を提供し、これらの発展はノードプロバイダーにより大きな透明性と報酬をもたらします。これらの報酬は彼らが実行する作業量に比例します。
この更新は私たちが間もなく発表するいくつかのプロジェクトを伝え、私たちの決定を推進する考えを明確にするのに役立つはずです。私たちはAIをより透明にするプロセスに関与できることを嬉しく思い、私たちの製品が将来どのような多くのアプリケーションシナリオを持つ可能性があるのかに興奮しています。これらのアップグレードは開発者たちに広大な機会を提供しますので、もしあなたやあなたのチームがGrass上で開発に興味があるなら、Discordで私たちに連絡してください。あなたのサポートに感謝し、引き続き注目してください。
人工知能革命で利益を得る。