
AIに最適なコンピューティングインフラの選び方
多くのAIチームは、コンピューティングプロバイダーの選び方を間違えています。
H100の時間単価を比較し、プロバイダーのランキングを調べて、最も安い選択肢を選びます。半年後には、容量制限やコストの上昇、ベンダーロックインに悩まされています。
問題は何でしょうか?コンピューティング環境の選定は、GPUの価格だけでなく、ワークロードの要件に基づいて行うべきです。
より良い選定方法をご紹介します。
1. まず、適切な質問をする
プロバイダーを選ぶ前に、次の5つの点を検討しましょう。
- ワークロード:バッチ学習か、低レイテンシの推論か?
- 予算:実験的な支出ですか、それとも予測可能な大規模需要ですか?
- DevOps:チームは複数のインフラプロバイダーを管理できますか?
- コンプライアンス:HIPAA、SOC 2、または地域ごとのデータ管理が必要ですか?
- スケーラビリティ:需要が突然10倍に増加しても、インフラで対応できますか?
これらの答えによって、適切なコンピューティングモデルが決まります。
2. 3つのコンピューティングモデルを理解する
ハイパースケーラー(AWS/GCP):成熟したエコシステム、強力なコンプライアンス、統合ツールを備えています。ただし、料金が高く、データ転送料が発生し、GPUの割り当て承認に時間がかかることがよくあります。
ネオクラウド:競争力のあるGPU料金と、未加工のコンピューティングリソースへの迅速なアクセスを提供します。ただし、単一プロバイダーの供給能力への依存度が高まる可能性があります。
集約型コンピューティング基盤(GPU.net):統合マーケットプレイスを通じて分散GPUの供給をつなぎ、より幅広い容量へのアクセス、競争力のある料金、柔軟なスケーリングを実現します。
各モデルは異なるニーズに応えます。目標は、不要なインフラ上の制約を避けることです。
3. 学習と推論は同じではない
これは、AIチームが犯す最もコストのかかる間違いの1つです。
学習には、高性能なGPUクラスター、NVLinkなどの高速インターコネクト、効率的なバッチ処理が必要です。
推論には、低レイテンシ、地理的な分散、迅速な起動、高可用性、トークンあたりのコスト最適化が必要です。
学習は集中的なフェーズで行われます。一方、推論はユーザーがAI製品を利用する限り継続します。
インフラ戦略では、その両方を考慮する必要があります。
4. インフラを段階的に拡張する
- PMF達成前:オンデマンドのコンピューティングリソースを優先しましょう。需要が不確かなうちは、長期契約を避けましょう。
- 初期成長期:学習用と推論用のクラスターを分離しましょう。予約容量を検討する前に、60日間の支出を分析しましょう。
- 本番規模:移植可能なデプロイ、オープンなコンテナ標準、マルチプロバイダーのインフラを活用し、単一ベンダーへの依存を減らしましょう。
まだ実現していない会社のために、インフラを構築してはいけません。
5. GPU.netの位置づけ
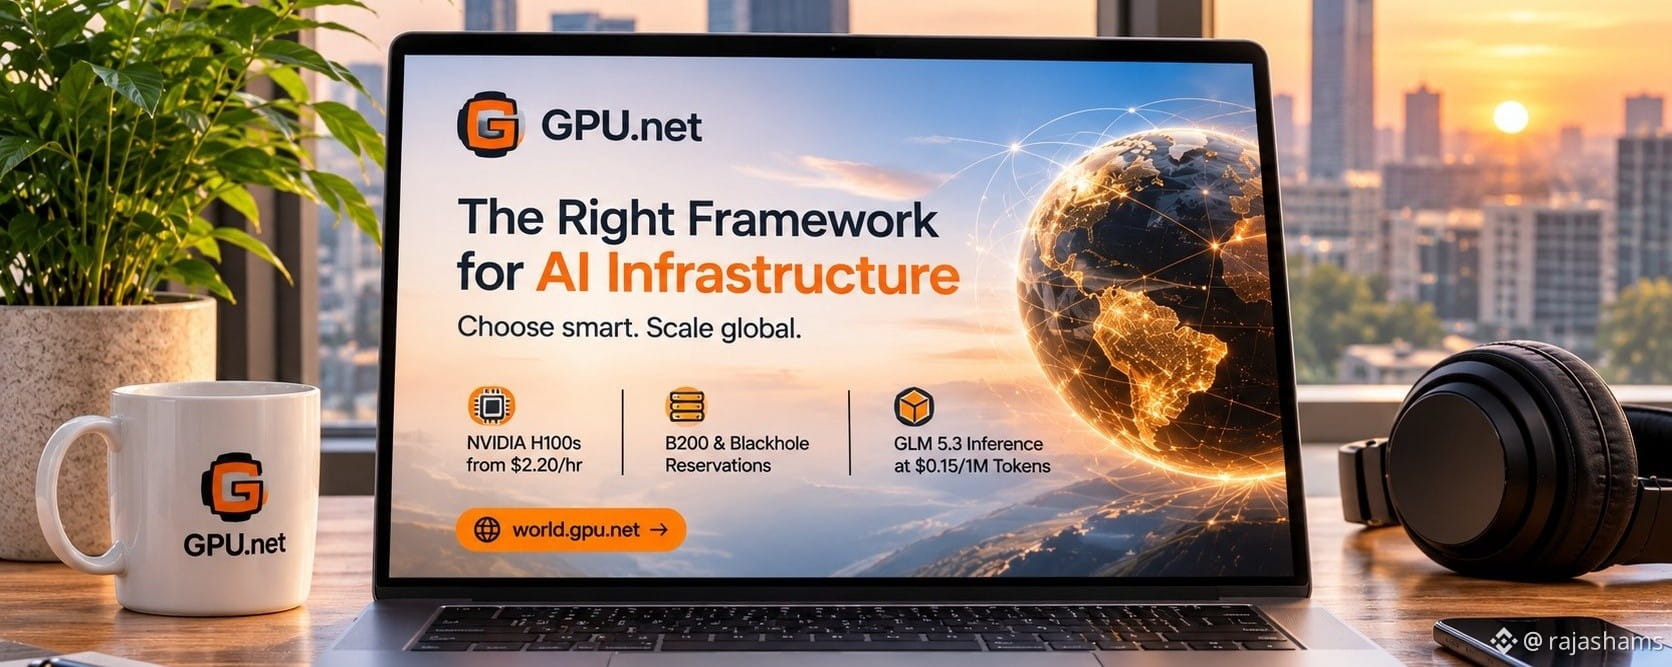
GPU.netは、分散型GPU容量とAIサービスを1つのエコシステムに集約します。
提供内容:
- NVIDIA H100 GPUを1時間あたり2.20ドルから。
- B200およびBlackwellの予約オプション。
- 100万トークンあたり0.15ドルの、OpenAI互換GLM 5.3推論。
より広範なエコシステムでは、GPUコンピューティングをホスト型モデル、AIエージェント、GPU関連の利回り機会にも結び付けています。
より大きな視点
AIインフラの未来を、単一のクラウドプロバイダーが決めることはありません。
コスト、地域、可用性、レイテンシに応じて、ワークロードがグローバルなコンピューティングリソースにどれだけ効率よくアクセスできるかによって決まります。
競争優位性は、単により多くのGPUを所有することではありません。適切なコンピューティングリソースに、適切なタイミングとコストでアクセスすることです
GPU.netのエコシステムを見る:https://world.gpu.net/
#AI #GPU #DePIN #AIインフラ #C#cloudcomputing #Aİ #CloudInfrastructure #GPURental #DePIN