一块六年前买的 RTX 3090,被人往寄存器里写了两个数,矩阵算力从 77.5 跳到 129.6 TFLOPS。
这不是超频。
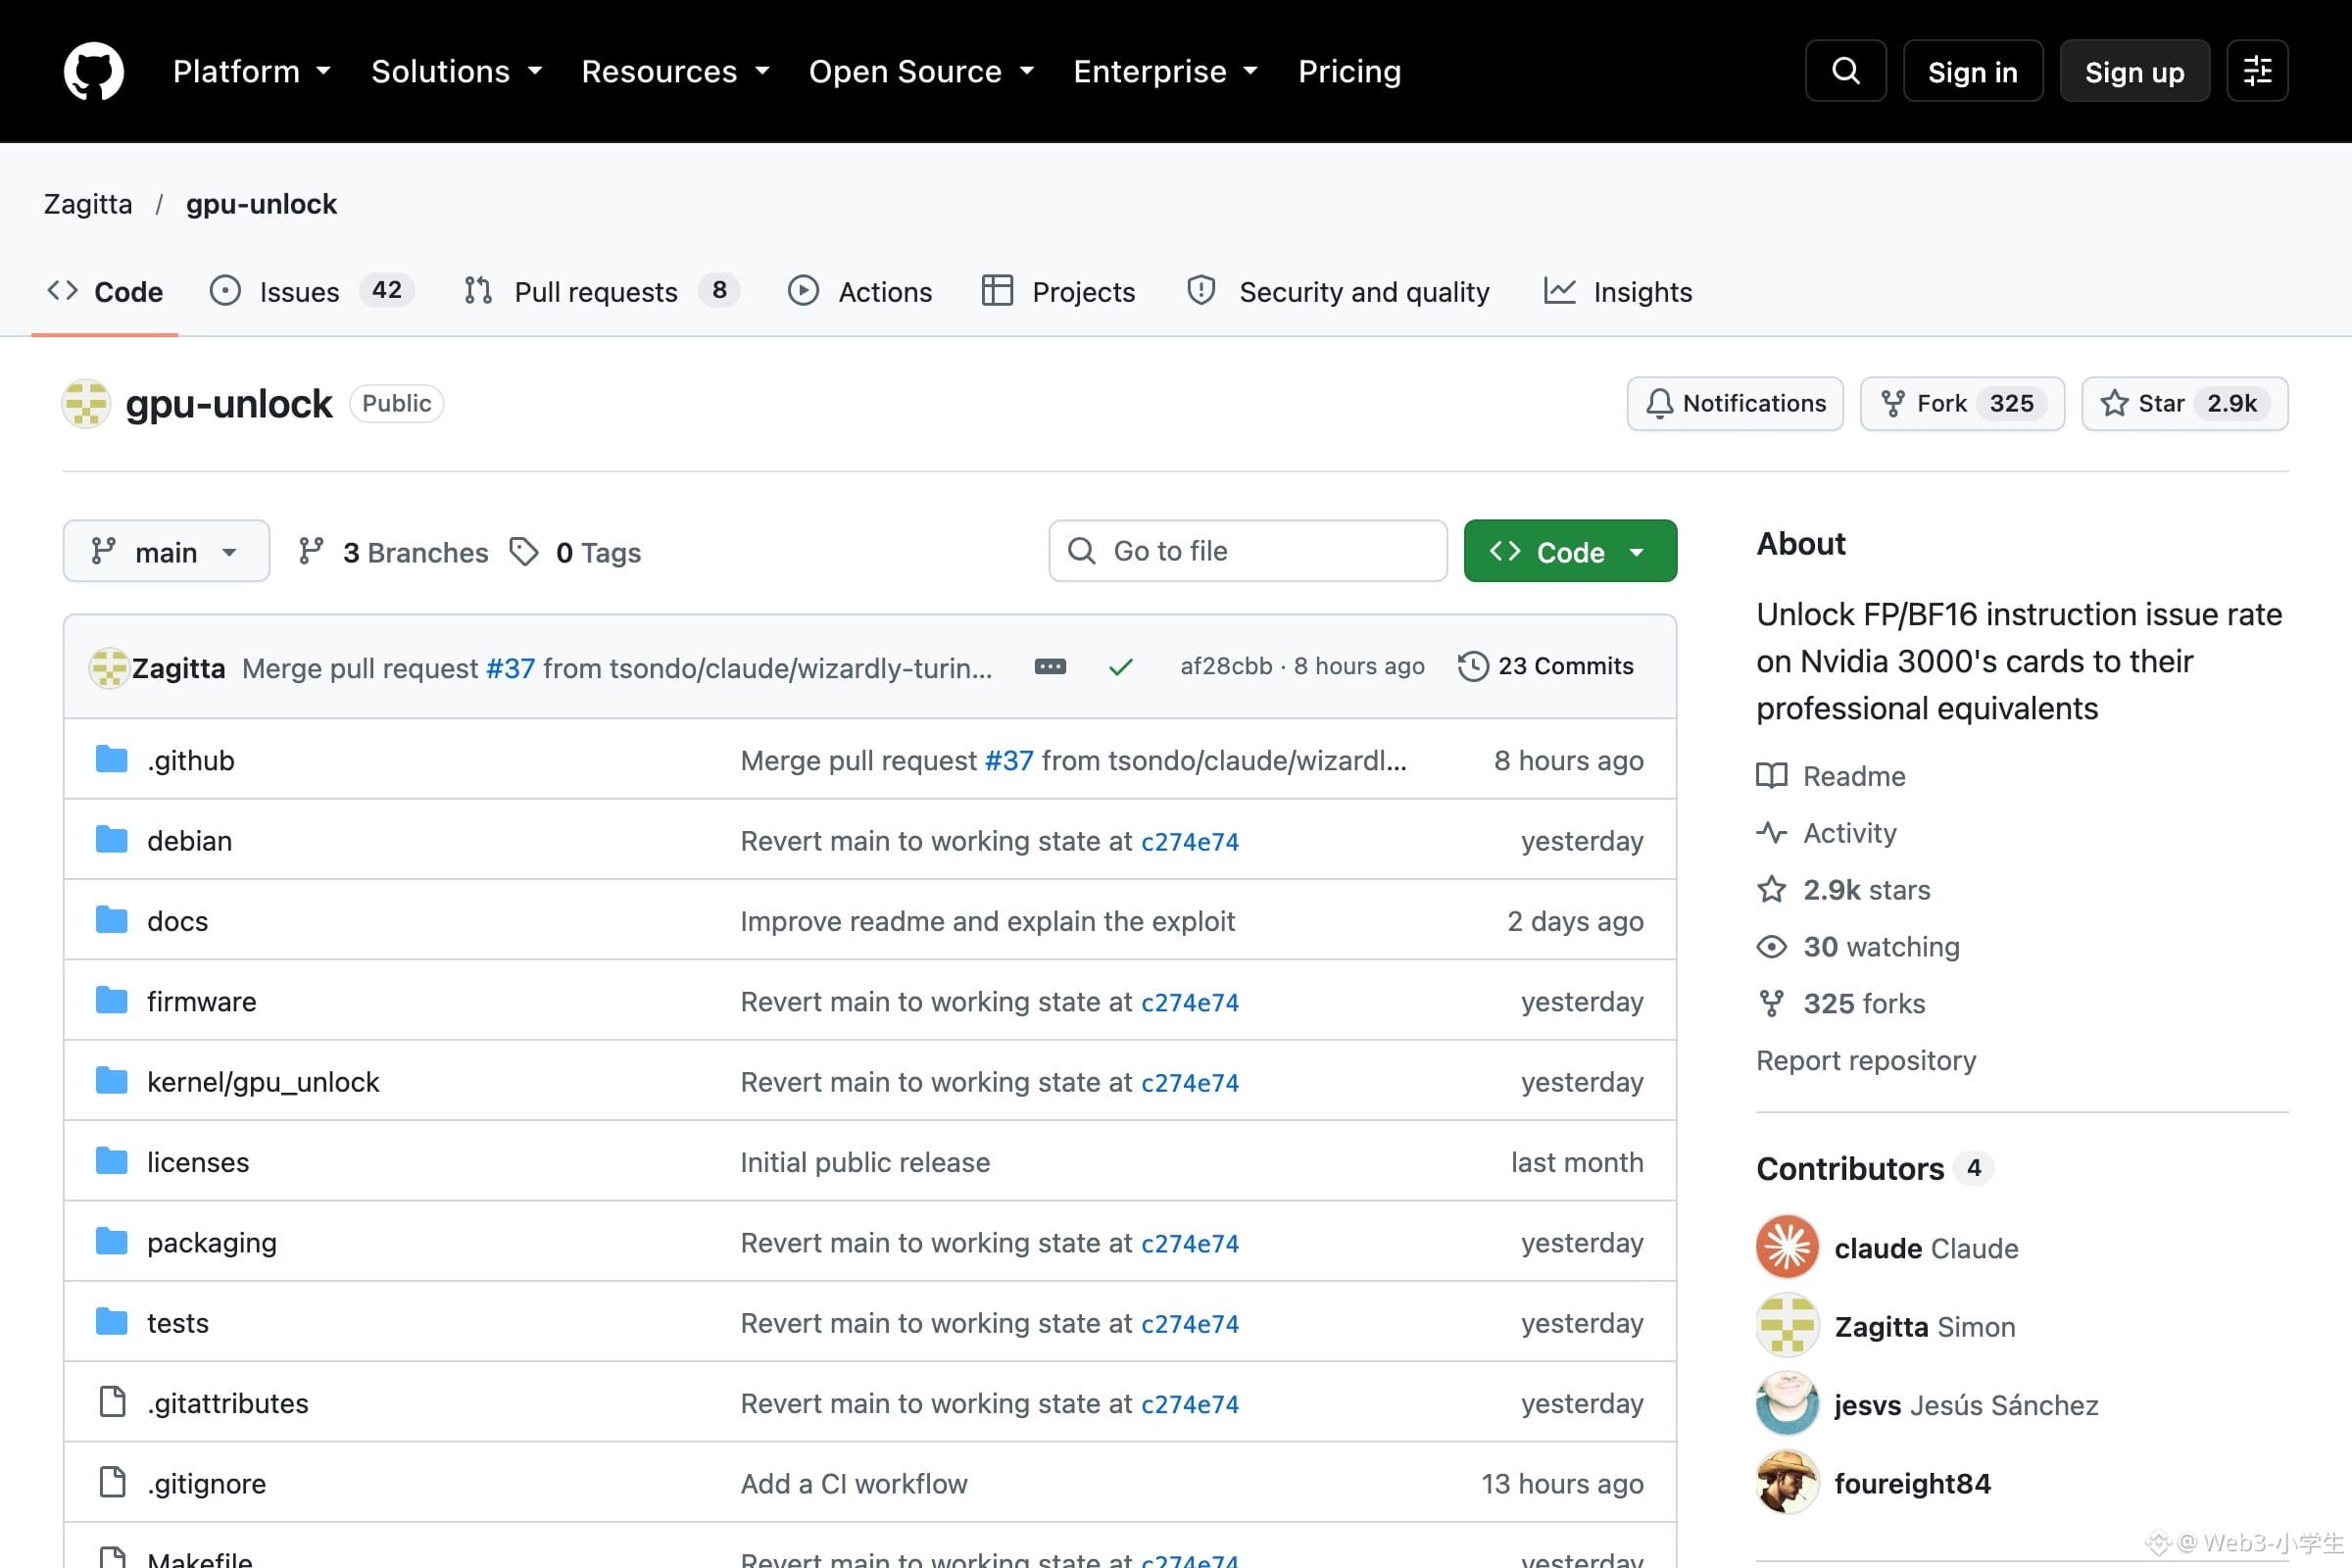
干这件事的人叫 Zagitta,项目挂在 GitHub 上,名字就叫 gpu-unlock。它不是一个改过的驱动,是一个 Linux 内核模块,抢在英伟达认领这块卡之前挤进去,把硬件里两个负责选速度的寄存器改掉,重置一次 GPU,再把卡原样还回去。
两个值,一个填满八个 8,一个只填一个 8。真就这么简单。
不刷 VBIOS,不装改版固件。英伟达以后每更新一次,都不用重新破一次。
很多人以为这是超频,或者破解。其实都不是。卡上的算力从来没少过,被按住的是那几条指令的发射速率,FP16 和 BF16,带 FP32 累加的矩阵乘。开发者说,消费卡上这几条指令只跑专业卡的一半速度。
同一块芯片,一半的速度是出厂设置。
这就得算一笔账。GA102,两百八十三亿个晶体管。RTX 3090 首发一千四百九十九美元,RTX A6000 首发四千六百五十美元,两张卡发布只隔十一天。规格差在哪?CUDA 核心多百分之二点四,显存多一倍,多个 ECC。就这些,三千一百五十一美元。
$NVDAB 那条产品线切价签的老规矩,靠的从来不是物理限制。
社区报上来的数字更直白。3090 Ti 的 BF16 从 87.5 涨到 157.4,八成。3070 涨七成到八成。
偏偏功率上限压在 225 瓦的卡只涨两成半。显存带宽压根没动。CUDA 核心没多一个。游戏帧率没人测出提升。
跑大模型的时候,长提示词处理快了三成多,生成 token 的速度基本没变,那一段堵在显存上,不堵在算力上。
这套手艺不是新学的。2021 年英伟达为了挡挖矿,做过一批 CMP 专用矿卡,把哈希率锁死。矿难之后,有人把 CMP 的锁解回去当普通显卡卖,用的就是那套 V67 和 PLM 的手法。挖矿那几年买过卡的人,账上都记着,$BTC 的算力涨一档,二手卡跟着涨一档,那会儿没人觉得性能是物理常数。
今天同一套手法换了个靶子。锁的不再是哈希率,是 Tensor Core。
本地跑图的人倒是先吃到这一口。一张 3090 Ti 在 ComfyUI 里,BF16 的出图吞吐涨了四成七到五成九,出图结果逐位一致,不是拿画质换速度。$RNDR 这类把闲置显卡挂出去接活的平台,供给端成本直接往下掉一截。
2021 年按算力租过云 GPU 的人,账单里有一部分,是在替这道锁付钱。
我琢磨的是英伟达的态度。到现在没有官方回应,会不会推个补丁把这口子堵上,没个准话。另外这半速差到底烧在硅里,还是写在固件里,开发者只说是寄存器,更深的证据没给。
还有个反例,正好说明这件事没那么整齐,OEM 专供的 3080 Ti 二十 G 版本,解锁流程跑通了,BF16 愣是没动。同一把钥匙,有的锁开得开,有的开不开。
真正值得记住的不是这六成七。
任何把同一块硅按用途切成几档卖的设计,到头来都会被人从寄存器那头翻回来。
因为锁写在配置里,不写在沙子里。
卡还是那块卡。价签不是了。
二手 3090 的报价这几天要动。准备买新卡的人,可以等英伟达自己解释一遍再说。
#英伟达 #美股 #币安广场