最近、@Acurast の NodeGhost 技術事例を見ていて、興味深いテスト結果を見つけました。
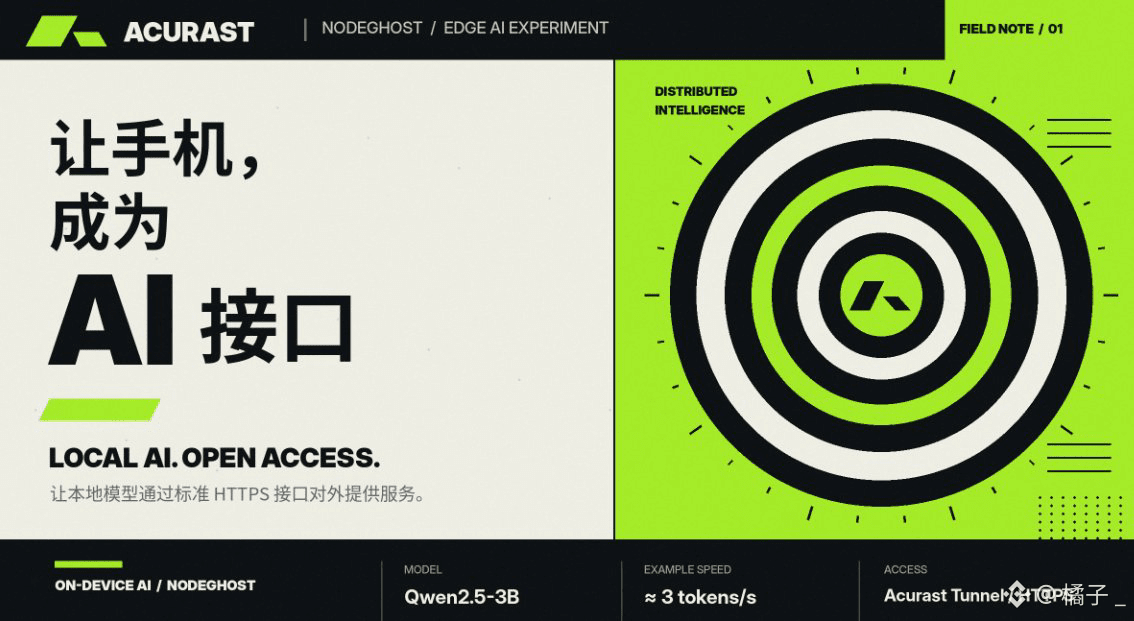
量子化した Qwen2.5-3B モデルをスマートフォン1台で実行すると、生成速度は毎秒約3トークン。
約120トークンの回答に、45秒ほどかかります。
今日の大規模モデルの使用感と比べると、確かに少し遅いです。
ただ、この事例で私が注目したのは、別の設計です。
Acurast Tunnel を使えば、もともとスマートフォン内にあり、パブリックIPアドレスを持たないモデルでも、外部にHTTPSインターフェースを提供できます。
さらに、NodeGhost の OpenAI API互換機能を使えば、開発者は従来の呼び出し方法をほとんど変更することなく、リクエストをスマートフォンに送って実行できます。
これにより、スマートフォンはネットワーク上でタスクの割り当てを待つだけの受動的な Processor ではなく、標準化されたAI推論サービスを外部に提供することもできます。
もちろん、現時点でこの事例は Canary ネットワーク上の参考実装であり、速度と複雑な推論能力には明らかな制限があります。
それでも、すでにとても実用的な問いに答えていると思います。
開発者が自分のモデルを分散型のスマートフォン上にデプロイしたい場合、既存のアプリから簡単に呼び出せるのか?
少なくとも、この技術的な道筋にはすでに実行可能な事例があります。
商用化については、レイテンシ、同時実行数、コスト、長期的な安定性を引き続き検証する必要があります。
Acurast の $ACU は、ネットワークの利用と計算リソースへのインセンティブをつなぐ役割を担いますが、最終的に有料の需要を呼び込めるかどうかは、こうしたアプリに実際の競争力があるかにかかっています。
量子化した Qwen2.5-3B モデルをスマートフォン1台で実行すると、生成速度は毎秒約3トークン。
約120トークンの回答に、45秒ほどかかります。
今日の大規模モデルの使用感と比べると、確かに少し遅いです。
ただ、この事例で私が注目したのは、別の設計です。
Acurast Tunnel を使えば、もともとスマートフォン内にあり、パブリックIPアドレスを持たないモデルでも、外部にHTTPSインターフェースを提供できます。
さらに、NodeGhost の OpenAI API互換機能を使えば、開発者は従来の呼び出し方法をほとんど変更することなく、リクエストをスマートフォンに送って実行できます。
これにより、スマートフォンはネットワーク上でタスクの割り当てを待つだけの受動的な Processor ではなく、標準化されたAI推論サービスを外部に提供することもできます。
もちろん、現時点でこの事例は Canary ネットワーク上の参考実装であり、速度と複雑な推論能力には明らかな制限があります。
それでも、すでにとても実用的な問いに答えていると思います。
開発者が自分のモデルを分散型のスマートフォン上にデプロイしたい場合、既存のアプリから簡単に呼び出せるのか?
少なくとも、この技術的な道筋にはすでに実行可能な事例があります。
商用化については、レイテンシ、同時実行数、コスト、長期的な安定性を引き続き検証する必要があります。
Acurast の $ACU は、ネットワークの利用と計算リソースへのインセンティブをつなぐ役割を担いますが、最終的に有料の需要を呼び込めるかどうかは、こうしたアプリに実際の競争力があるかにかかっています。