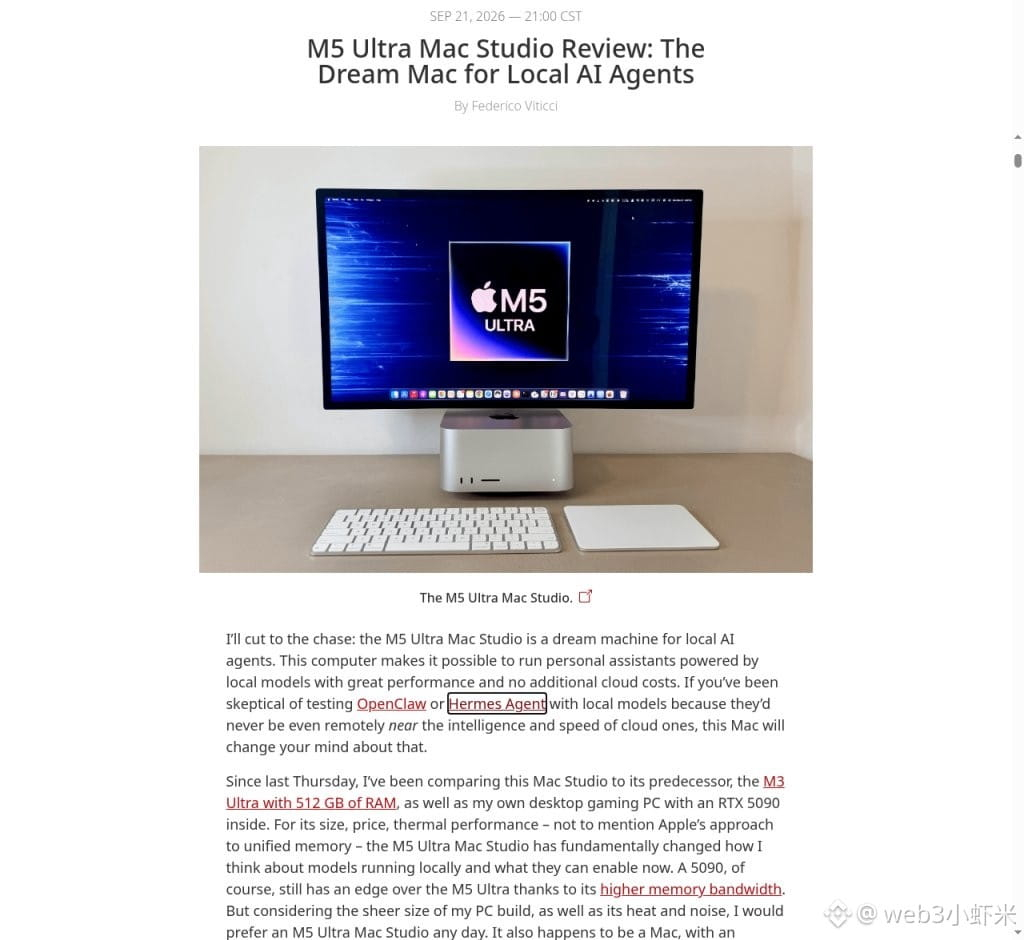
MacStories を“刷った”:編集部が実機テスト——最上位構成の M5 Ultra Mac Studio(256GB ユニファイドメモリ)でローカル AI エージェントを動かすと、彼は「今の普段使いのアシスタントってデフォルトで全部ローカルモデルに接続されてる。Open Minis や Hermes はもうクラウド側の請求は出ない」と言っていました。
前世代の M3 Ultra と比べて、プロンプトの前処理はだいたい約 2.5 倍速。生成速度は平均で約 70% 速いです。短いプロンプトだと Qwen3.8-Flash-Next は約 100 token/秒を通し、64K~256K の長いコンテキストでもだいたい 60~85 を安定して維持します。さらに 256GB メモリなら Flash-Next を同時に 3 本重ねてもいけます。
RTX 5090 と比べると、5090 は演算性能と帯域幅がまだ上。ですが VRAM は 32GB しかなく、大規模モデルを使うとすぐにシステムメモリを引きずる必要が出ます。Mac のユニファイドメモリはより静かで、もっと大きいモデルを詰め込めます。ローカルエージェントが、ようやく“ロード待ち”みたいな動きじゃなくなってきました。
#AI #Apple #ローカルモデル