誰かが「スタークラフト」AI対戦テスト(Brood War Bench)を行い、いま主流の大規模言語モデル同士でリアルタイムストラテジーを即席対戦させたところ、どのモデルも初心者の域を超えられなかった。
『スタークラフト:ブリュード・ウォー』は1998年の名作リアルタイムストラテジーで、AI研究の古くからの協力者でもある。2019年のDeepMindのAlphaStarは、このゲームでプロ選手に勝ったことがある。だがそれは専用に訓練された強化学習AIだった。今回のテストは違う。汎用の大規模モデルをAIエージェントとしてそのまま操作させ、基地を自分で建て、兵を作り、戦えるのかを確かめたのだ。
作者のBen Swerdlowは当初、「エージェント操作だけでプレイできる」スタークラフトのバージョンを作って、友人と遊ぶつもりだった。ところが、ほとんどスタークラフトをやったことがない友人たちがなかなか健闘したのだ。彼らは「『攻めろ』って命令したら、エージェントが自分で小規模な部隊を作って突っ込んでいった」と言っていた。そこで彼は疑問に思う。「AIを完全に自分で遊ばせたら、どこまでのレベルに到達するのだろう?」
答えはこうだ:下手だが、とても面白い。
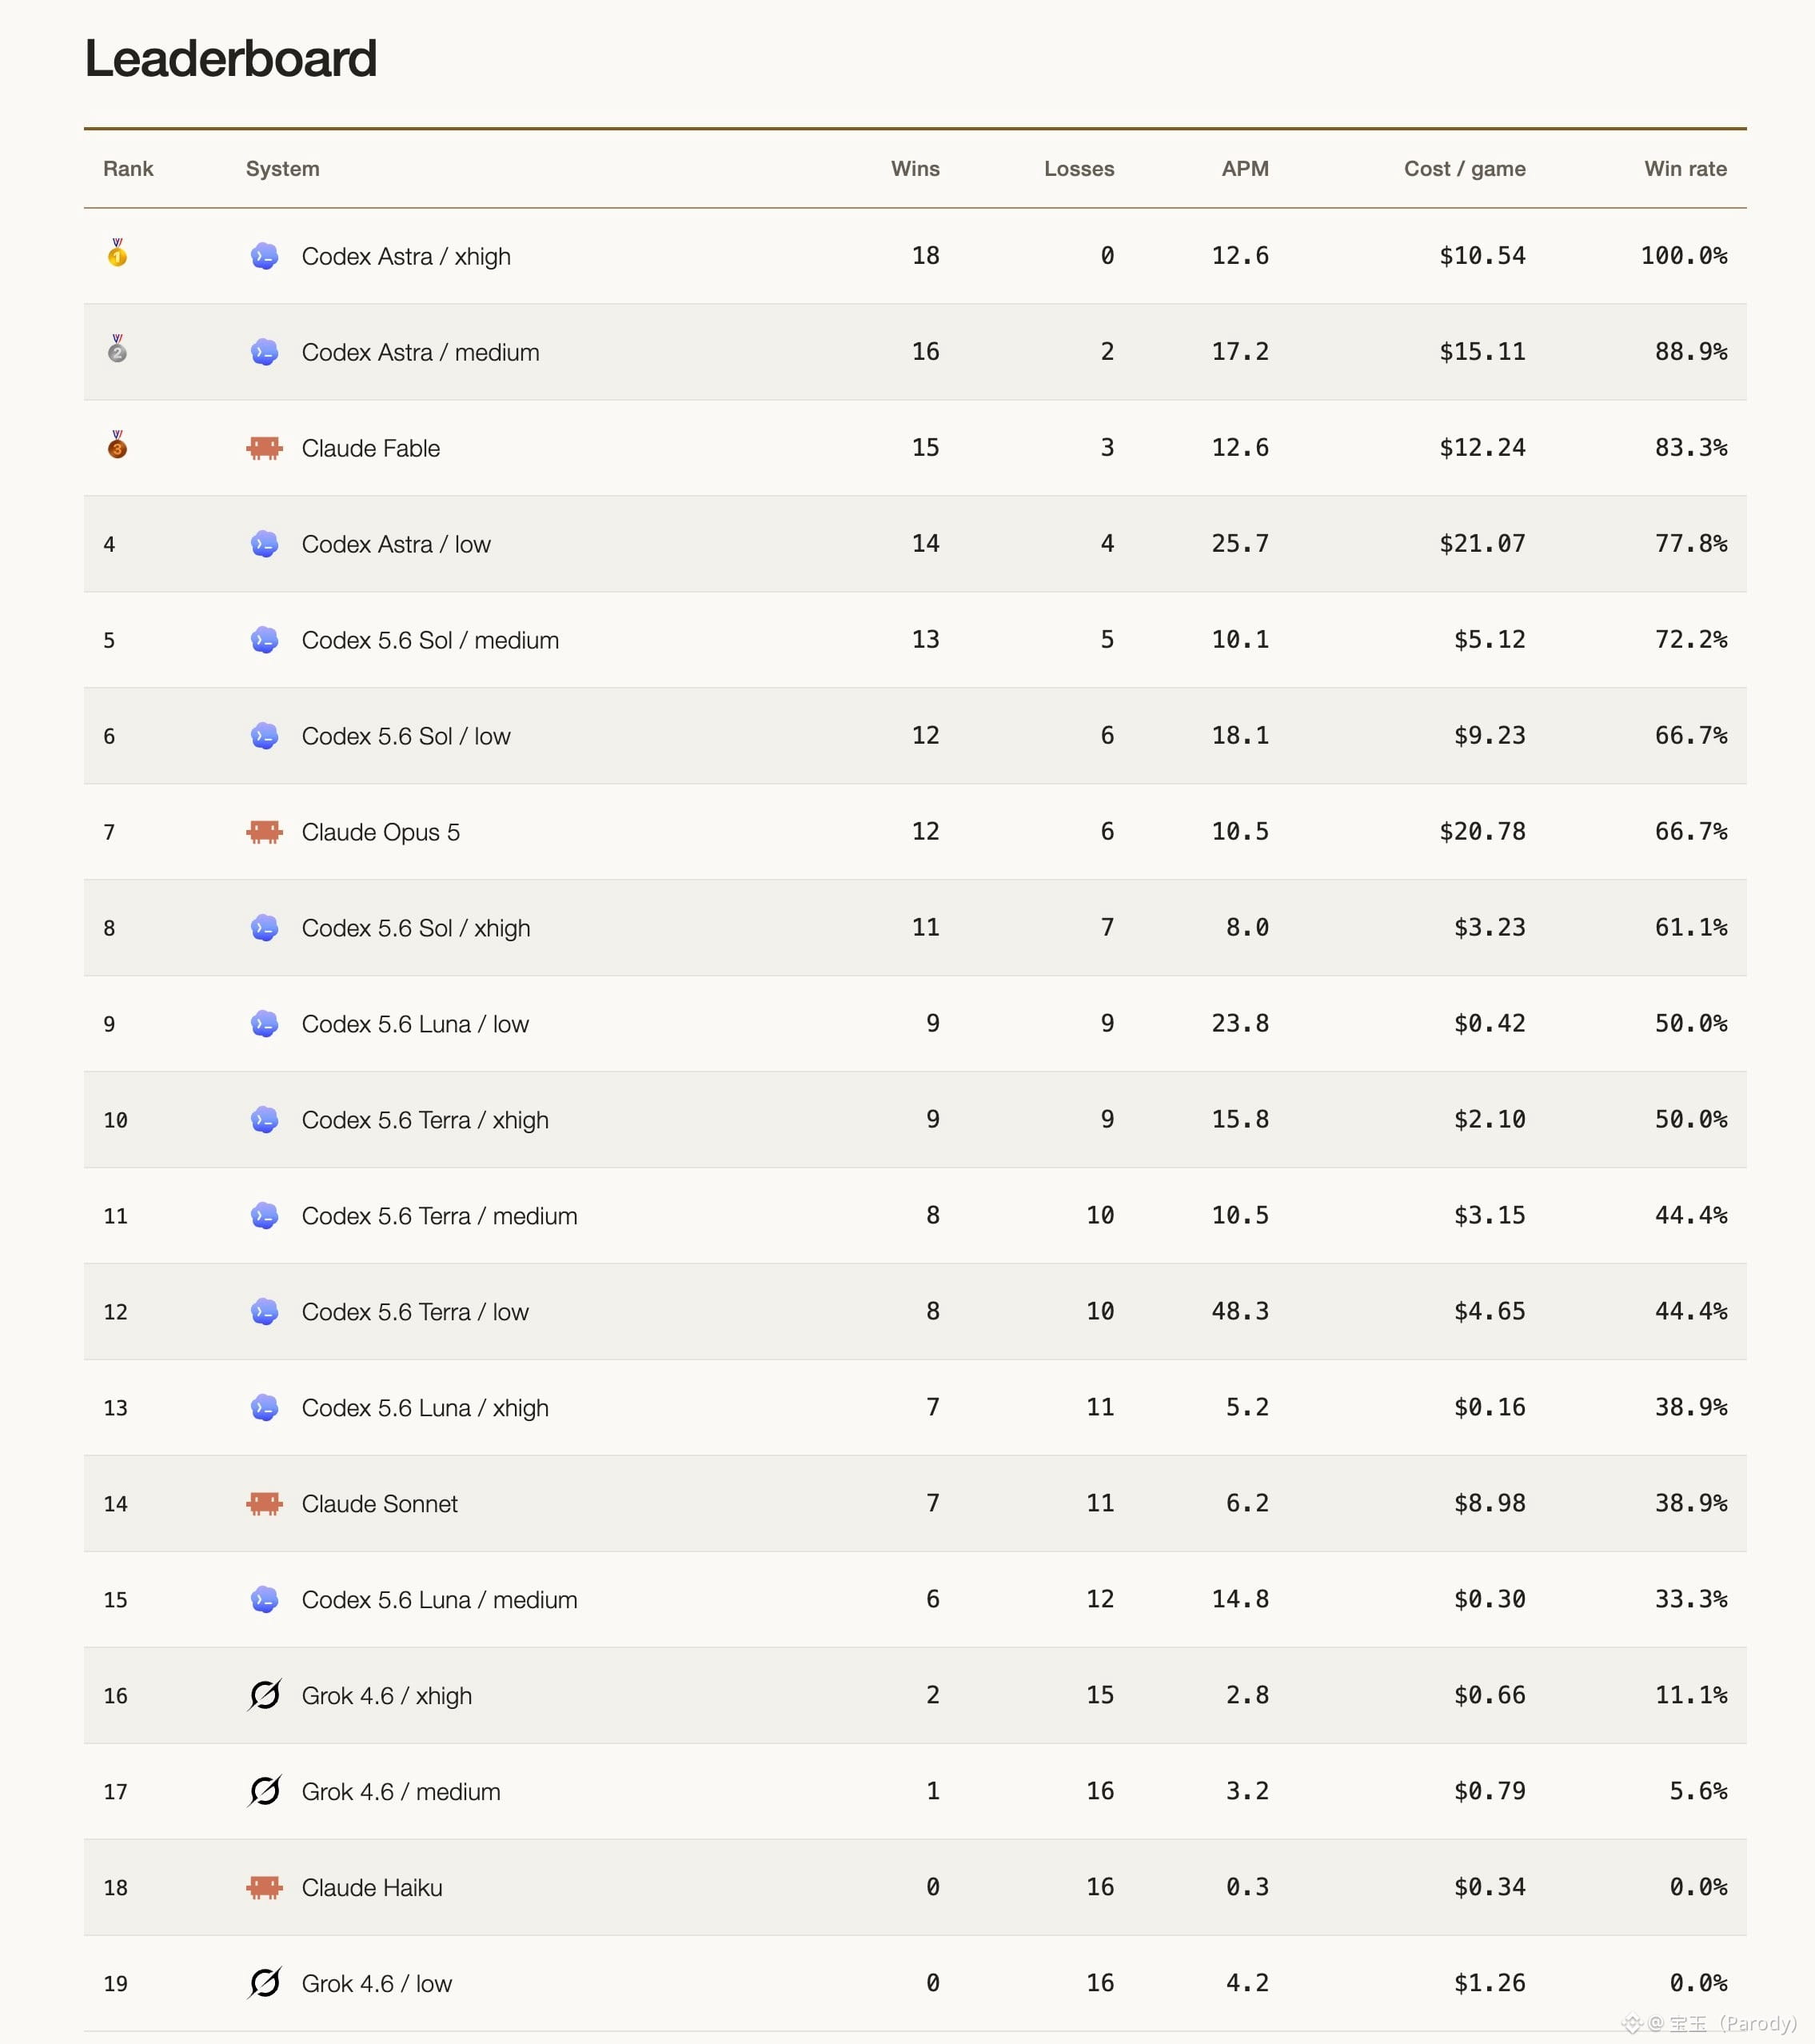
1位のCodex Astraは18戦全勝したが、得意なのは正面での撃ち合いではない。いわゆる「攪乱」だ。採掘係のワーカー(Probe)を相手の基地に送り込み、妨害する。この手はAIの対戦相手に特に効く。相手のエージェントはワーカーが来たのを見ると、何をすべきか数十秒考え込む。その間、何もせずに止まってしまう。一方で、きちんとした経済の発展や大規模な戦闘では、Codexはやや弱く、兵を1体か2体作っては相手に投げてしまい、十分な戦力をためてから出撃する、ということができないことが多い。
Claude Fableは3位で勝率83.3%。参加したモデルの中で最も「本気でゲームをしている」タイプだ。経済をきちんと育て、テクノロジーツリーを進めることもでき、ある試合ではウルトラリスク(Mutalisk)を作り、別の試合では聖堂武士(Taldor?)の技術まで研究していた。もちろん、研究に手間取って兵力が追いつかないこともある。それでも少なくとも「ゲームのルールを理解しようとしている」点では、Fableは誰よりも真面目だ。
Grokの成績が最も悪い。Grok 4.6は43分の試合で11000以上の推論トークンを出力したのに、操作指令はわずか6回しか出さず、終始戦闘ユニットを1体も作らなかった。本質的にはリアルタイムストラテジーをターン制のゲームのように扱い、ずっと考えてばかりで、手を動かすのを忘れているのだ。
このテストが明らかにした核心の問題は、現在の大規模モデルが、継続的な観察、素早い意思決定、多スレッド協調を要するリアルタイム環境に対して、まだまだ実用的でないことだ。最高のモデルでさえ、たとえば「フォトン砲の最速ラッシュ」(最も基本的な急襲戦術)を仕掛ける人間の初心者なら、全試合に勝ててしまう。逆に言えば、これらのモデルは建設、採掘、攻撃といった基本概念の理解はすでにできている。ただ、実行のリズムや複数タスクの協調になると、はるかに差が出てしまう。
テストのコードと対戦プラットフォームはすでに公開されており、誰でも自分のエージェントを持ち込んで1試合行える。URLは http://bw.swerdlow.dev だ。
『スタークラフト:ブリュード・ウォー』は1998年の名作リアルタイムストラテジーで、AI研究の古くからの協力者でもある。2019年のDeepMindのAlphaStarは、このゲームでプロ選手に勝ったことがある。だがそれは専用に訓練された強化学習AIだった。今回のテストは違う。汎用の大規模モデルをAIエージェントとしてそのまま操作させ、基地を自分で建て、兵を作り、戦えるのかを確かめたのだ。
作者のBen Swerdlowは当初、「エージェント操作だけでプレイできる」スタークラフトのバージョンを作って、友人と遊ぶつもりだった。ところが、ほとんどスタークラフトをやったことがない友人たちがなかなか健闘したのだ。彼らは「『攻めろ』って命令したら、エージェントが自分で小規模な部隊を作って突っ込んでいった」と言っていた。そこで彼は疑問に思う。「AIを完全に自分で遊ばせたら、どこまでのレベルに到達するのだろう?」
答えはこうだ:下手だが、とても面白い。
1位のCodex Astraは18戦全勝したが、得意なのは正面での撃ち合いではない。いわゆる「攪乱」だ。採掘係のワーカー(Probe)を相手の基地に送り込み、妨害する。この手はAIの対戦相手に特に効く。相手のエージェントはワーカーが来たのを見ると、何をすべきか数十秒考え込む。その間、何もせずに止まってしまう。一方で、きちんとした経済の発展や大規模な戦闘では、Codexはやや弱く、兵を1体か2体作っては相手に投げてしまい、十分な戦力をためてから出撃する、ということができないことが多い。
Claude Fableは3位で勝率83.3%。参加したモデルの中で最も「本気でゲームをしている」タイプだ。経済をきちんと育て、テクノロジーツリーを進めることもでき、ある試合ではウルトラリスク(Mutalisk)を作り、別の試合では聖堂武士(Taldor?)の技術まで研究していた。もちろん、研究に手間取って兵力が追いつかないこともある。それでも少なくとも「ゲームのルールを理解しようとしている」点では、Fableは誰よりも真面目だ。
Grokの成績が最も悪い。Grok 4.6は43分の試合で11000以上の推論トークンを出力したのに、操作指令はわずか6回しか出さず、終始戦闘ユニットを1体も作らなかった。本質的にはリアルタイムストラテジーをターン制のゲームのように扱い、ずっと考えてばかりで、手を動かすのを忘れているのだ。
このテストが明らかにした核心の問題は、現在の大規模モデルが、継続的な観察、素早い意思決定、多スレッド協調を要するリアルタイム環境に対して、まだまだ実用的でないことだ。最高のモデルでさえ、たとえば「フォトン砲の最速ラッシュ」(最も基本的な急襲戦術)を仕掛ける人間の初心者なら、全試合に勝ててしまう。逆に言えば、これらのモデルは建設、採掘、攻撃といった基本概念の理解はすでにできている。ただ、実行のリズムや複数タスクの協調になると、はるかに差が出てしまう。
テストのコードと対戦プラットフォームはすでに公開されており、誰でも自分のエージェントを持ち込んで1試合行える。URLは http://bw.swerdlow.dev だ。