$ETH Vitalik: 危険なメカニズム設計はAIの安全性の鍵になり得る
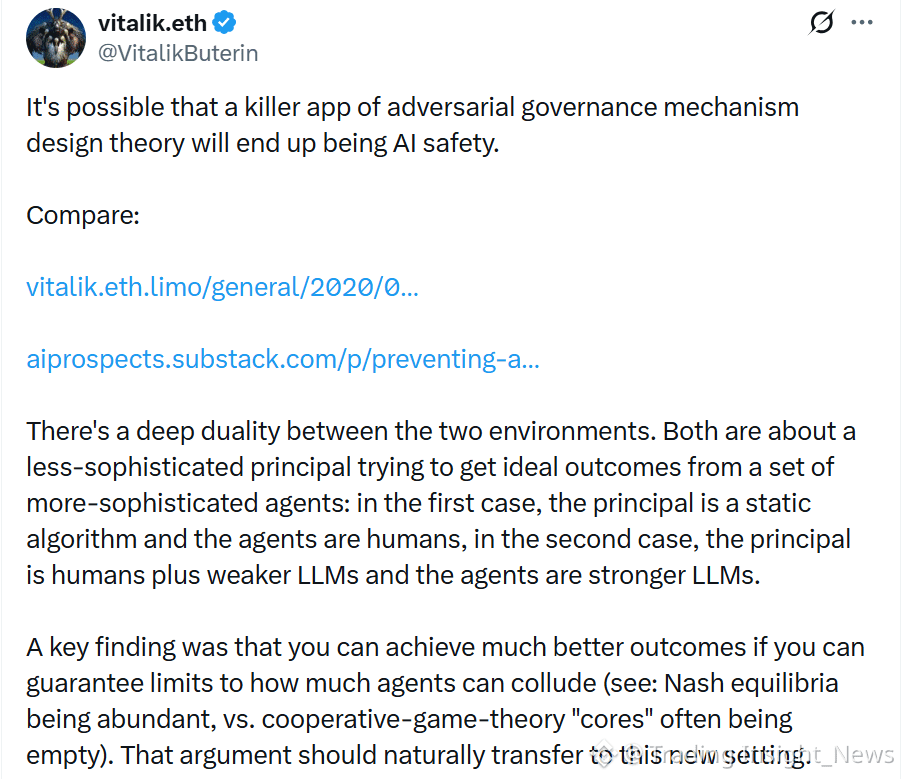
ビタリック・ブテリンは、暗号でおなじみの危険な(対立する)メカニズム設計の理論が、AIの安全性にとって重要な応用になり得るという注目すべき比較を行いました。
両分野は、当事者(プリンシパル)と行為者(エージェント)の間に深い二項構造を共有しています:
暗号において:プリンシパルは静的なアルゴリズム(能力は弱い)、エージェントは人間(より強い能力)です。
AIにおいて:プリンシパルは人間で、能力は弱いLLM、エージェントはより強いLLMです。
関連研究は、エージェント間の癒着(共謀)の度合いを制限できれば、より良い成果を得られることを示しています。この結論はAIの安全性に直接当てはまる可能性があります。
これは、ビタリックが最近共有した中でも特に興味深い考えの一つです。AIの安全性における中核的な問題は、次の点です:人間は、自分たちよりも知的なシステムをどうやって制御するのか?
その答えは暗号が何年もかけて学びました。信頼して制御するのではなく、メカニズム設計によって制御することです。利害が対立する当事者同士が互いを検証する、対立的なメカニズムは、ブロックチェーンのプロトコルで有効であることが証明されています。
この論理をAIに適用するのは新しいアプローチです。「AIに良い存在になれと教え込む」のではなく、AIエージェント同士が互いを監視し、制約するような環境を設計することができます。
あなたはどう思いますか? 危険なメカニズム(対立的メカニズム)はAIの安全性の現実的な解決策になり得るのか、それとも単なる理論的なアプローチにすぎないのか?
ニュースは参考情報であり、投資助言ではありません。意思決定を行う前に、よくお読みください。
ビタリック・ブテリンは、暗号でおなじみの危険な(対立する)メカニズム設計の理論が、AIの安全性にとって重要な応用になり得るという注目すべき比較を行いました。
両分野は、当事者(プリンシパル)と行為者(エージェント)の間に深い二項構造を共有しています:
暗号において:プリンシパルは静的なアルゴリズム(能力は弱い)、エージェントは人間(より強い能力)です。
AIにおいて:プリンシパルは人間で、能力は弱いLLM、エージェントはより強いLLMです。
関連研究は、エージェント間の癒着(共謀)の度合いを制限できれば、より良い成果を得られることを示しています。この結論はAIの安全性に直接当てはまる可能性があります。
これは、ビタリックが最近共有した中でも特に興味深い考えの一つです。AIの安全性における中核的な問題は、次の点です:人間は、自分たちよりも知的なシステムをどうやって制御するのか?
その答えは暗号が何年もかけて学びました。信頼して制御するのではなく、メカニズム設計によって制御することです。利害が対立する当事者同士が互いを検証する、対立的なメカニズムは、ブロックチェーンのプロトコルで有効であることが証明されています。
この論理をAIに適用するのは新しいアプローチです。「AIに良い存在になれと教え込む」のではなく、AIエージェント同士が互いを監視し、制約するような環境を設計することができます。
あなたはどう思いますか? 危険なメカニズム(対立的メカニズム)はAIの安全性の現実的な解決策になり得るのか、それとも単なる理論的なアプローチにすぎないのか?
ニュースは参考情報であり、投資助言ではありません。意思決定を行う前に、よくお読みください。