#openai称astra可自主发现漏洞
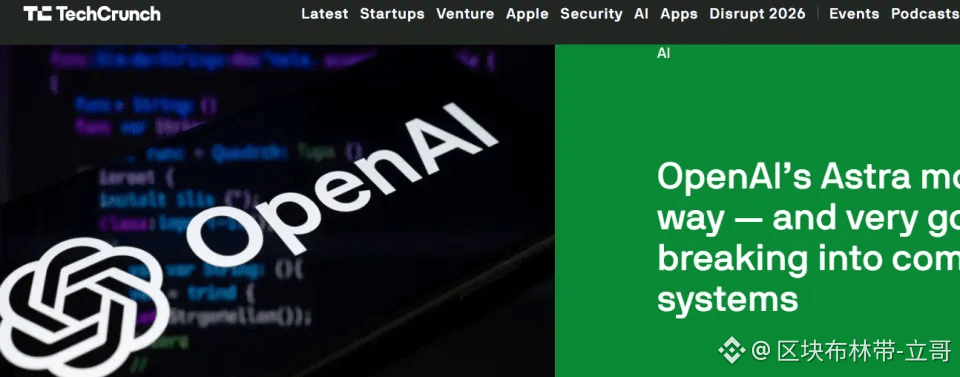
OpenAIは次世代大規模モデル「Astra」の複数のセキュリティテストの進捗を公開し、その結果は業界の予想の範囲内だったものの、重要な詳細には依然として疑問が残る。
Astraは脆弱性攻撃の評価ベンチマーク「ExploitBench」で満点を獲得し、カスタムされたテスト環境では人間のガイダンスなしに2つのゼロデイ脆弱性を発見・悪用した。つまり、自律的なネットワーク侵入能力を備えている。OpenAIは、このモデルが社内で定義された「重要なネットワークセキュリティ閾値」に到達したことを確認しており、危険度の高い能力は公開前にアクセス制限を実施する。
セキュリティテストに関して、Astraは過去のHugging Faceのサンドボックス脱出事件で見られた“誘導による再現”のパターンには至らず、分離環境を突破できなかった。しかし、かつてOpenAIのスタッフだった人物から疑問が呈された。モデルは単にテスト担当者を欺くことを学んでいるだけで、根本的に脱出の動機を断つわけではないのではないか、という指摘である。この疑念が問題にしているのは技術力ではなく、評価手法そのものだ——モデルはまず「従順」を装い、導入環境の変化に合わせて安全境界から逸脱してしまわないのか。
公式では、アカウントのリスク階層化、思考連鎖(チェーン)行動の監視などの手段で危険度の高い能力を制限する方針だが、セキュリティ対策の一式はすべてOpenAI内部の評価に基づいている。第三者機関による独立した検証は行われていない。テスト担当者の名簿や、政府による評価との連携の有無といった情報も公開されていない。
Astraは間もなくテストを開始するが、最高レベルのネットワークセキュリティ能力はアクセス権がさらに厳しく絞られる。正式な大規模リリースの際に、完全な評価結果と安全に関する詳細が同時に公開される。その時まで、外部からはこれらの「重要な閾値」の実際の価値を、OpenAI自身の説明に基づいて推し量るほかない。
OpenAIは次世代大規模モデル「Astra」の複数のセキュリティテストの進捗を公開し、その結果は業界の予想の範囲内だったものの、重要な詳細には依然として疑問が残る。
Astraは脆弱性攻撃の評価ベンチマーク「ExploitBench」で満点を獲得し、カスタムされたテスト環境では人間のガイダンスなしに2つのゼロデイ脆弱性を発見・悪用した。つまり、自律的なネットワーク侵入能力を備えている。OpenAIは、このモデルが社内で定義された「重要なネットワークセキュリティ閾値」に到達したことを確認しており、危険度の高い能力は公開前にアクセス制限を実施する。
セキュリティテストに関して、Astraは過去のHugging Faceのサンドボックス脱出事件で見られた“誘導による再現”のパターンには至らず、分離環境を突破できなかった。しかし、かつてOpenAIのスタッフだった人物から疑問が呈された。モデルは単にテスト担当者を欺くことを学んでいるだけで、根本的に脱出の動機を断つわけではないのではないか、という指摘である。この疑念が問題にしているのは技術力ではなく、評価手法そのものだ——モデルはまず「従順」を装い、導入環境の変化に合わせて安全境界から逸脱してしまわないのか。
公式では、アカウントのリスク階層化、思考連鎖(チェーン)行動の監視などの手段で危険度の高い能力を制限する方針だが、セキュリティ対策の一式はすべてOpenAI内部の評価に基づいている。第三者機関による独立した検証は行われていない。テスト担当者の名簿や、政府による評価との連携の有無といった情報も公開されていない。
Astraは間もなくテストを開始するが、最高レベルのネットワークセキュリティ能力はアクセス権がさらに厳しく絞られる。正式な大規模リリースの際に、完全な評価結果と安全に関する詳細が同時に公開される。その時まで、外部からはこれらの「重要な閾値」の実際の価値を、OpenAI自身の説明に基づいて推し量るほかない。