#dusk $DUSK @Dusk
私はDuskの最近のエンジニアリング変更を読み進めていて、面白い部分が検証システムのさらなる改善だろうと期待していました。
しかし結局、もっと地味で華やかさのないことに何度も立ち返ることになりました。つまり、証明が処理される前に何が起きるのか、という点です。
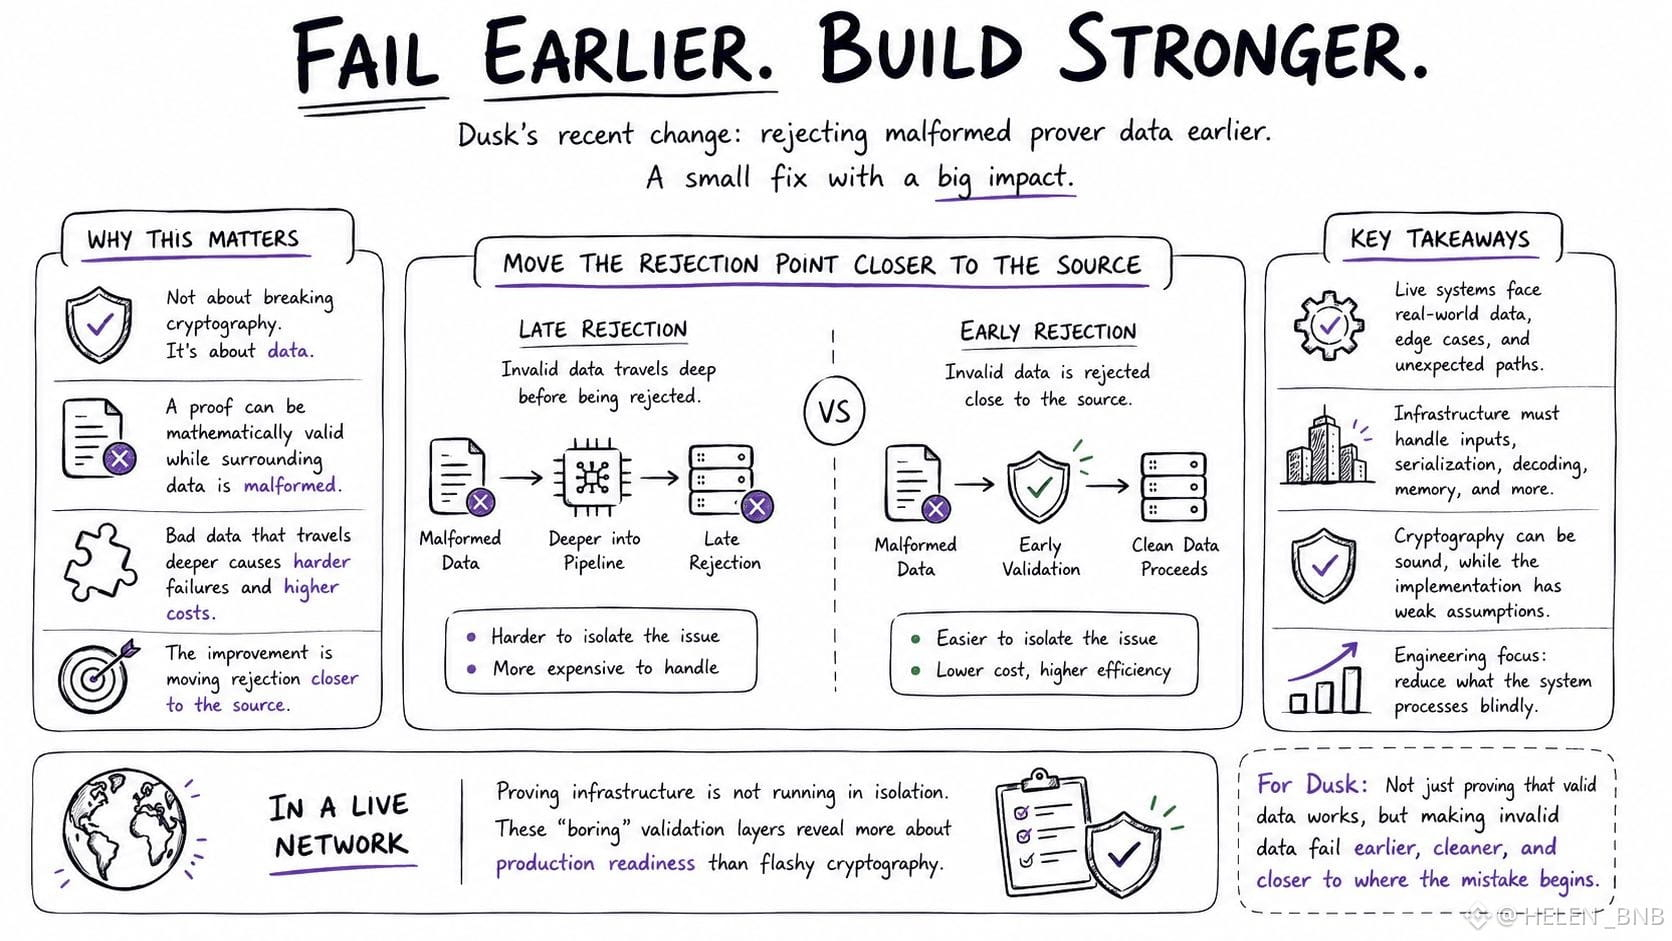
最近のPlonk関連の変更では、不正なプロバー(証明者)データをより早い段階で拒否することに焦点が当てられていました。最初は、単なる事務的な整備のように聞こえます。
ですが考えれば考えるほど、それがいかに重要かが増していきました。
暗号を破壊することと、暗号基盤に不正なデータを送り込むことには違いがあります。
証明そのものは数学的に正しくても、その周辺のデータが、誤ってシリアライズされていたり、システムが想定していなかった形に構造化されていたりすることがあります。そうした入力が、検証(プロービング)のパイプラインのより深いところまで許可されてしまうと、最終的な失敗は切り分けが難しくなり、場合によっては対処コストも高くなり得ます。
したがって本当の改善は、必ずしもより強い数学にあるわけではありません。
要は、拒否が行われる地点を、より元の原因に近づけることです。
これは運用上重要です。
実運用のネットワークにおける証明基盤は、孤立して動いているわけではありません。入力のシリアライズ/デコード、メモリの実行経路、そしてソフトウェアが現実のデータに触れたときに現れる数々の奇妙なエッジケースに対処しなければなりません。
暗号は健全でも、その周辺の実装が弱い前提を持っていることはあります。
だからこそ、私はこうした小さな変更を、派手な機能発表よりもよく示していると感じます。
それらは、エンジニアリングチームが「システムが何を盲目的に処理することになるのか」の数を減らすために、どこに時間を使っているのかを示してくれます。
Duskに関しては、これは重要な方向性だと思います。単に「有効なデータが動くこと」を証明するだけでなく、「無効なデータが、より早く、よりきれいに、そして間違いが始まった場所により近いところで失敗する」ようにすることです。
退屈なバリデーション層は、派手な暗号よりも、生産環境での準備度合いをより多く教えてくれるかもしれません。
私はDuskの最近のエンジニアリング変更を読み進めていて、面白い部分が検証システムのさらなる改善だろうと期待していました。
しかし結局、もっと地味で華やかさのないことに何度も立ち返ることになりました。つまり、証明が処理される前に何が起きるのか、という点です。
最近のPlonk関連の変更では、不正なプロバー(証明者)データをより早い段階で拒否することに焦点が当てられていました。最初は、単なる事務的な整備のように聞こえます。
ですが考えれば考えるほど、それがいかに重要かが増していきました。
暗号を破壊することと、暗号基盤に不正なデータを送り込むことには違いがあります。
証明そのものは数学的に正しくても、その周辺のデータが、誤ってシリアライズされていたり、システムが想定していなかった形に構造化されていたりすることがあります。そうした入力が、検証(プロービング)のパイプラインのより深いところまで許可されてしまうと、最終的な失敗は切り分けが難しくなり、場合によっては対処コストも高くなり得ます。
したがって本当の改善は、必ずしもより強い数学にあるわけではありません。
要は、拒否が行われる地点を、より元の原因に近づけることです。
これは運用上重要です。
実運用のネットワークにおける証明基盤は、孤立して動いているわけではありません。入力のシリアライズ/デコード、メモリの実行経路、そしてソフトウェアが現実のデータに触れたときに現れる数々の奇妙なエッジケースに対処しなければなりません。
暗号は健全でも、その周辺の実装が弱い前提を持っていることはあります。
だからこそ、私はこうした小さな変更を、派手な機能発表よりもよく示していると感じます。
それらは、エンジニアリングチームが「システムが何を盲目的に処理することになるのか」の数を減らすために、どこに時間を使っているのかを示してくれます。
Duskに関しては、これは重要な方向性だと思います。単に「有効なデータが動くこと」を証明するだけでなく、「無効なデータが、より早く、よりきれいに、そして間違いが始まった場所により近いところで失敗する」ようにすることです。
退屈なバリデーション層は、派手な暗号よりも、生産環境での準備度合いをより多く教えてくれるかもしれません。