


原文タイトル:(DeepSeek がビジュアル理解モデルを公開、大ブルー・ホエールなどが遅れてやってくる目)
原文作者:動察Beating
2026 年 8 月 21 日、DeepSeek は新しいビジュアル理解モデル deepseek-v4-flash-vision-exp を発表し、多モーダル API を正式に公開しました。開発者は初めて、画像をそのまま DeepSeek の公式インターフェースに送れるようになりました。
モデルは V4 Flash の 100 万トークンのコンテキストと最大 38.4 万トークンの出力を保持し、JSON Output、Tool Calls、Responses API をサポートし、さらに Anthropic API とも互換性があります。
価格は完全に V4 Flash を踏襲しています。1百万トークンの入力につき、キャッシュ未ヒット時はピーク時 3 元、閑散期 1.5 元です。キャッシュヒット時はそれぞれ 0.1 元と 0.05 元。出力はピーク時 9 元、閑散期 4.5 元です。北京では毎日 9 時から 12 時、14 時から 18 時がピークで、それ以外の 17 時間は半額です。
画像も同様にtokenで課金される。モデルに入る前に、各画像はサイズに応じて自動的に縮小され、約384×384ピクセル未満のものは拡大され、大きい画像は総画素数がおよそ800×800ピクセル相当にまで圧縮される。1枚の画像が占めるtokenは最大384個。2000×2000の画像と5000×5000の画像でも、最終的に消費するtoken数はまったく同じになる可能性がある。
384 token の上限に従えば、画像1枚あたりのピーク時の入力料金は、キャッシュ未ヒットの場合で約0.001152元である。このような画像を1000枚処理しても、画像入力そのものは約1.152元にすぎず、テキストとモデル出力は別計算になる。
同時に公開されたのは Files API でもある。開発者は事前に画像をアップロードしておき、file_id をリクエストに入れればよい。同じ画像は1回だけ送れば、その後は別のリクエストで何度でも参照できる。
このAPI自体は無料である。単一ファイルの最大サイズは64 MiBで、1ユーザーあたり最大25 GiB、10000ファイルまで保存できる。ファイルには1時間から30日後までの有効期限を設定でき、期限を設定しなければずっと保持できる。現在、公式にはファイル内容をダウンロードするためのインターフェースも提供されていない。開発者はアップロード、照会、削除ができ、モデルは読み取れる。これは普通のクラウドドライブというより、推論のために用意された無料の画像リポジトリに近い。
だが、奇妙なのは DeepSeek が今日になってようやく画像を見られるようになったことではない。
2つのタイムライン
研究だけを見るなら、DeepSeek の視覚は決して遅くはない。
製品とAPIだけを見るなら、確かにずいぶん遅かった。
2024年3月11日、DeepSeek-VL がオープンソース化された。
1.3B版と7B版の2種類があり、自然画像、Webページ、数式、グラフ、文書を見られる。10月になると Janus が登場し、画像理解と生成を同一の自己回帰フレームワークに入れた。11月13日には JanusFlow が続いた。12月には DeepSeek-VL2 が公開され、混合専門家アーキテクチャに切り替わり、総パラメータ数は3B、16B、27Bの3段階に分かれた。
2025年1月28日の未明、除夕に Janus-Pro がオープンソース化された。公式リポジトリでは UTC 基準で1月27日と記録されている。
7B 版は、画像生成の指示追従評価である GenEval で0.80を獲得し、論文に挙げられた DALL-E 3 の0.67を上回った。オープンソースの重みがあり、ローカル展開もでき、公開デモもある。
DeepSeek はそれを自社のホスト型APIには組み込まなかった。
その直前の1週間で、R1 はすでに DeepSeek をスポットライトの下へ押し上げていた。Janus は GitHub と Hugging Face に残った。大多数の一般ユーザーにとっては、すぐにまた視界から消えていった。
2025年10月20日、DeepSeek-OCR がオープンソース化され、視覚tokenで長文書を圧縮した。2026年1月27日、OCR 2 が公開された。
DeepSeek-VL から数えると、2年の間に少なくとも DeepSeek-VL、Janus、JanusFlow、VL2、Janus-Pro、OCR、OCR 2 の7つの公開記録を確認できる。
視覚研究はずっと続けられてきたし、外にも出し続けてきた。
ただ、普通の開発者にはその入口がずっとなかった。
一方で、2024年3月までには、主要な競合他社のいくつかの開発者向けインターフェースがすでに画像を受け取れるようになっていた。OpenAI は2023年11月に GPT-4 Turbo with Vision を公開し、画像を直接 Chat Completions API に入れられるようにした。1か月後、Google は Gemini Pro Vision API を公開した。2024年3月には Claude 3 全系に視覚機能が加わった。
2025年4月25日、李彦宏は百度Create大会で「DeepSeek も万能ではない」と述べた。続けて挙げられた問題の中には、モダリティが単一であることも含まれていた。
彼の判断では、マルチモーダルは基盤モデルの標準機能になり、純テキストモデルの市場はますます小さくなる。
そのころ、DeepSeek はすでに1年間にわたって視覚研究を行っていた。
未明
2026年4月7日と8日、一部のユーザーが DeepSeek を開くと、画面に突然3つの入口が増えていた。
「高速」「専門家」「視覚」。
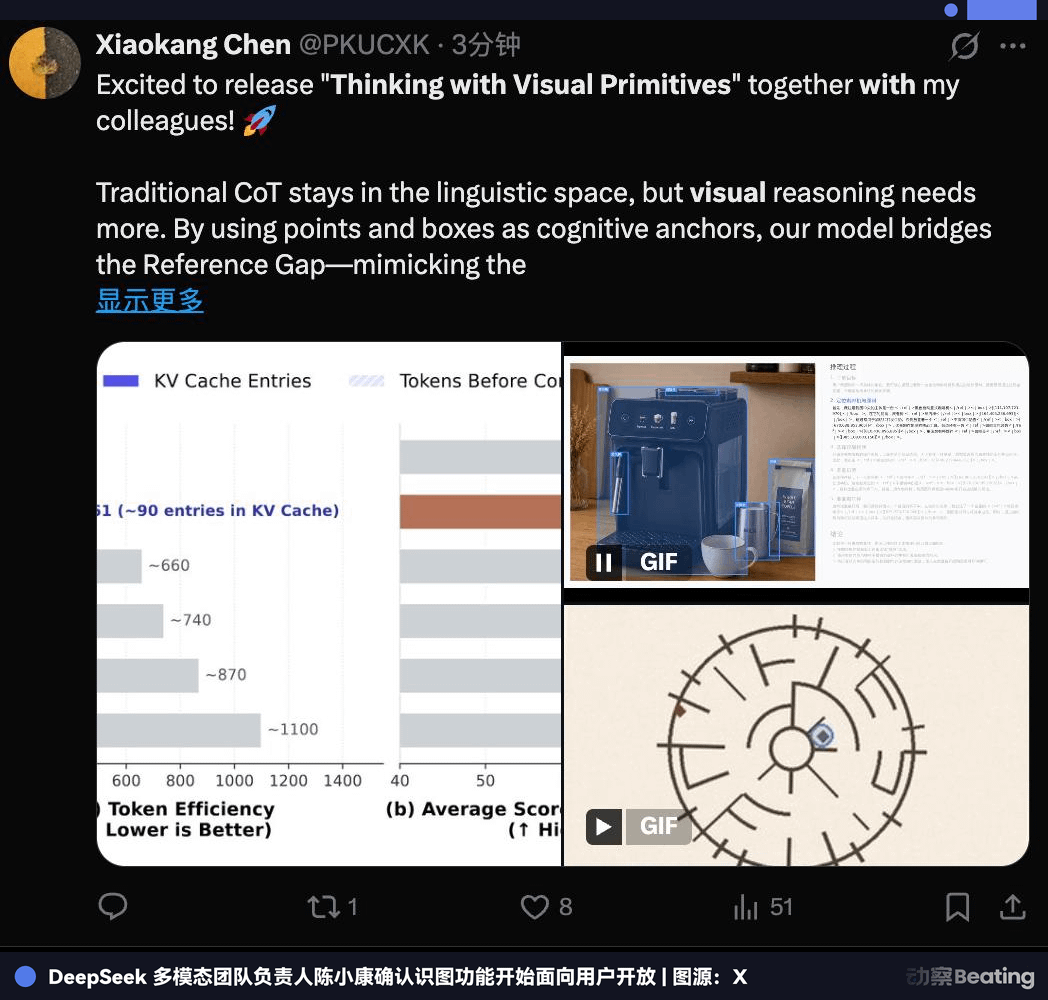
4月29日、DeepSeek のマルチモーダルチーム責任者である陳小康が、画像認識機能の一部ユーザー向け段階的公開を確認した。続いて、DeepSeek のベテラン研究員が「小さなクジラはもう見えるようになった」と書いた。南華早報はそのままこの一文を見出しに使った。
DeepSeek の目が、初めて本当にプロダクト画面の中から姿を現した。
翌日、DeepSeek は(Thinking with Visual Primitives)を GitHub に公開した。数時間後、リポジトリと論文は再び取り下げられた。5月1日には、元のアドレスはすでに404を返していた。DeepSeek は説明せず、ネット上には論文のミラーとメディアの引用だけが残った。
この論文が研究しているのは、非常に具体的な問題だ。
モデルは非常に混雑した画像を見ると、自分が何について話しているかは分かっていても、いったい誰のことなのか、どの線なのかをはっきり言えないことが多い。チームは点の座標と境界ボックスを推論過程に直接差し込み、モデルに位置を指し示させながら、そのまま次の思考へ進ませた。
756×756の画像はまず視覚エンコーダを通り、2916個の画像パッチtokenに変換され、その後3×3の空間圧縮で324個のtokenにまとめられる。V4 Flash の疎な注意機構はさらにキャッシュを圧縮し、最終的には81個の視覚KV項目だけが残る。
チームはこの手法のために4000万件を超える訓練サンプルも生成しており、その中には迷路ナビゲーションや経路追跡を専用に訓練するデータも含まれていた。
この論文が大きな労力を割いて解決したのは、実は「どこを指すか」だった。
モデルはまず見えなければならず、そのうえで、自分がどこを見ているのかを知る必要がある。そうして初めて、次の推論へ進める。
DeepSeek は今回、Vision Exp がこの Visual Primitives 方式を完全に踏襲しているかどうかは明言しなかった。より重要なのは、この研究で DeepSeek にとっての「視覚推論」の理解が初めて外に露わになったことだ。
6月18日、WebとAppの画像認識モードが正式に公開された。翌日、あるメディアが梁文鋒の写真をアップロードして試したところ、DeepSeek は2回連続で彼を張一鳴だと認識した。別の会話では、今度は張一鳴を寒武紀創業者の陳天石だと答えた。
英語のスクリーンショットは読めるし、Webページをコードに変換することもできる。
ところが顔を前にすると、上司の顔さえ認識できなかった。
8月19日、DeepSeek Harness は日付を明記した技術メモを残した。公式アダプタはすでに画像を image_url にシリアライズでき、文書には、デフォルトのモデルディレクトリには当面 deepseek-v4-flash-vision-exp を表示せず、対応するAPIエンドポイントが利用可能になるのを待つ必要があることも明記されていた。
8月20日には、まだ公開されていないこのモデル名に画像を送ると、400エラーが返るだけだと開発者が実測で確認した。
8月21日、この制限が取り払われた。Harness は deepseek-v4-flash-vision-exp をデフォルトのモデルディレクトリに追加し、対応するマージコミットには「publish the vision model」と直接書かれていた。続いて、DeepSeek 公式APIドキュメントと公式アカウントが同時に Vision Exp の提供開始を発表した。
2つの線がようやく交わった。
Agent
今年5月の投資家向け交流会の音声書き起こしで、梁文鋒は自分が理解する AGI への道筋をいくつかの段階に並べた。言語モデル、思考連鎖、Agent、継続学習、自己反復、そして身体性知能へ。
彼はマルチモーダルをコンポーネントの位置に置いており、検索とほぼ同じように考えていた。
動画生成について語る箇所には、書き起こしの中にこういう一文がある:
商業的には、これは良いビジネスだ。だが、それは知能とはほとんど関係がない。
彼の判断では、動画生成や世界モデルは、現段階では知能の上限との関係がそれほど大きくなく、目先でより重要なのはAIの訓練と、その後の継続学習である。
マルチモーダルが違うのは、それ自体も「コンポーネント」の位置に置かれつつ、DeepSeek が明確に「必ずやる」と述べていたコンポーネントだったことだ。梁文鋒は当時、V4 以降のバージョンがネイティブマルチモーダルをサポートすると述べてもいた。
DeepSeek の路線の中で視覚はずっと居場所があったが、ただ前面にはそれほど出ていなかった。
路線が第3段階のAgentへ進むと、状況は少し違ってきた。
DeepSeek は今回の視覚APIが「Agent のために」公開されたとは明言していない。だが、梁文鋒の路線判断と今日の発表を重ねて見ると、両者はもはや完全に切り離しては見にくい。
Agent は画面を読まなければならず、グラフを見なければならず、ツールが返してきたスクリーンショットを処理しなければならない。ずっと純テキストの中だけで生きることはできない。すでに2年間積み上げてきた視覚能力も、ようやく論文、リポジトリ、テストページを経て、APIへとたどり着いた。
DeepSeek が今日 Vision Exp で示した3つの例も、いずれも従来の「画像を見て語る」ものではない。あるAgentは高級顧客向けにチベット自動車旅行のPPTを作り、別のものは DeepSeek Harness の公式サイトを再設計し、さらに別のものは視覚要件に基づいて動的効果付きのフロントエンドDemoを作成した。
それらはいずれも、長いフローのタスクの中でモデルが視覚情報を繰り返し処理する必要がある。
API の設計もその方向へ寄っている。Responses API も input_image を受け付け、ブラウザAgentはWebページのスクリーンショットを受け取って、それを次の推論に再投入できる。コードAgentはレンダリング結果を確認でき、グラフ、スキャン文書、ソフトウェア画面もそのままコンテキストになりうる。
Files API は別の問題も解決する。同じ画像を毎回のリクエストで繰り返しアップロードする必要がない。1つのファイルを長期間置いておけて、Agent は file_id を繰り返し送るだけでよい。1回のリクエストには最大600枚の画像も入れられる。外部リンクやBase64を使う場合、1枚あたりの上限は32 MiBだが、Files API で参照すれば64 MiBまで使える。
これはもう、チャット欄に「画像をアップロード」ボタンを1つ追加しただけ、という感じではない。
むしろ、Agent が視覚を使うときに必要な基盤を補っているように見える。
DeepSeek が公表した4つのマルチモーダルAgent比較も、従来の意味での「画像を見て語る」を試すことは少ない。
ApexBench は投資銀行、コンサル、法律などの長いフローのタスクを扱う。Agents' Last Exam は55の専門分野における実際の業務に由来する。Chartography は Kaplan-Meier 曲線、K線、等高線、サンキー図、ポートフォリオ図を専門に評価する。ZeroBench は100問の人手設計による難問で多段階の視覚推論をテストする。
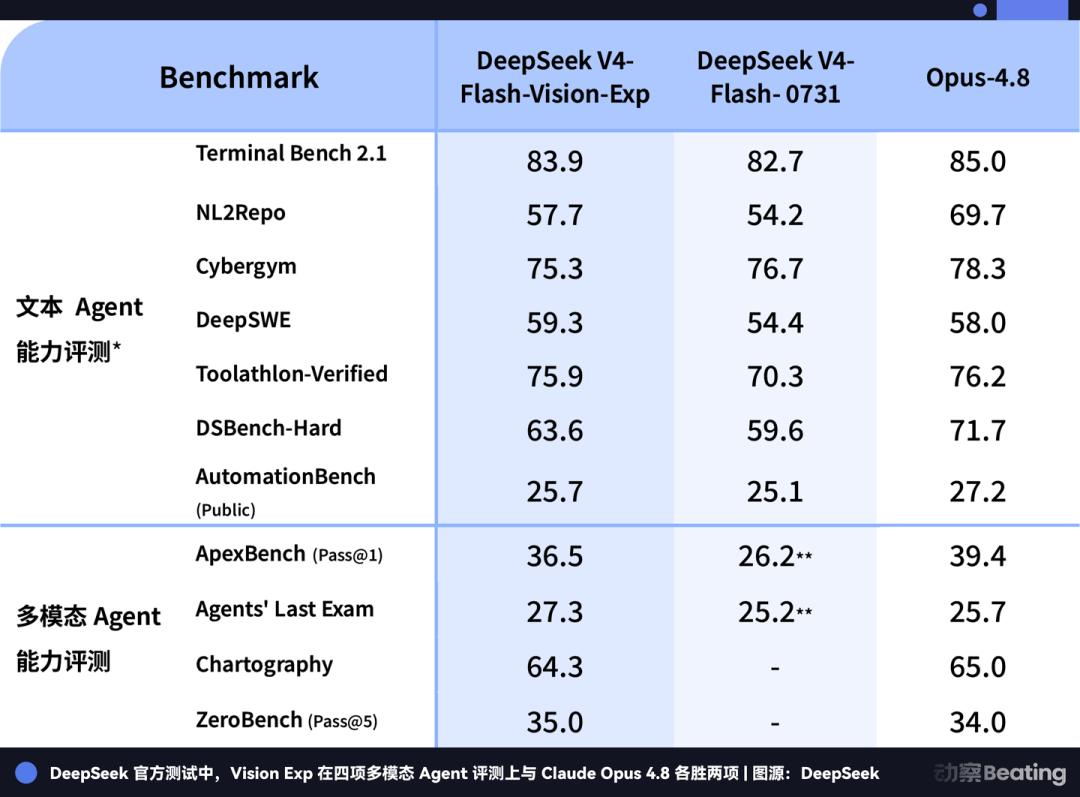
Vision Exp は Claude Opus 4.8 に対して2勝2敗だった。
Agents' Last Exam は27.3対25.7、ZeroBench は35.0対34.0。ApexBench は36.5対39.4、Chartography は64.3対65.0。4項目とも差は3点を超えていない。
さらに興味深いのは、視覚を加えたあとも、元のテキストAgent能力が目立って落ちなかったことだ。
7月31日に公開された純テキストV4 Flashと項目ごとに比較すると、公式サイトが同時に示した前後の成績では、5つのテキストAgent評価がすべて上昇していた。
Terminal Bench 2.1 は82.7から83.9へ、NL2Repo は54.2から57.7へ、DeepSWE は54.4から59.3へ、DSBench-Hard は59.6から63.6へ、AutomationBench は25.1から25.7へ上昇した。DeepSWE の59.3は、図中の Opus 4.8 の58.0も上回っている。
ただし、この数字は DeepSeek 自身のテストによるものだ。公式注記では、公開 Code Agent のテキストタスクにおける DeepSeek シリーズモデルは DeepSeek Harness の最小構成モードを使い、推論設定は max になっている。これらは Vision Exp を自社の V4 Flash と比べてどう変わったかを見るには適しているが、第三者による独立ランキングとしてそのまま受け取るべきではない。
モデル名の後ろの exp も、まだ外されていない。
DeepSeek はそれを明確に実験モデルと位置づけており、バージョンはなお変化する可能性がある。現在のインターフェースは画像理解のみで、出力は依然としてテキストである。画像生成と動画は未公開で、Files API も JPEG、PNG、GIF、WebP しか受け付けず、PDF は直接入れられない。
2024年、DeepSeek に画像を送りたくても、公式APIはまだ受け付けられなかった。
2026年8月21日になると、その画像がついに入ってきた。
DeepSeek の目は確かに開くのが遅かった。
それが本当に目を開いたときには、その前の道はもう、目を閉じたまま進み続けることを許していなかった。
原文リンク