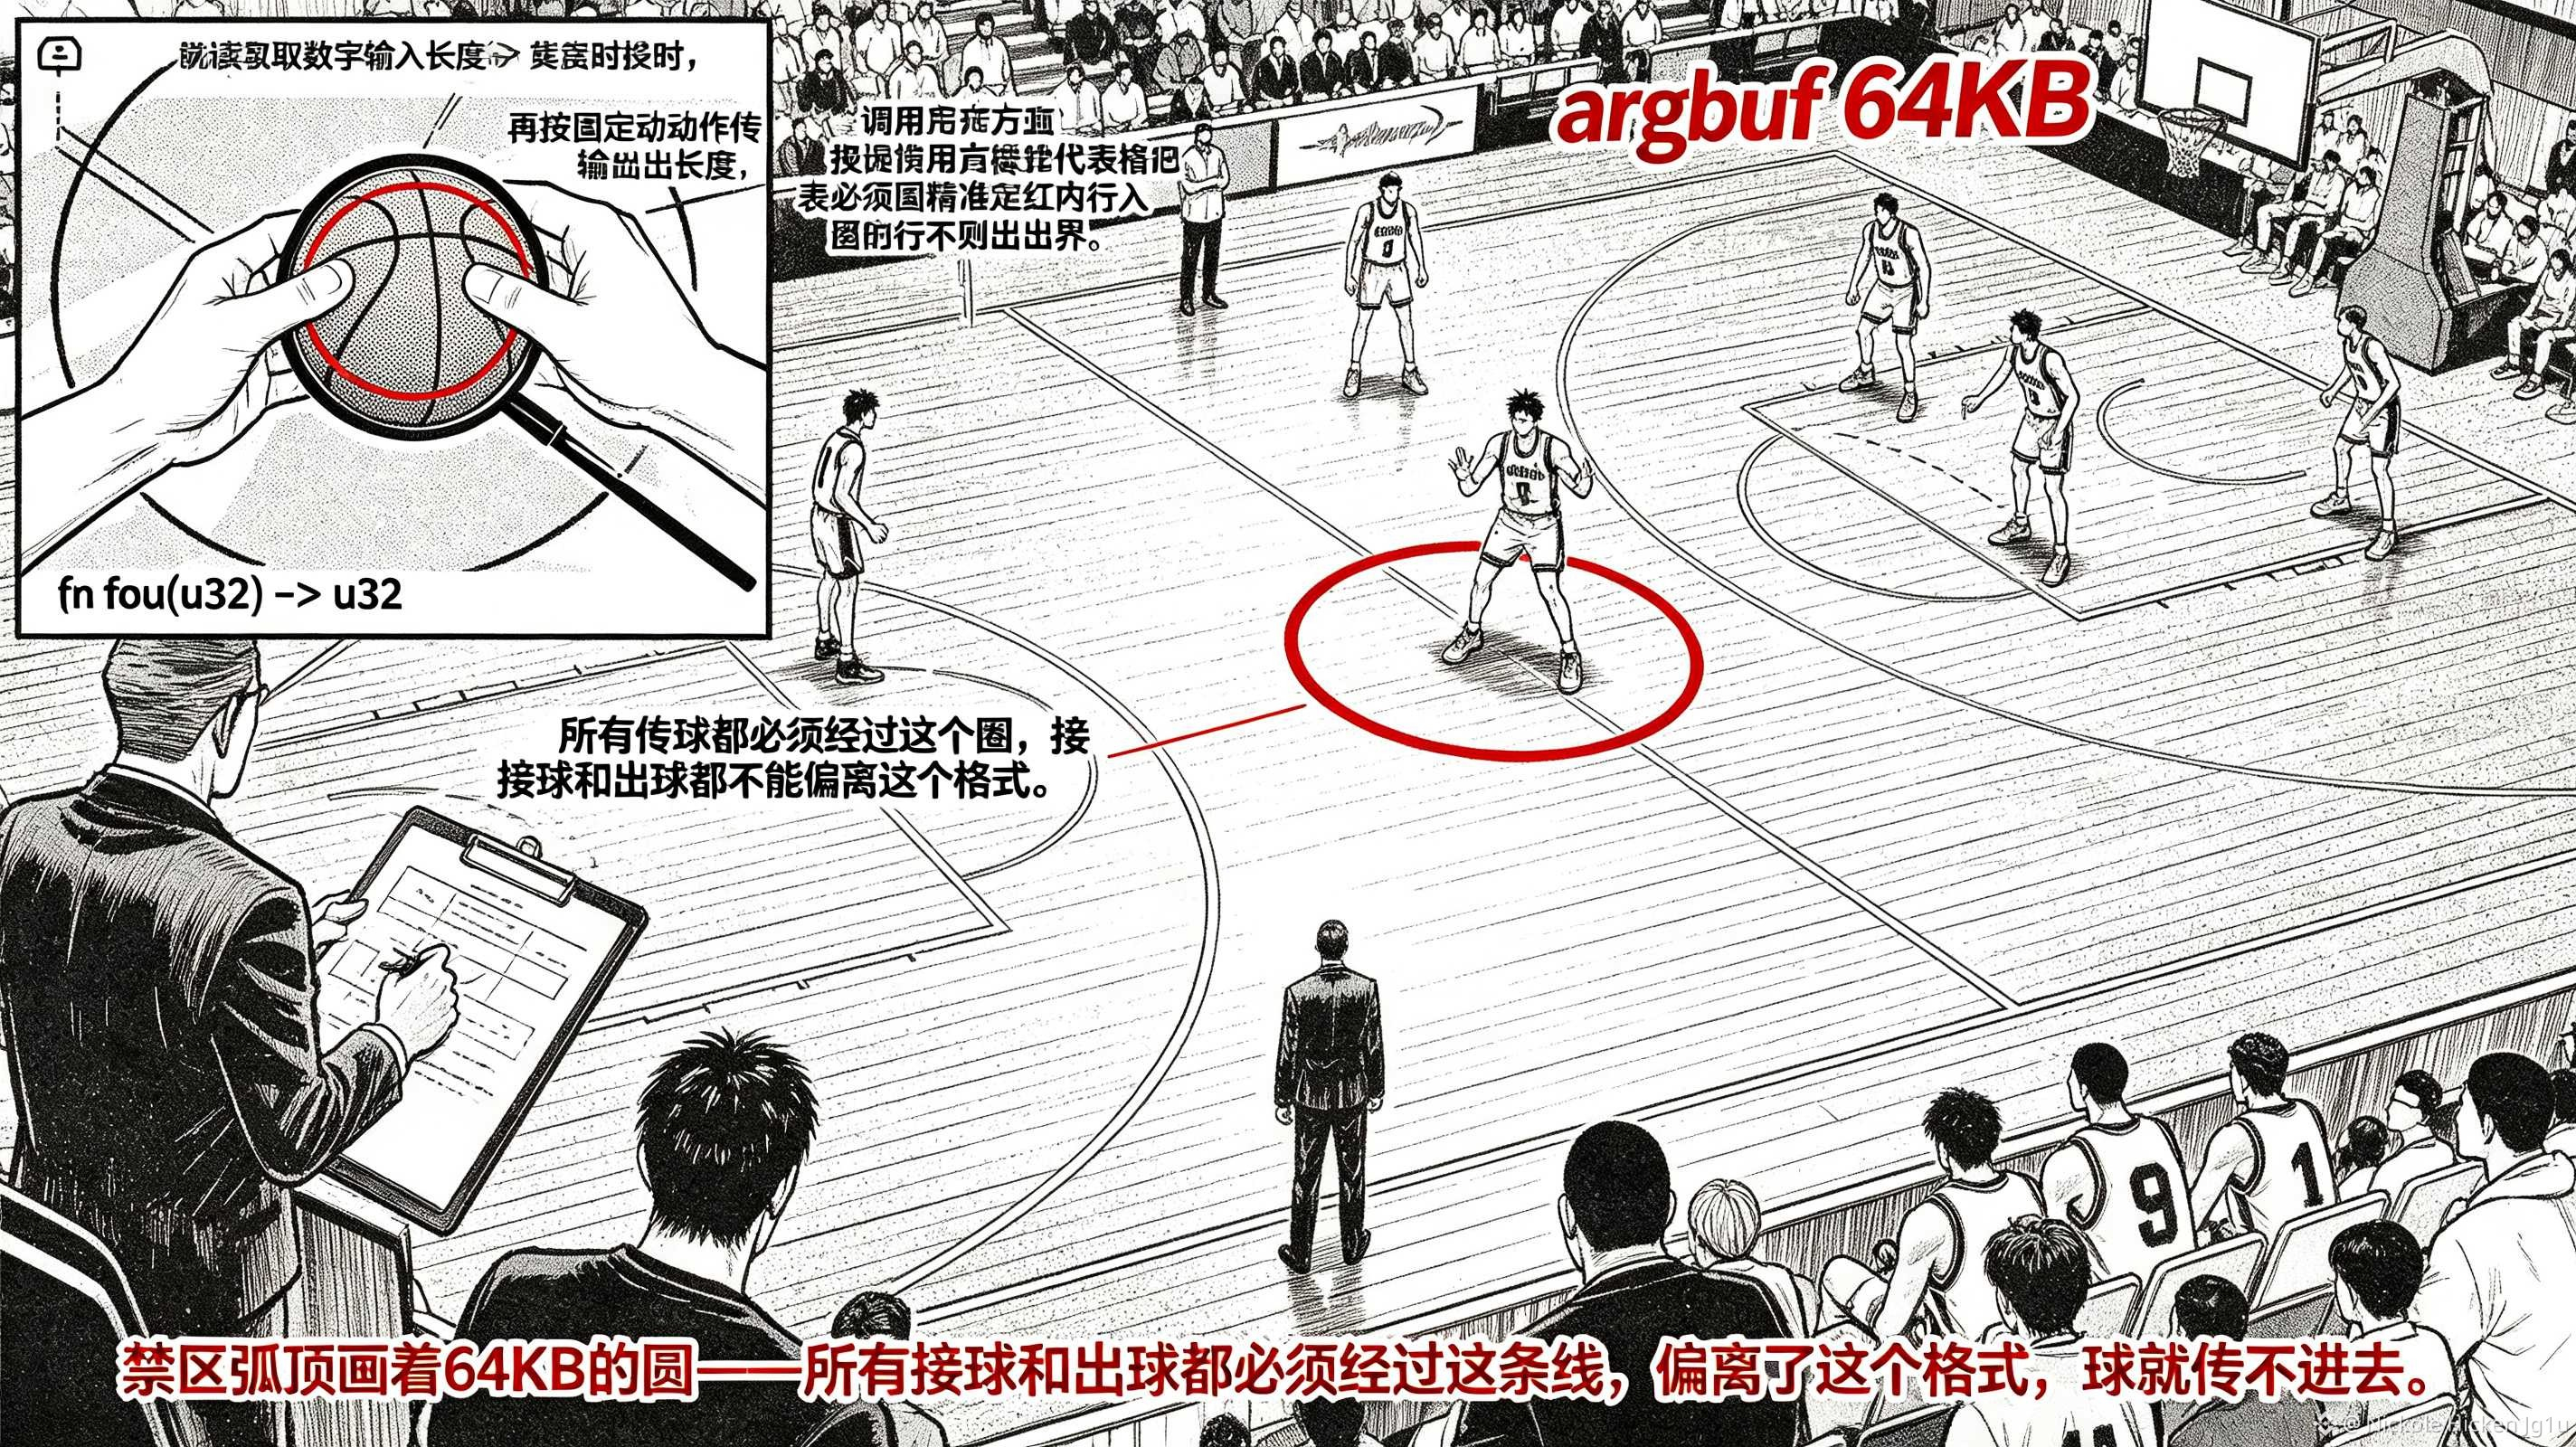
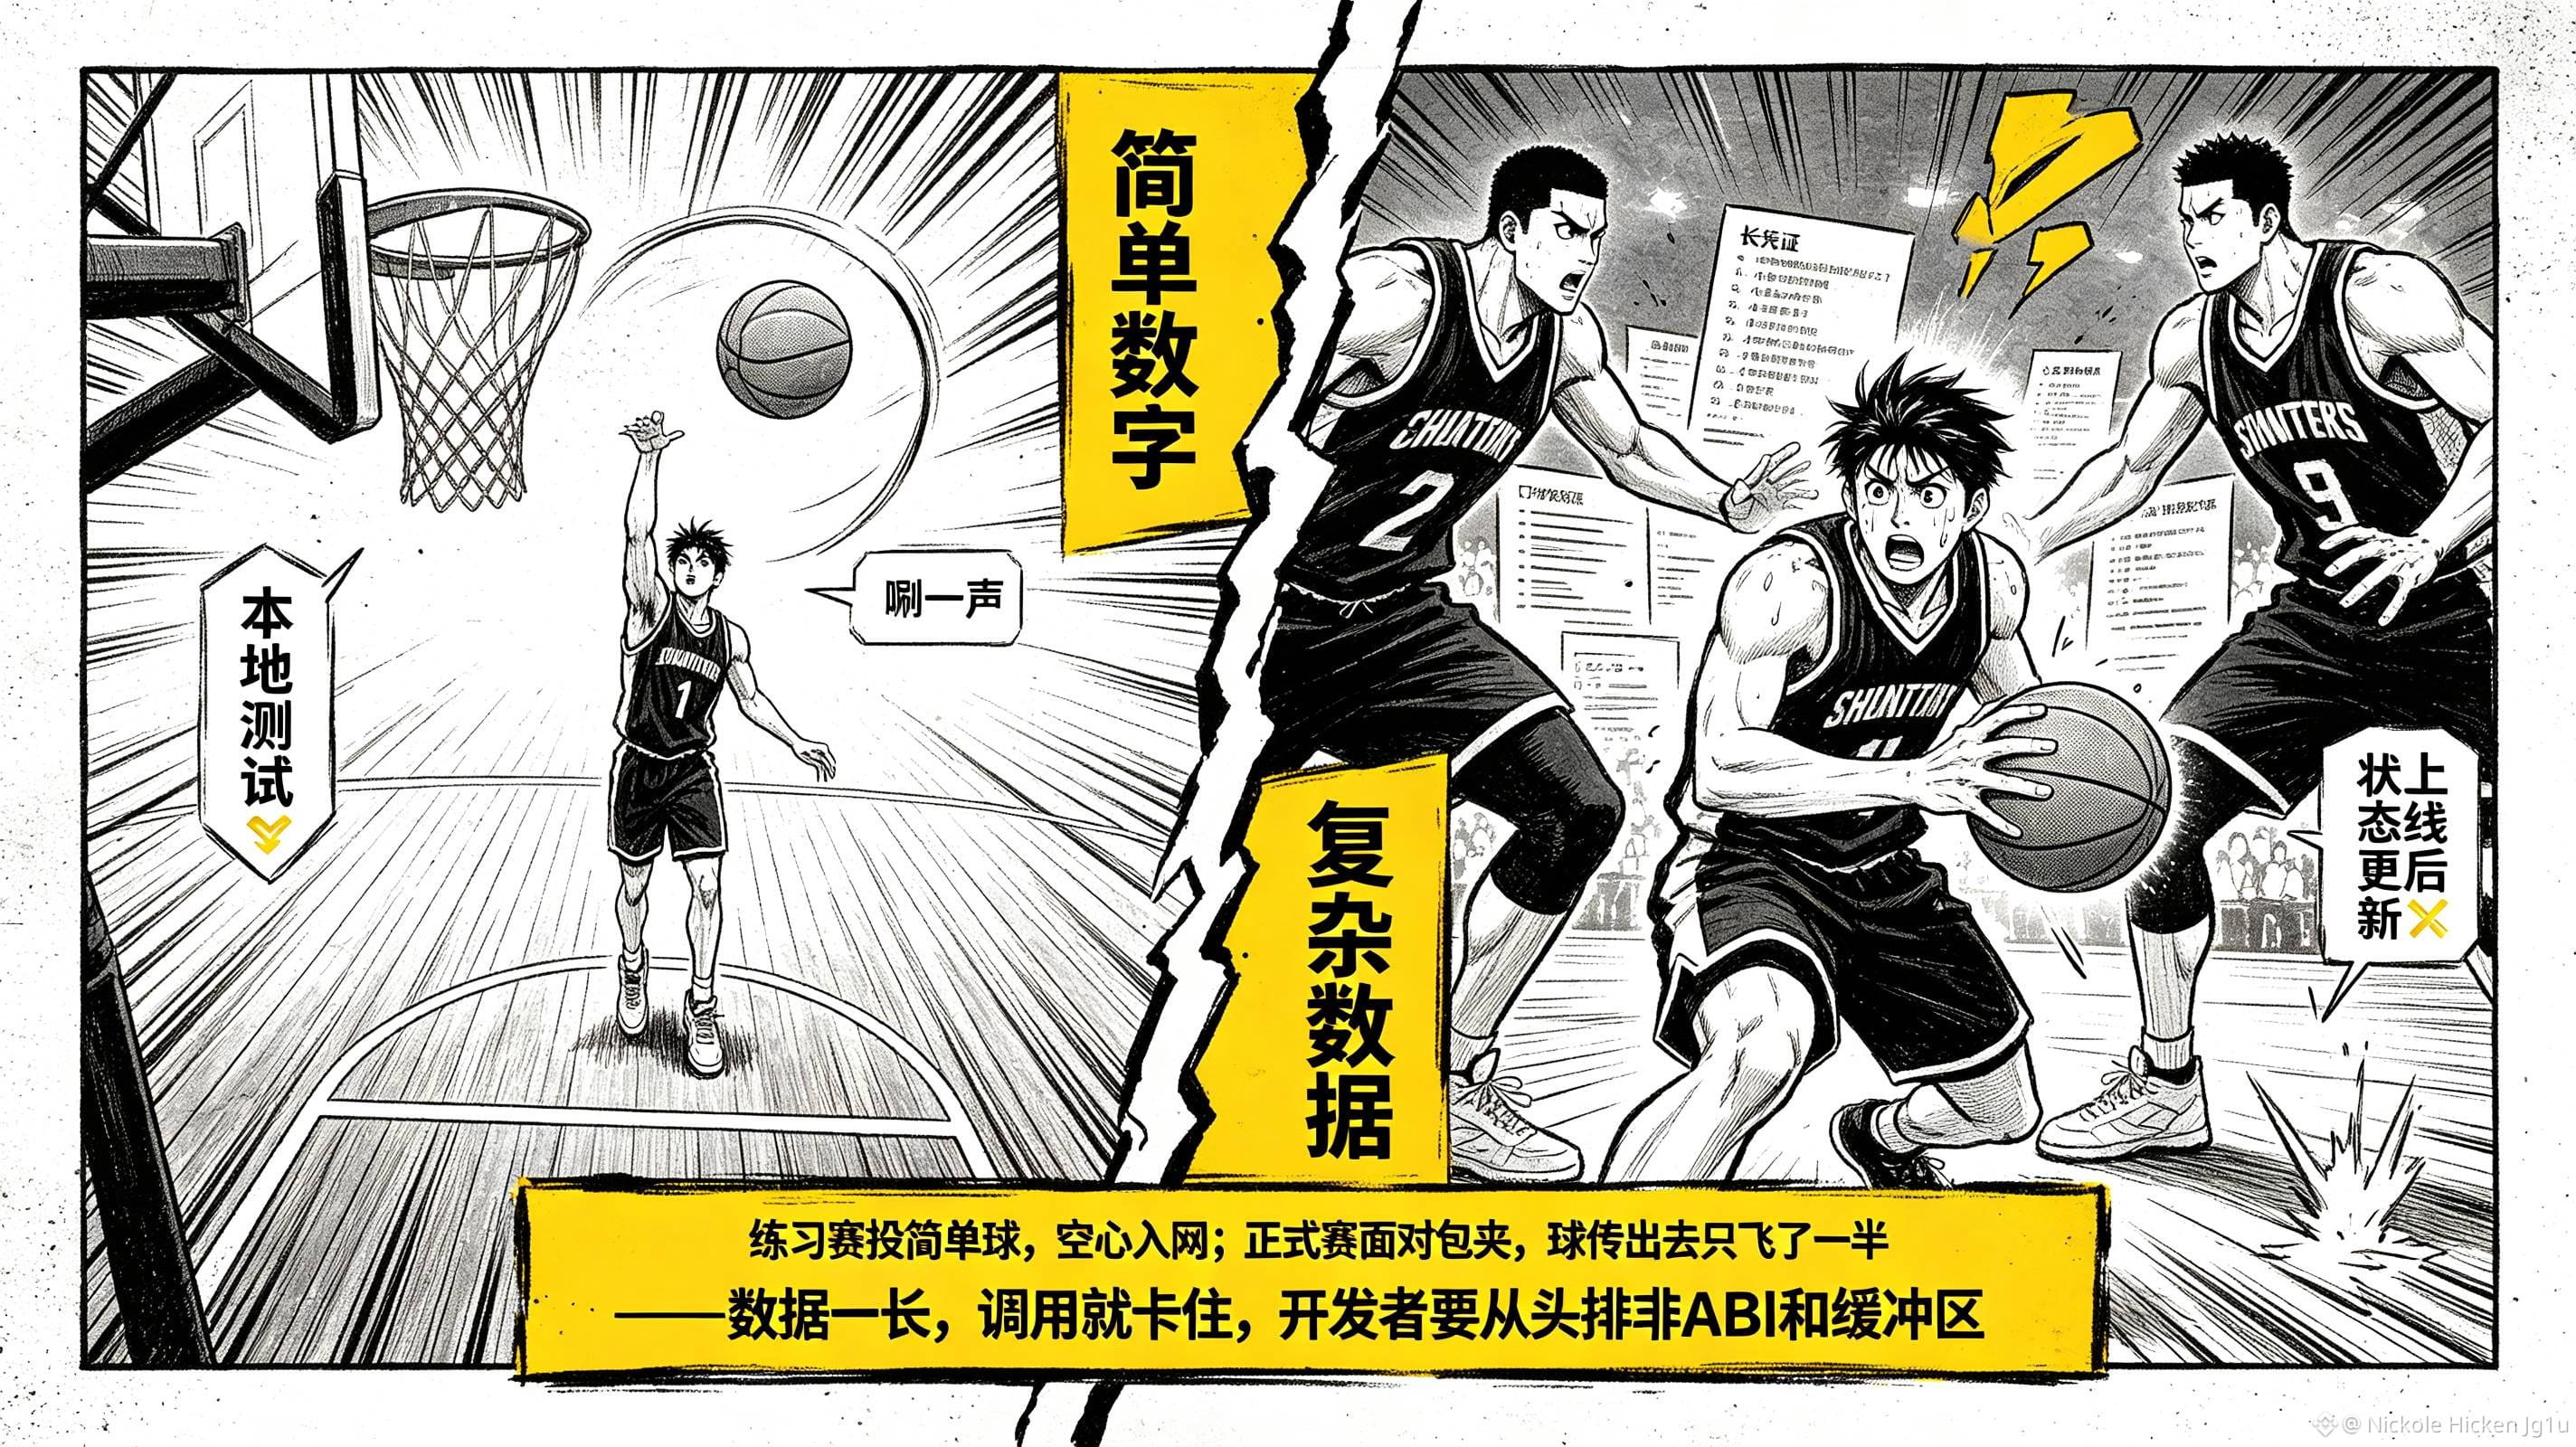
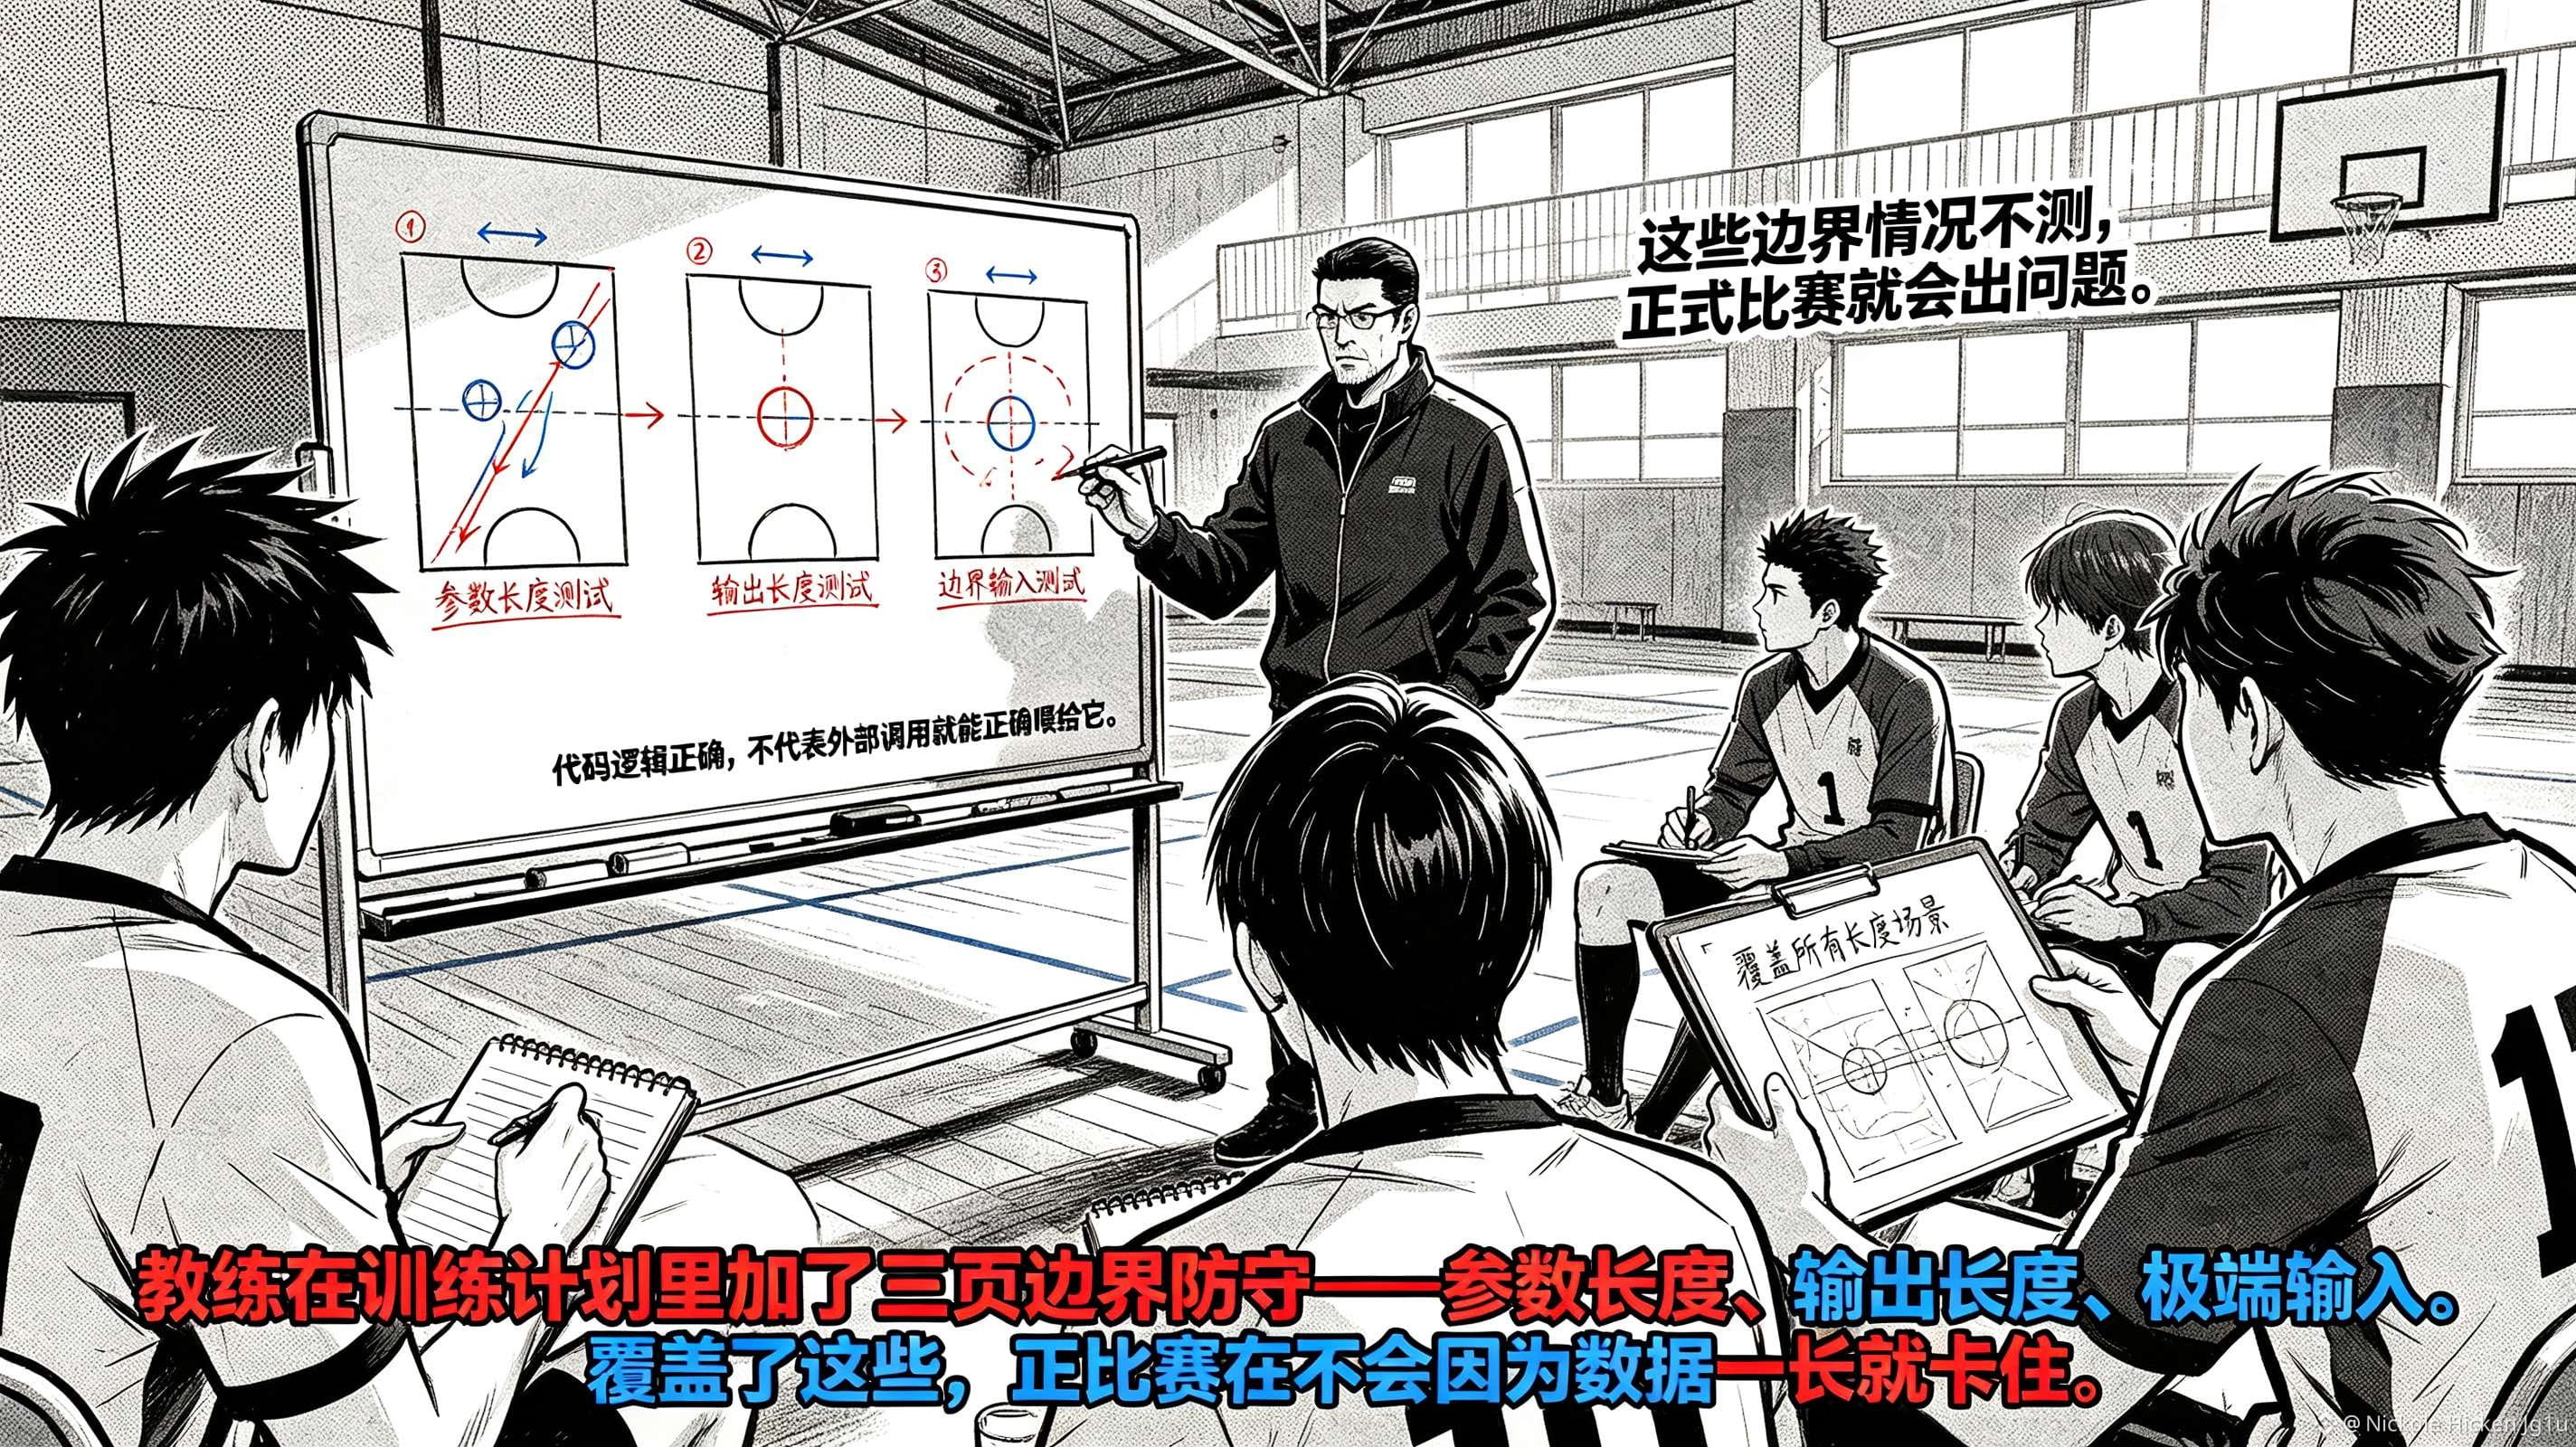
我原来以为合约能不能在DuskVM里跑起来主要看Rust代码有没有编译通过,但读了@Dusk のDuskVM说明后才发现真正容易卡住的地方更靠近调用边界:合约必须暴露一块64KB的argbuf,入口函数还要按fn foo(u32) -\u003e u32的格式接收输入长度、处理数据再返回输出长度,代码逻辑正确并不代表外部调用就能正确喂给它。这个设计让我重新看待开发成本,DuskVM不替开发者规定业务逻辑,却把输入和输出的内存边界交给合约自己负责。调用方传进来的并不是一串“随便能读的参数”,而是已经放进缓冲区并由长度决定读取范围的数据,如果序列化、长度判断以及输出写回有一处没对上,问题可能不会表现为明显的业务错误,前端只会收到一次失败的合约调用。压力场景其实很具体,资产应用在本地测试里只传一个简单数字时一切正常,上线后换成更长的凭证、订单或权限数据,合约仍然能被调用却读不完整或者返回截断结果。用户看到的是状态没有更新,开发者需要回头排查ABI、缓冲区以及数据驱动器,承担成本的并不是抽象的虚拟机,而是等待结果的用户和维护集成的团队。所以我现在看$DUSK 的DuskVM时不会只问它能不能执行Rust或WASM,会先看合约测试是否覆盖了参数长度、输出长度以及边界输入。@Dusk 把调用约定写得很明确,说明性能和可控性背后也有一份内存责任,对Dusk开发者来说真正值得验证的是复杂业务数据进入合约后边界是否仍然可预测。#dusk


投稿

--ブリッシュ