

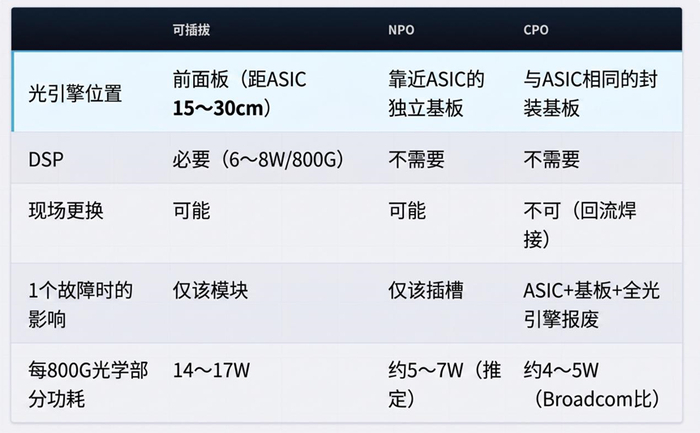
データセンターのラックを開くと、スイッチの前面パネルにはずらりと並んだ光トランシーバが見えます。人工知能クラスターでは、1台のスイッチに144個の800G対応QSFP-DDモジュールを搭載する構成が一般的です。しかし、この構成には構造的な非効率さという問題があります。前面パネルのトランシーバからスイッチのASICチップまでの距離は15〜30センチメートルです。200G/レーンの信号をこの銅線で伝送すると、かなりの減衰が起きるため、受信側ではDSP(デジタル信号処理)チップを用いて信号を復元する必要があります。単一の800Gモジュールの消費電力は14〜17ワットで、そのうち6〜8ワットがDSPチップに使われています。つまり、従来の着脱式光モジュールの消費電力の相当な部分は、直接光電変換に使われるのではなく、高速電気信号の調整、イコライゼーション、伝送に費やされているのです。
この距離を短縮できれば、DSPを使う必要はなくなる。この考え方は2010年代半ばにはすでに登場していた。共パッケージ光学(CPO)は、光エンジン(電気信号を光信号に変換する一連の部品)とスイッチASICのパッケージを同一基板上に置く設計で、ASICと光エンジン間の高速電気接続距離を大幅に短縮し、銅インターコネクトによる損失を大きく低減できる。ブロードコムは、CPOにより光システムの消費電力を65〜70%下げられると発表した。エヌビディアの1.6Tリンクの消費電力は、1リンクあたり約30Wから9Wへと削減されている。
理論上、CPOは最適解のように見える。だが問題は、理論と大規模生産との間にギャップがあることだ。
9%の歩留まりが真相を明らかにした
CPOの製造工程では、光エンジンはリフローはんだ(熱はんだ)によりASICパッケージ基板へ実装される。ファイバーのアライメント精度はサブミクロン級だ。すでに搭載済みの光エンジンを再装着するには、220〜260°Cに再加熱する必要があり、加熱位置はASICから数ミリ離れている。一方、ファイバーのアライメント精度は2回目の熱損傷に耐えられない。つまり、32個の光エンジンのうち1つに欠陥が出た場合、ASIC、基板、そして残りすべての光エンジンを廃棄しなければならない。
SemiAnalysisは2026年6月の研究レポート(Powered Down, Lights Off)で、各光学エンジンの実装(インプリメント)歩留まりが95%だと仮定し、総合歩留まりを0.9532≈0.1932と計算した。言い換えれば、32個の光エンジンが互いに独立しており、各光エンジンの歩留まりが95%であるという極端に単純化したモデルでは、32個すべてが通る組み合わせ歩留まりは約19.3%になる。つまり、正常に動くのは5分の1程度のエンジンだけということだ。この数字は市場に大きな影響を与えた。6月9日、米国市場では、アプリケーション・オプトエレクトロニクス(AAOI)の株価が1日で約17%下落し、Lumentumは約8%、Coherentは約11%、Marvellは約7.6%下落した。
GlobalSemiResearchは直ちに反論声明を出し、この計算が、ふるい分けやランク付け、さらにNVIDIAがSpectrum-X向けに設計した冗長エンジンによる歩留まり向上を無視していると指摘した。モルガン・スタンレーも6月10日のレポートで、CPOの技術ロードマップ自体は否定せず、ただし2027年の光学エンジン出荷予測を、それまでの2000万〜3000万個から600万〜700万個へ引き下げたと述べた。
この議論の焦点は「CPOは良くないのか?」ではなく、「いつ、そしてどのような規模でCPOを使えるのか?」だ。SemiAnalysisは、CPOの横展開における出荷量を2027年に延期し、全面的な量産を2028〜2029年に先送りした。このタイムラインの調整は、他アーキテクチャの探索に一つの窓を開いた。
NPOは何もかも揃っている
近接実装光学デバイス(NPO)は、パッケージ実装光学デバイス(CPO)とホットプラグ設計の中間に位置する。光エンジンは独立したエンジンボードに搭載され、ASICのパッケージ基板ではなく、かつASICのすぐ隣に置かれる。電気配線が十分に短く損失が十分に低ければ、従来のホットプラグ式光モジュールにおいて長距離の電気配線損失を補償するために用いられていたDSPを減らす、あるいは一部のアーキテクチャではなくすことも可能になる。しかしCPOとの重要な違いは、エンジンがソケットで接続されるため、現場で抜き差しできる点にある。
8月10日、SemiAnalysisはX-threadフォーラムで、NPOの3つの利点をまとめた。現地での修理が可能、故障の波及(影響範囲)は単一スロットに限定される、そして光エンジンとASICが独立したパッケージであるため組み立て工程が簡素化される、という点だ。この構造は、生産および信頼性の課題を回避しつつ、CPOの性能優位の大部分を維持する。
2026年3月のOFC展で、ブロードコムは3.2TのVCSELに基づくNPO製品ラインを発表した。同社のブログによると、このNPOエンジンのエネルギー効率は約1 pJ/bitで、通常のエネルギー効率が5〜10 pJ/bitのシリコンフォトニクス方式に比べ、5〜10倍の向上だという。エンジンを18個配備すると、逸脱帯域密度(逃逸帯域密度)は0.6 Tbps/mmを超え、総逃逸帯域は73.7 Tbps(128 Gbps/チャンネル)に達する。VCSELは量産実績が数十年あり、現地検証された故障率(FIT)は0.1未満。
標準化と大規模生産の歯車が回り始める
優れたアーキテクチャがあっても、エコシステムの支援がなければ広範な普及は実現できない。2026年3月12日、OFC会期中に、Ciena、Coherent、Marvell、Molex、Samtec、TeraHopの6社が共同でOpen CPX MSA(マルチソース共封装プロトコル)に署名した。この協定は、NPOとCPOを含むスロット型光エンジンのインターフェースに共通仕様を与えることを目的としている。これによりコネクタの機械構造、放熱設計、電気ピンの配置、管理インターフェースが標準化され、異なるメーカーの製品間の相互運用性が確保される。
LightCountingのCEO、ウラジミール・コズロフは、会社設立の発表時に「5年以内に年間出荷量が1億個を超える見込み」と述べ、一方で2025年時点のCPO/NPOの出荷量は100万個未満になる見通しだと語った。標準化がなければ、このような巨大な成長(場合によっては100倍超)は実現できない。
需要もまた変化している。2026年5月に開催されたIPECウェビナーで、アリババは3.2TのNPOベータテスト完了計画を明らかにし、同年の第3四半期からパイロット運用を開始する。目標は2027年9月までに6.4TのNPOアルファサンプルをシステムレベルで調整し終えることだ。テンセントも、3.2TのVCSEL NPOとシリコンフォトニクスNPOの検証を完了しており、2026年第4四半期にパイロット導入を行う予定。Ranovusは米国のクラウド企業にNPOモジュールを納入したが、正式な発表は2027年のOFC展で行うと見込まれている。
サプライチェーン面では、フオックスコンのインターコネクト技術が、2025年5月からブロードコムのBailly向けに、はんだ不要のLGA-to-LGAソケットと、着脱可能なレーザー光源ケージの大規模生産を開始している。レーザーは主にパッケージの外部に配置される設計であり、CPOでもNPOでも同様だ。また、OIFが2023年8月に定めたELSFP規格(ホットスワップ外部レーザーモジュール)が共通基盤として機能している。
なぜエヌビディアのCPOはNPOの特徴を示すのか
エヌビディアのQuantum-X Photonics InfiniBandスイッチは、量産配備を開始したとすでに発表している。144個の800Gポートを提供し、18個のシリコンフォトニクス・エンジンと、光源を供給する18個の着脱式外部レーザーモジュールを搭載する。エヌビディアはこれを「CPO」と呼んでいる。
しかし、エンジンはパッケージから容易に取り外せ、レーザーはフロントパネルからスライドして取り外せる。これこそがSemiAnalysisが考えるNPOの保守性の利点だ。LightCountingは2026年7月の調査レポートで、業界で広く言われる「CPOとNPOは併存する」という見方を裏付け、もしNVIDIAがNPOを選択肢として採用するなら開発期間が短縮され、最短で来年には初期の導入が見られる可能性があると指摘した。
ブロードコムは2つのアーキテクチャを並行して展開する。51.2TのBailly CPOスイッチは2024年からMicas Networksで量産が実現している。102.4TのTomahawk 6 Davissonスイッチは2025年10月から顧客への出荷を開始した。さらに、ブロードコムは、密度の高いスイッチを必要とするがはんだ付けは行いたくない顧客向けに、3.2TのVCSEL NPOスイッチも単独で提供する。
Metaの信頼性検証も着実に進んでいる。Metaの高温ラボ環境下で、ブロードコムのCPOシステムは累計100万時間の運転(400Gポート時間に相当)中、ゼロのリンクジッタ(瞬断)を記録した。ブロードコムは2025年10月にこの結果を発表し、同年のECOCと2026年のOFCで詳細を公開した。2026年のOFCでMetaは、「光技術が魅力的であるためには、コストとエネルギー効率の面で電気方式と同等であることに加え、信頼性と性能も提供しなければならない」という基準を提示した。
台積電のCOUPLEは重要な役割を担う
NPOの「移行段階」の終了は、大きくは台積電のCOUPE(コンパクト汎用フォトニックエンジン)プラットフォームの進捗次第だ。
上述の通り、よく知られているように、現在のAIチップの演算能力は非常に高いが、データがチップ間を伝送される際には、依然として銅線の導電に頼っている。銅線の伝送速度と消費電力は、演算能力の成長速度に徐々に追いつけなくなっている。COUPEの中核となる考え方は、データ伝送に光信号を使い、また光電変換の位置を遠端の光モジュールからチップのパッケージ内部へ引き寄せることで、信号が通らなければならない経路を大幅に短縮することにある。
COUPEは2種類のチップを一体化する。1つは電気信号を処理する(電子チップEIC)、もう1つは光信号を処理する(フォトニックチップPIC)。両者は台積電の3Dスタッキング技術により上下に直接積層され、対面接続するため、従来の方式で信号が回り道する回路基板のロスを省ける。
台積電は、回路基板上の差し替え可能なソリューションと比べて、COUPE光エンジンをパッケージ基板に直接統合することで、4倍の消費電力効率を実現し、遅延を90%削減できると示した。さらにCOUPEをインターポーザ(Interposer)に配置すれば、消費電力効率は10倍まで高まり、遅延は95%低下する。
COUPE技術はSOICのスタッキング方式を採用し、電子チップとフォトニックチップを直接積層することで、チップ間のインピーダンスを可能な限り低減する。最初のホットスワップ可能なCOUPEは2026年に量産開始される。第2世代のCOUPEは6.4TのCPOパッケージで、2027年頃の量産を見込む。第3世代の製品では、光学部品を完全にプロセッサのパッケージ内部へ統合する。
台積電のCOUPE帯域密度ロードマップ予測では、4年以内に帯域密度が8倍に向上し、2026年の0.5 Tbps/mmから2030年には4 Tbps/mmへ伸びるとしている。この計画が実現すれば、NPOの役割は2〜3年の移行期間に限られる。
しかし、SemiAnalysisが予測する2029年の全面量産シナリオが現実に近いなら、NPOは2020年代末まで市場需要を満たし続けることになる。その場合、すでにレーザーとパッケージング能力の両面で余裕がないフォトニクス供給チェーンに、追加の負荷がかかることになる。OCPアジア太平洋サミットで日月光(ASE)のNicole Tien氏は、現時点ではCPOを複数メーカー市場へ展開するためのウェハーレベルのテスト標準やシミュレーション基盤が存在しないと指摘した。エヌビディアのCPOの量産は、台積電(TSMC)と深い二者間協業によって得られた成果であり、これらを業界全体へ広げる条件はまだ整っていない。
業界では、光インターコネクトの究極形はCPOだと広く考えられている。問題は、誰がこの道を選ぶのか、いつ実現するのか、そしてどの程度の規模で展開できるのかという点だ。少なくとも現時点の製品ロードマップや顧客検証の状況を見る限り、NPOは技術検証から急速にスケール導入へ移行しており、より確かな答えになりつつある。