インフラを十分に運用してきたから分かるのは、本当のコストは障害そのものではなく、その後にあなたが何をするかだということです。
Duskノードがダウンしたり同期から外れたりすると、選択肢は2つあります。
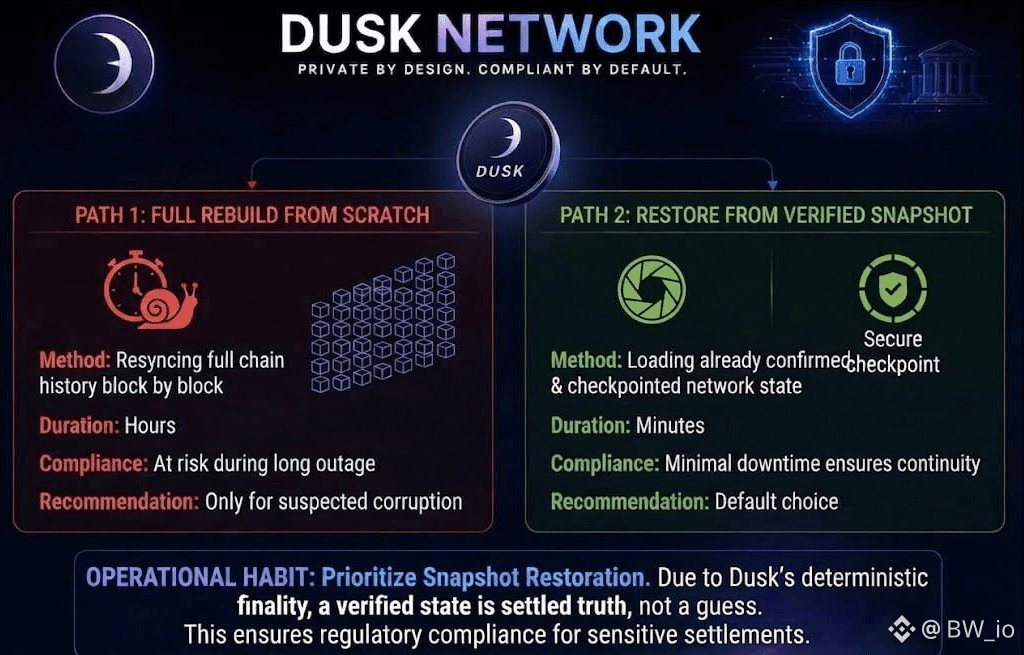
1つは、最初から作り直し、チェーン履歴をブロックごとにフルで再同期する方法です。これは安全ですが遅く、インシデント対応中に使える時間を何時間も奪います。 もう1つは、検証済みの状態スナップショットから復元する方法です。これはすでにチェックポイント化され、ネットワークのコンセンサスに対して確認済みのものなので、短時間でオンラインに戻れます。
私は毎回、後者を選びます。Duskの決定的ファイナリティ(最終確定性)により、検証済みの状態は推測ではなく、プロトコルがすでに同意して確定した真実だからです。
ここでは、多くのチェーンよりもそれが重要です。というのも、これらのノードは、単にガストランザクションを扱うだけでなく、規制された決済を支えることが多いからです。 実在する証券を動かすネットワークのダウンタイムは、単に不便なだけでなく、コンプライアンスの問題です。
そこで、私が推奨する運用上の習慣はシンプルです。スナップショット復元を近道として扱わず、デフォルトとして扱い、完全な再構築は本当に破損を疑うときにだけ行うのです。
小さな運用判断ですが、ダウンタイムが数分で済むか、何時間にもなるかの違いになります。
@Dusk #dusk $DUSK $GPS $STAR
Duskノードがダウンしたり同期から外れたりすると、選択肢は2つあります。
1つは、最初から作り直し、チェーン履歴をブロックごとにフルで再同期する方法です。これは安全ですが遅く、インシデント対応中に使える時間を何時間も奪います。 もう1つは、検証済みの状態スナップショットから復元する方法です。これはすでにチェックポイント化され、ネットワークのコンセンサスに対して確認済みのものなので、短時間でオンラインに戻れます。
私は毎回、後者を選びます。Duskの決定的ファイナリティ(最終確定性)により、検証済みの状態は推測ではなく、プロトコルがすでに同意して確定した真実だからです。
ここでは、多くのチェーンよりもそれが重要です。というのも、これらのノードは、単にガストランザクションを扱うだけでなく、規制された決済を支えることが多いからです。 実在する証券を動かすネットワークのダウンタイムは、単に不便なだけでなく、コンプライアンスの問題です。
そこで、私が推奨する運用上の習慣はシンプルです。スナップショット復元を近道として扱わず、デフォルトとして扱い、完全な再構築は本当に破損を疑うときにだけ行うのです。
小さな運用判断ですが、ダウンタイムが数分で済むか、何時間にもなるかの違いになります。
@Dusk #dusk $DUSK $GPS $STAR