分散型AIはどうやってスケールすべき? @OpenGradient
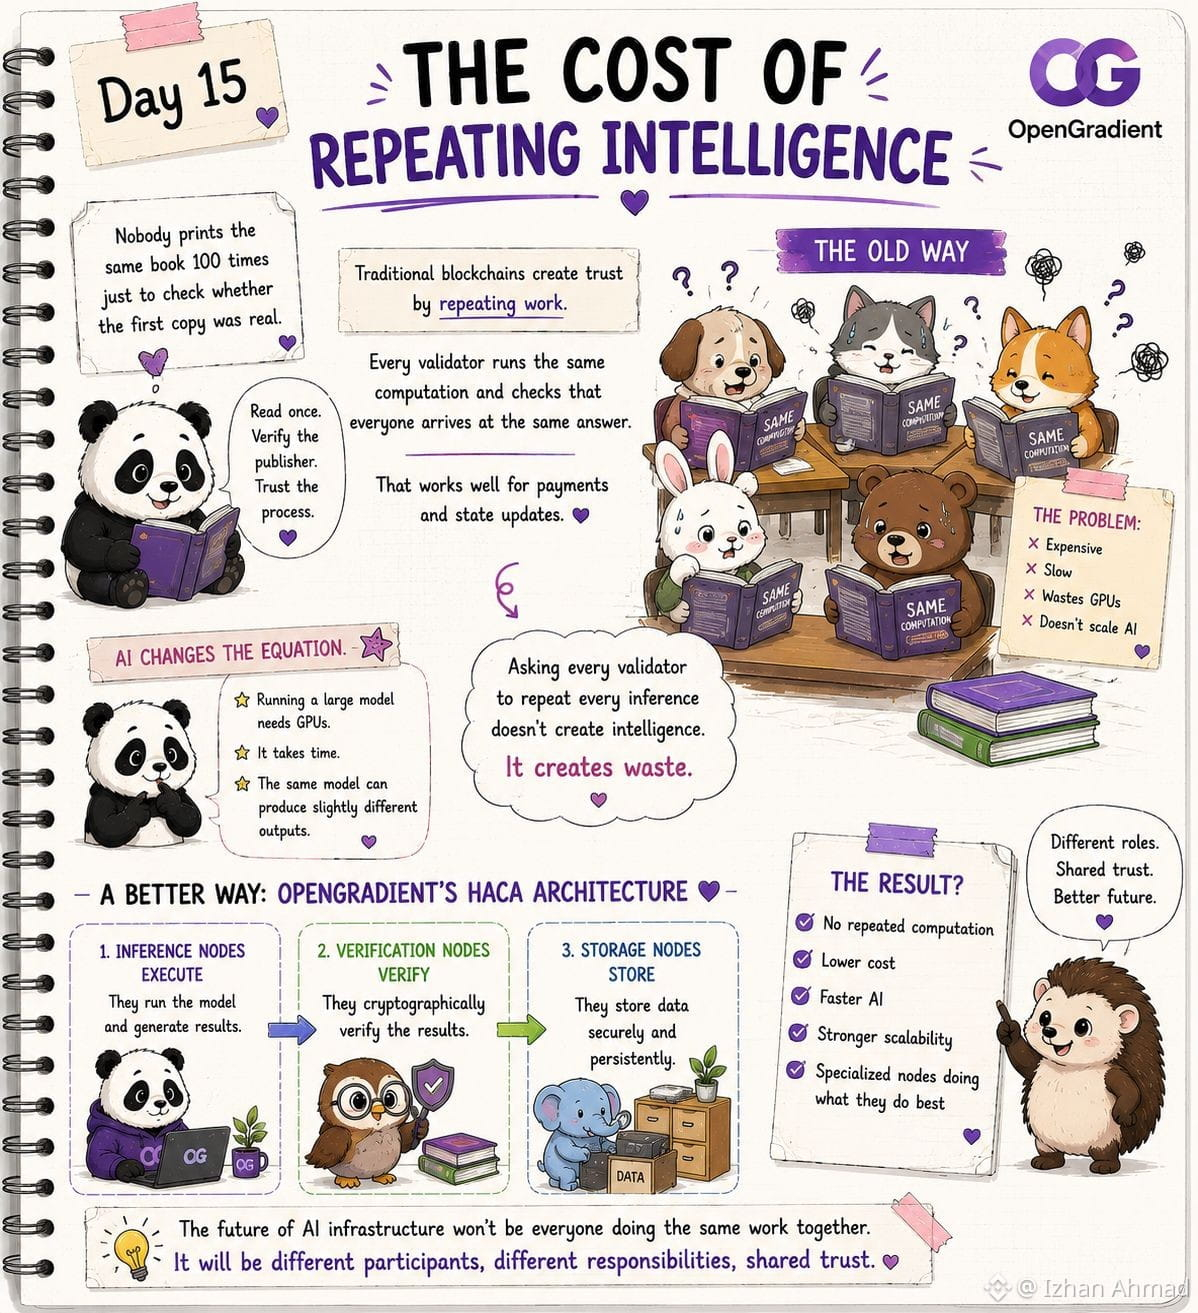
誰も最初のコピーが本物かどうか確認するために、同じ本を100回も印刷しない。
それは馬鹿げている。
あなたは一度本を読み、出版社を確認し、それを生み出したプロセスを信じる。ブロックチェーンとAIがどのように相互作用するのかを調べながら、その考えが私の頭に残った。従来のブロックチェーンは、仕事を繰り返すことで信頼を作る。すべての検証者が同じ計算を実行し、誰もが同じ答えに到達したことを確認する。支払いのような取引やシンプルなトランザクションでは、そのアプローチは驚くほどうまく機能する。
しかしAIは方程式を変える。大規模モデルを動かすことは、トークンの送金を確認するのとは違う。GPU、時間、そして多大なリソースが必要だ。同じモデルでも、動かし方によっては少し異なる出力になることさえある。すべての検証者に、すべての推論を繰り返させても、それは知性を増やすことにはならない。
むしろ、無駄が増える。
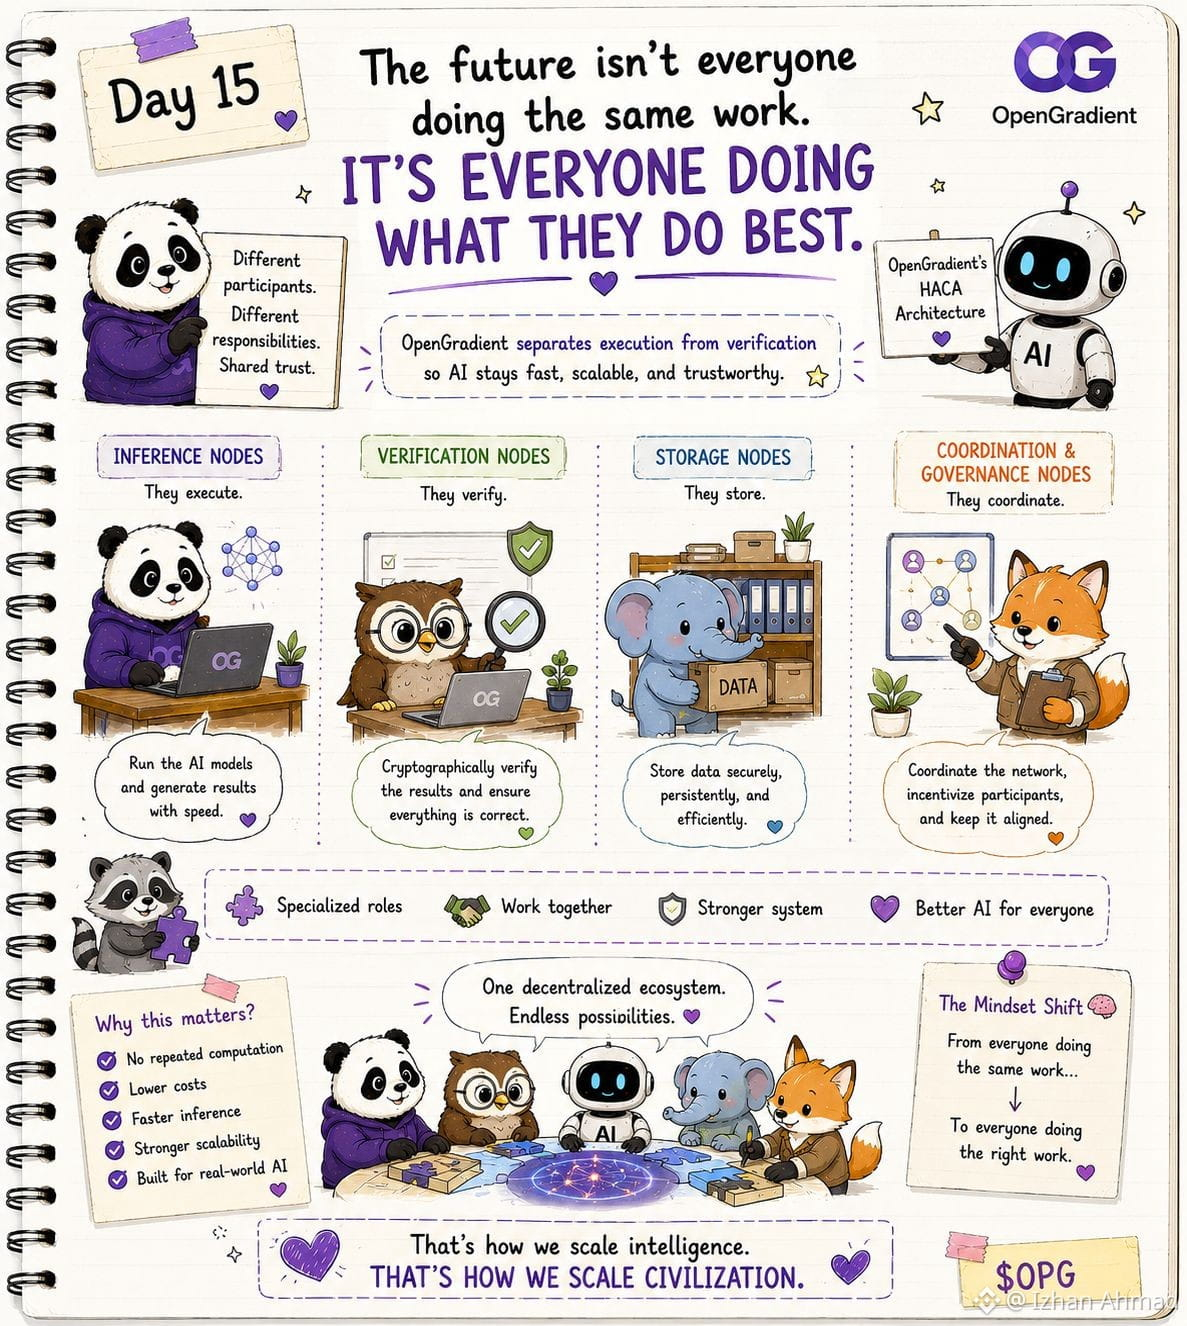
私が特に興味深いと思った@OpenGradient architectureの一つの要素は、すべてのノードにすべてをやらせるのではなく、実行と検証を分離するという判断だ。推論ノードは実行する。検証ノードは検証する。ストレージノードは保存する。各参加者は自分が得意なことに集中し、ネットワークは共有された信頼を維持する。
考えれば考えるほど、AIインフラの未来は、みんなが同じ仕事を一緒にやるようにはならないのではないかと疑問に思う。たぶん社会のように見えるだろう。参加者はそれぞれ違い、責任もそれぞれ違う。共有された信頼がある。これは計算をスケールするというより、文明をスケールする感じがする。
#OPG #AIInfrastructure #verifiableAI #HACA #DecentralizedAI $OPG $TAC $UB
誰も最初のコピーが本物かどうか確認するために、同じ本を100回も印刷しない。
それは馬鹿げている。
あなたは一度本を読み、出版社を確認し、それを生み出したプロセスを信じる。ブロックチェーンとAIがどのように相互作用するのかを調べながら、その考えが私の頭に残った。従来のブロックチェーンは、仕事を繰り返すことで信頼を作る。すべての検証者が同じ計算を実行し、誰もが同じ答えに到達したことを確認する。支払いのような取引やシンプルなトランザクションでは、そのアプローチは驚くほどうまく機能する。
しかしAIは方程式を変える。大規模モデルを動かすことは、トークンの送金を確認するのとは違う。GPU、時間、そして多大なリソースが必要だ。同じモデルでも、動かし方によっては少し異なる出力になることさえある。すべての検証者に、すべての推論を繰り返させても、それは知性を増やすことにはならない。
むしろ、無駄が増える。
私が特に興味深いと思った@OpenGradient architectureの一つの要素は、すべてのノードにすべてをやらせるのではなく、実行と検証を分離するという判断だ。推論ノードは実行する。検証ノードは検証する。ストレージノードは保存する。各参加者は自分が得意なことに集中し、ネットワークは共有された信頼を維持する。
考えれば考えるほど、AIインフラの未来は、みんなが同じ仕事を一緒にやるようにはならないのではないかと疑問に思う。たぶん社会のように見えるだろう。参加者はそれぞれ違い、責任もそれぞれ違う。共有された信頼がある。これは計算をスケールするというより、文明をスケールする感じがする。
#OPG #AIInfrastructure #verifiableAI #HACA #DecentralizedAI $OPG $TAC $UB
Everyone verifies everything
50%
Specialized nodes with trust
0%
Centralized AI providers
50%
Not sure yet
0%
4 投票 • 投票は終了しました