
これまで皆さんが Marvell を見るとき、最初に思い浮かべるのは AI ASIC、光インターコネクト、SerDes、DSP、シリコンフォトニクス、DCI でした。
しかし今回、Structera X と Structera A の重点は、MRVL を「AIのメモリボトルネック」という主ラインに引き込むことです。
いまAIデータセンターで最も高価なものは、GPUだけではありません。
メモリもますます高くなっています。
長いコンテキスト、多数のエージェント、推論サービス、ベクトルデータベース、インメモリデータベース、レコメンドモデル——これらのシーンはすべて、狂ったようにDRAMを消費しています。
GPUは計算を担当します。
メモリは記憶を担当します。
光インターコネクトはデータ転送を担います。
メモリが足りなければ、GPUがどれだけ強くても詰まります
これが今回のMRVLのCXLソリューションの意義です。
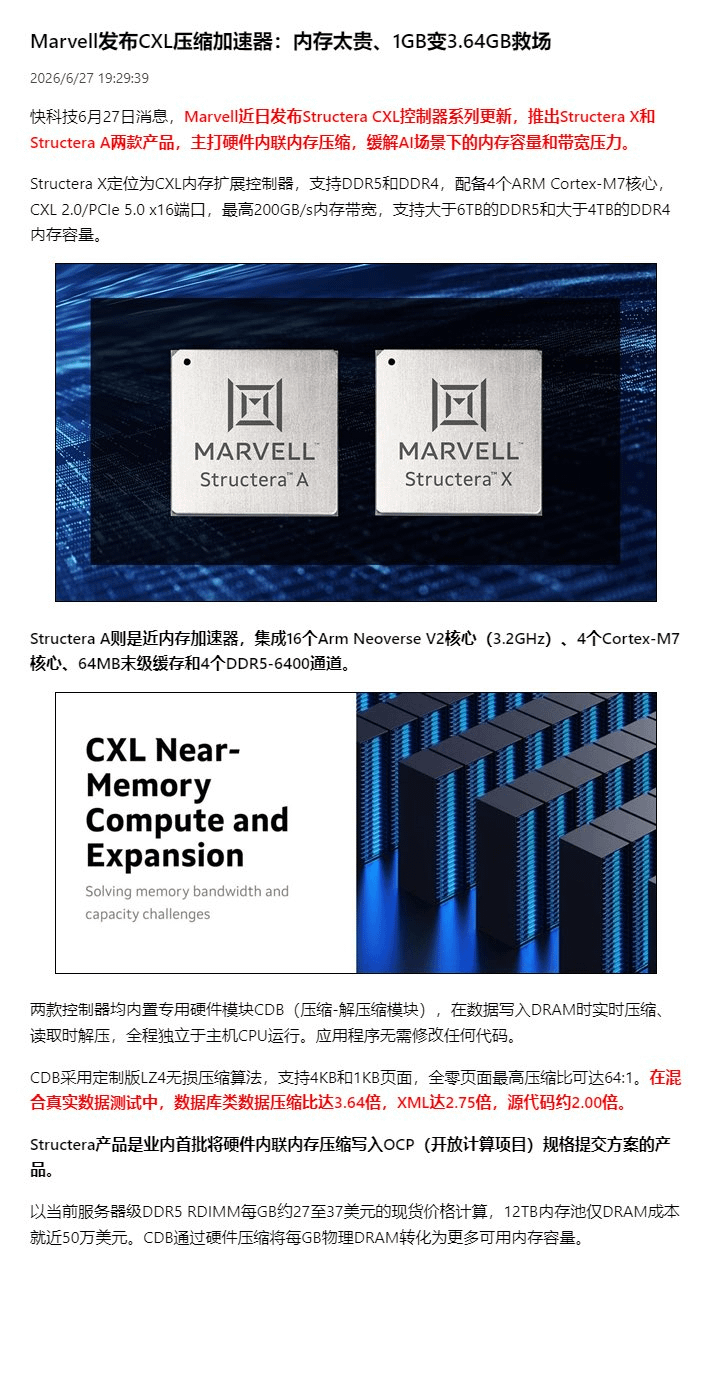
Structera XとStructera Aの核心は、単にメモリーコントローラーを追加することではありません。CXLを通じてサーバー外部のDRAMを接続し、さらにハードウェアによるインライン圧縮を使って、物理メモリ1GBからより大きな使用可能容量を引き出します。
公式データによると、データベース系データの圧縮率は最大3.64倍に達します。
XMLは約2.75倍です。
ソースコードは約2.0倍です。
もちろん、すべてのデータが1GBから3.64GBになるという意味ではありません。
圧縮率はデータの種類によって異なります。
ただし重要なのは、
ハイパースケーラーが圧縮可能なデータの一部をハードウェア圧縮で処理し、実効メモリ容量を増やせれば、DRAMの調達を大幅に増やさずにメモリ不足とコストの圧力を和らげられます。
これはクラウド事業者にとって非常に魅力的です。
現在、サーバー向けDDR5 RDIMMはすでに非常に高価だからです。
12TBのメモリプールでは、DRAMだけでコストが50万ドル近くに達する可能性があります。
AIインフラの拡大ペースが半導体工場の供給能力を上回ると、メモリは単なる部品ではなく、戦略的資源になります。
これは、最近のMicronの決算から読み取れる見方と同じ流れにあります。
AIによって、ストレージとメモリは景気循環商品から、インフラのボトルネックとして再評価されつつあります。
$MU HBM、DRAM、NANDの供給問題を解決します。
$MRVL 今回解決するのは次の課題です。
メモリがますます高価になるなか、1GBあたりの価値をどう高めるか。
これがStructeraの真の注目ポイントです。
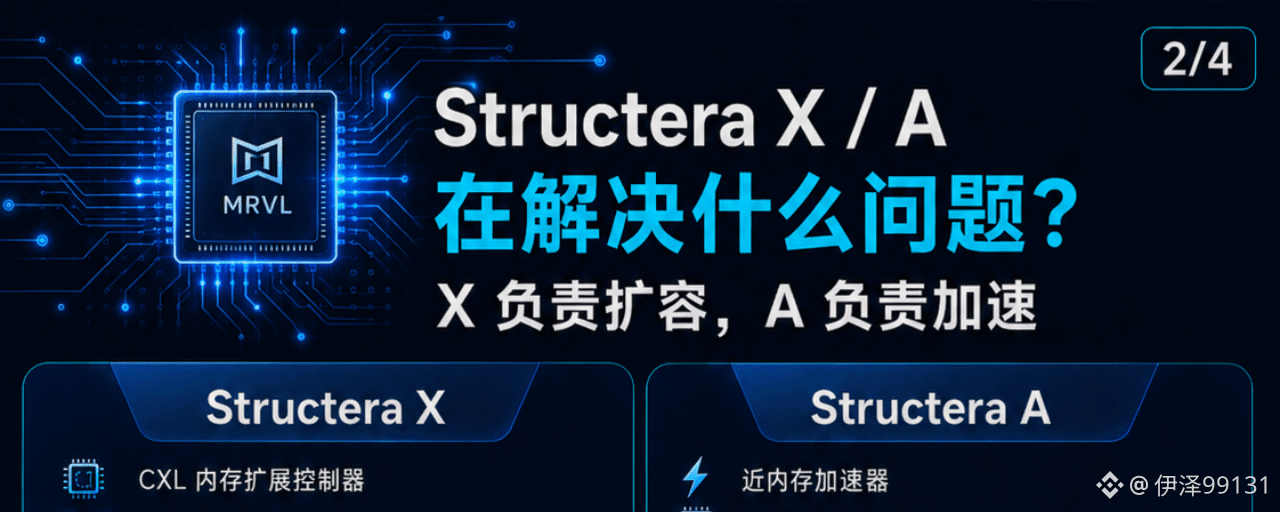
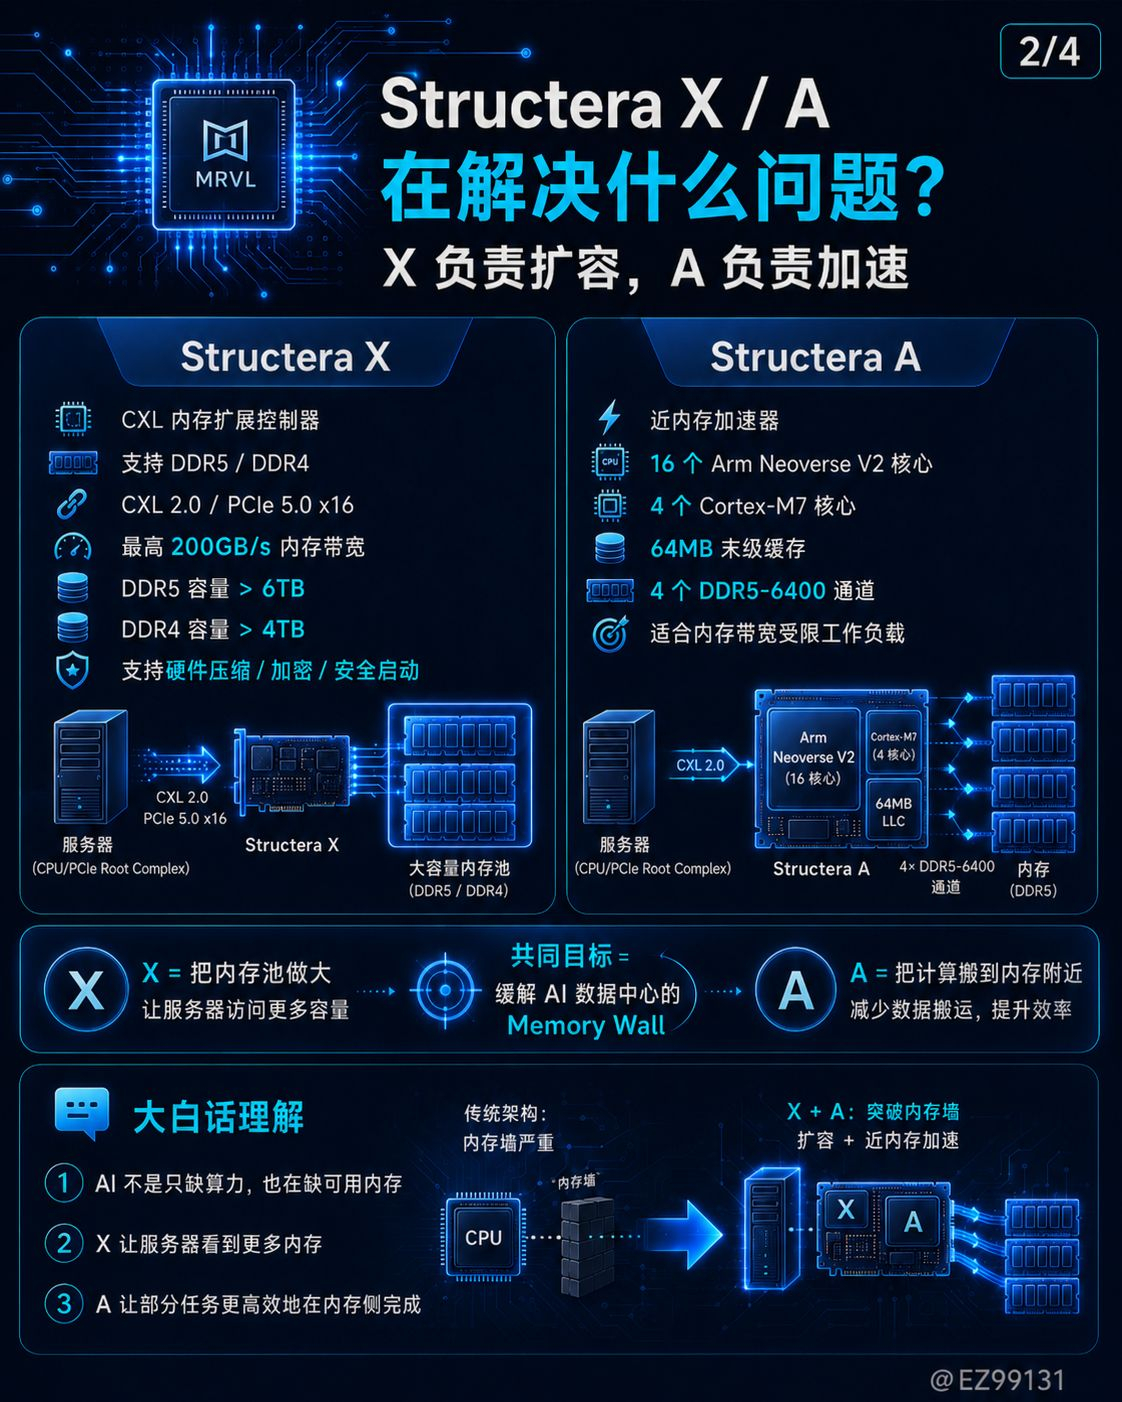
Structera Xは、どちらかといえばメモリ拡張コントローラーです。
サーバーのメモリプールをどう拡大するかという課題を解決します。
Structera Aは、どちらかといえば近メモリ計算アクセラレーターです。
メモリ帯域幅が制約となる一部のタスクで、計算をメモリの近くに移せるかどうかが課題です。
簡単に言うと:
Xは容量拡張を担います。
Aは高速化を担います。
両者がともに解決するのは、AI時代のデータセンターにおけるメモリの壁です。
Structera製品ラインが登場したのは今回が初めてではなく、最初の発表は2024年だからです。
今回は、Marvellが「CXL+ハードウェア圧縮」の経済的価値を改めて前面に押し出したように見えます。
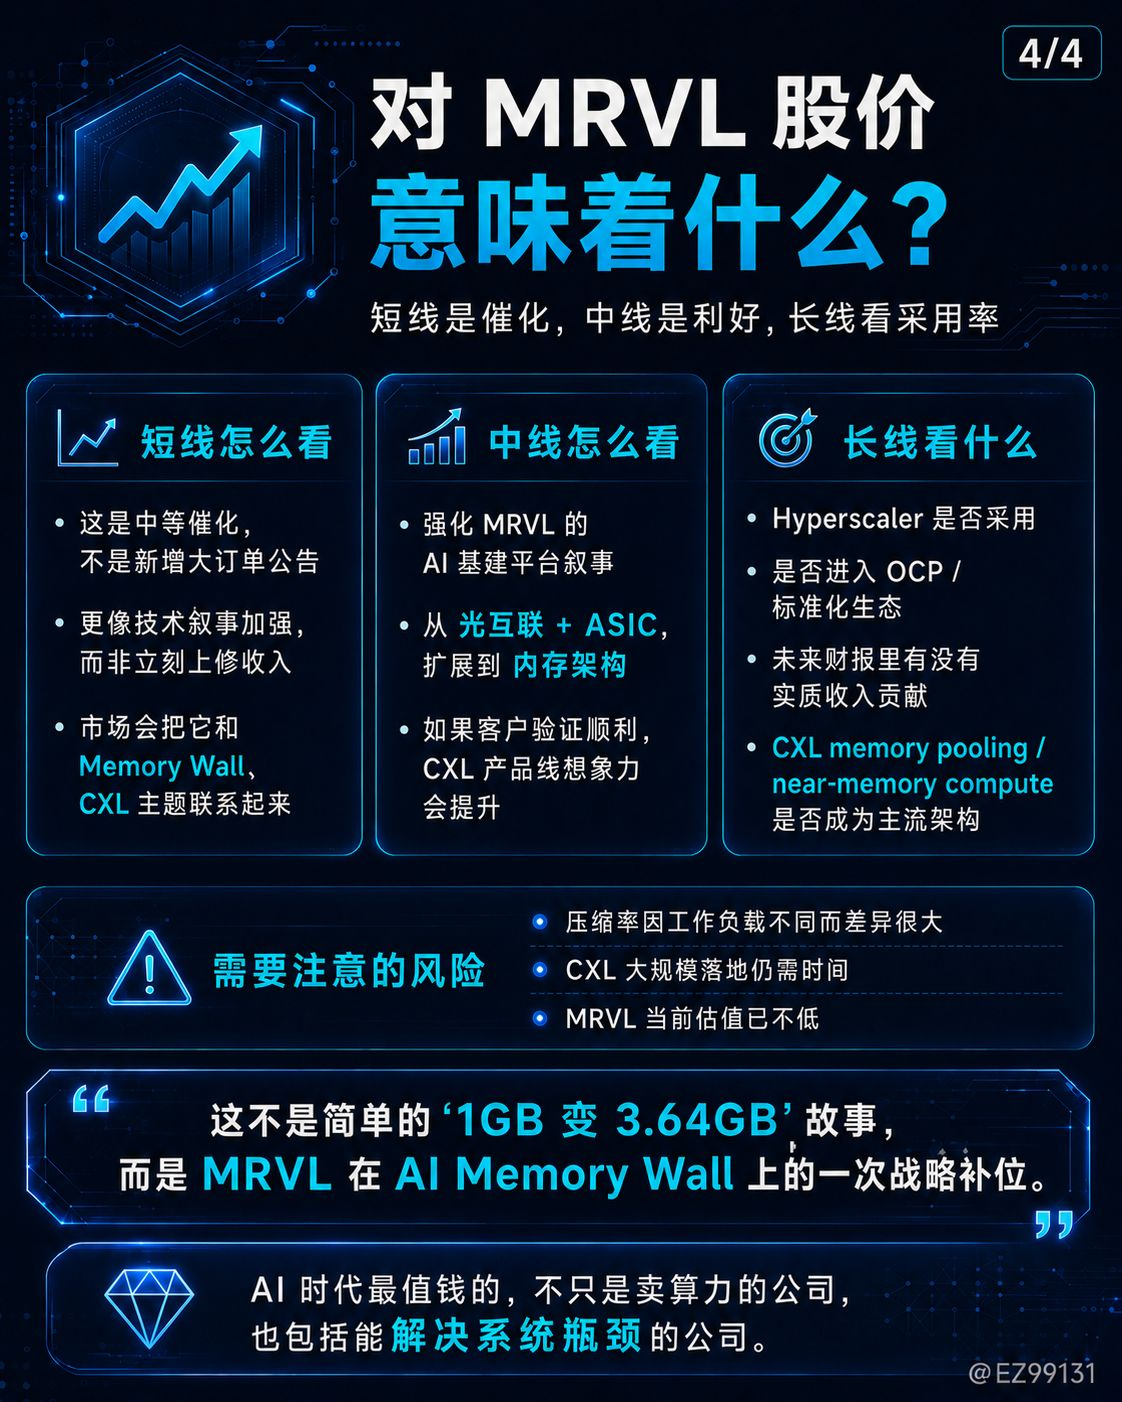
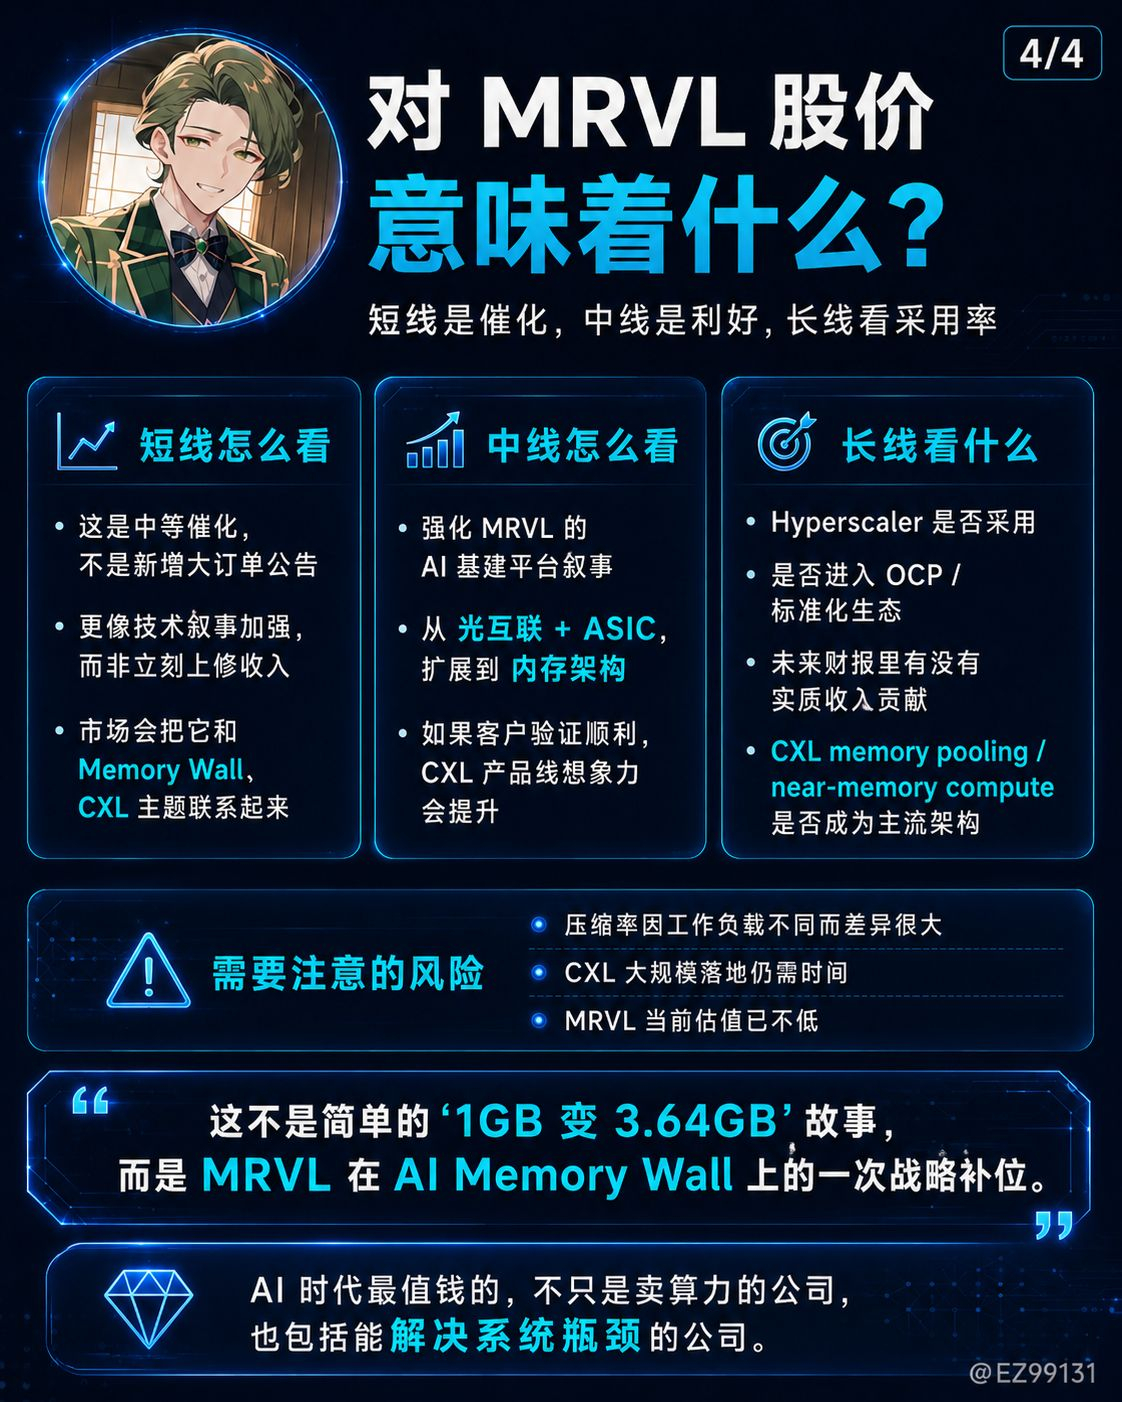
そのため、短期的には従来の意味での受注好材料ではありません。
ただし中長期的には、MRVLのストーリーにとって非常に重要です。
MRVLのAIインフラのパズルがますます完成に近づいているからです。
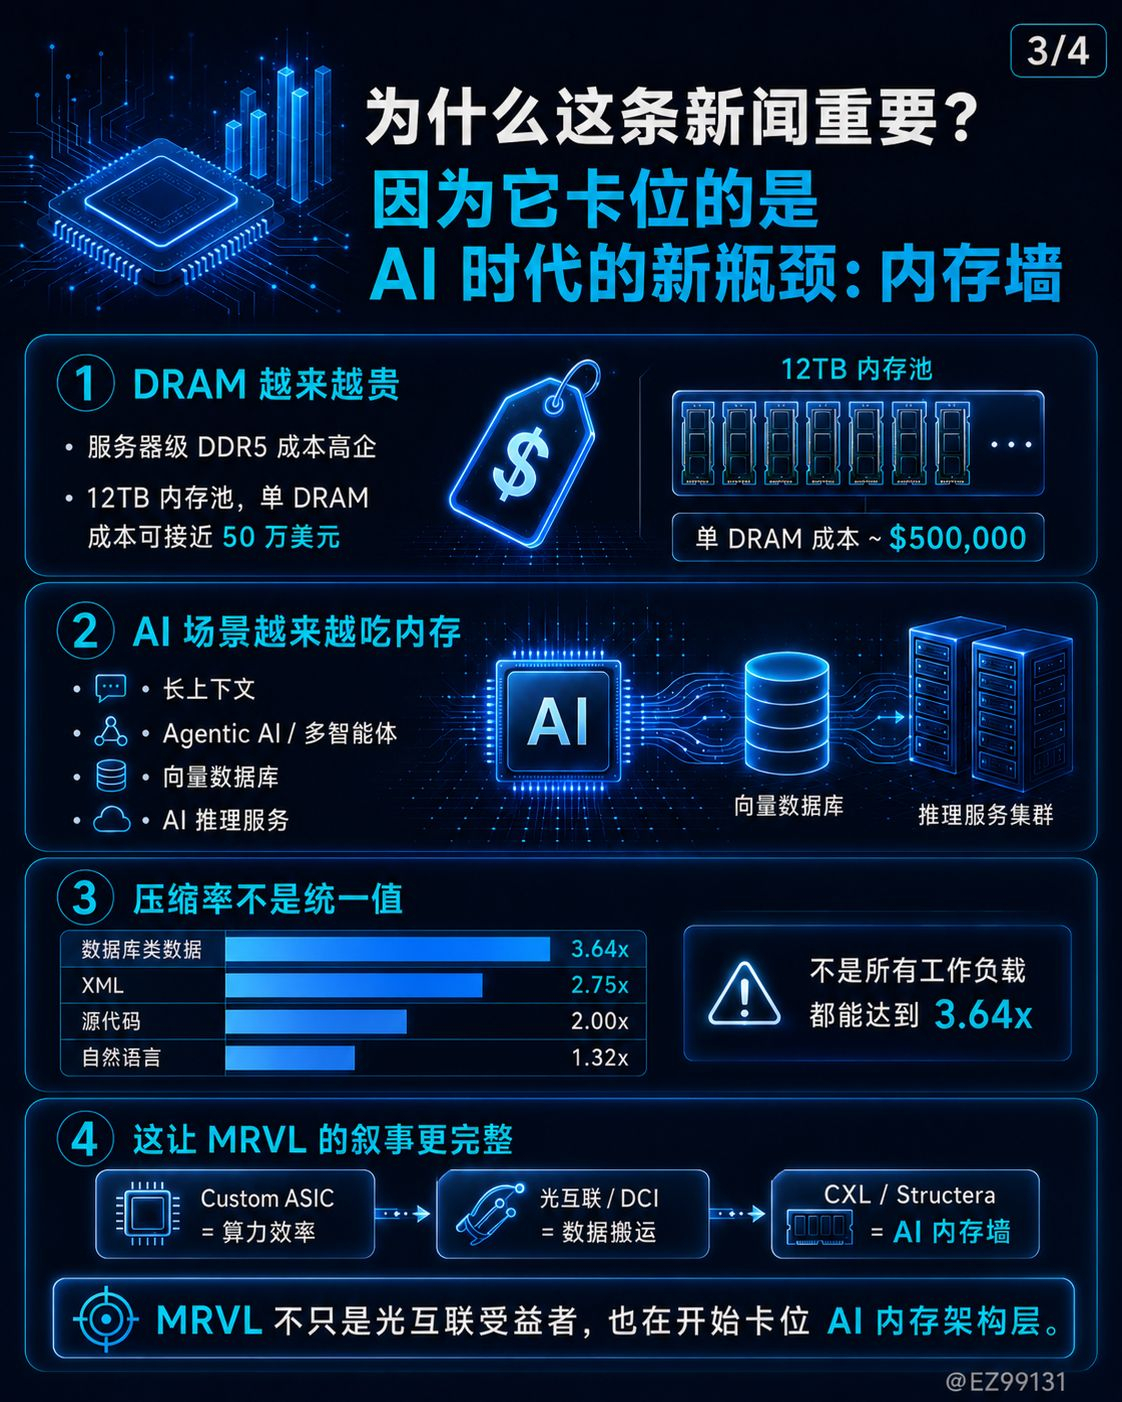
1つ目はカスタムASICです。
AI計算の効率を高めます。
2つ目は光インターコネクトとコヒーレントDCIです。
AIのデータ移動を解決します。
3つ目はCXLとメモリ拡張です。
AIのメモリの壁を解決します。
さらにCelestial AIのフォトニックファブリックが加われば、Marvellは実のところ、ある方向へと進んでいます。
単一のチップを売るだけではありません。
AIデータインフラの中核となる半導体プラットフォームを目指しています。
これは非常に重要な点です。
AIインフラの次の段階で注目されるのは、GPUを提供できる企業だけではありません。
それは、誰がシステムレベルのボトルネックを解決できるかということです。
計算のボトルネック
メモリのボトルネック
ネットワークのボトルネック
消費電力のボトルネック
データセンターが大きくなるほど、ボトルネックも増えます。
そしてMRVLは、まさに多くのボトルネックの間に位置しています。
これは、Marvellが光インターコネクトの恩恵を受けるだけでも、純粋なASICの恩恵を受けるだけでもないことを示しています。
メモリアーキテクチャの面でも、足場を築こうとしています。
将来、CXLメモリプーリング、CXL拡張、近メモリ計算がハイパースケーラーの標準アーキテクチャになれば、Structeraは大きな可能性を秘めた製品ラインとなるでしょう。
リスクは次のとおりです。
第1に、このニュースは現時点では技術や製品に関するストーリーが中心で、新たな大型受注の発表ではありません。
第2に、CXLの大規模導入には、顧客による検証、エコシステムの成熟、ソフトウェアの対応が必要です。
第3に、圧縮率はどのような場面でも3.64倍になるわけではなく、実際の効果はワークロードによって異なります。
第4に、MRVLの現在のバリュエーションはすでに高く、技術的なストーリーにとどまらず、これらの製品が最終的に決算に反映されることを市場は求めています。
ハイパースケーラーに大規模採用されれば、その意義は非常に大きいでしょう。
これが本当に強化するのは、ある見方です。
AI時代には、メモリの壁が光インターコネクトと同じくらい重要なインフラ上のボトルネックになりつつあります。
そしてMarvellは、この2つの壁に同時に取り組んでいます。
これは「1GBが3.64GBになる」という誇張ではありません。
これは、AIのメモリの壁という分野におけるMRVLの戦略的な補完策です。
AI計算が拡大し続ければ、将来最も価値の高い企業は、計算能力を売る企業だけではありません。
計算能力がメモリ、ネットワーク、データ移動によって損なわれないようにする企業も含まれます。
$MRVL はこのポジションに近づきつつあります。