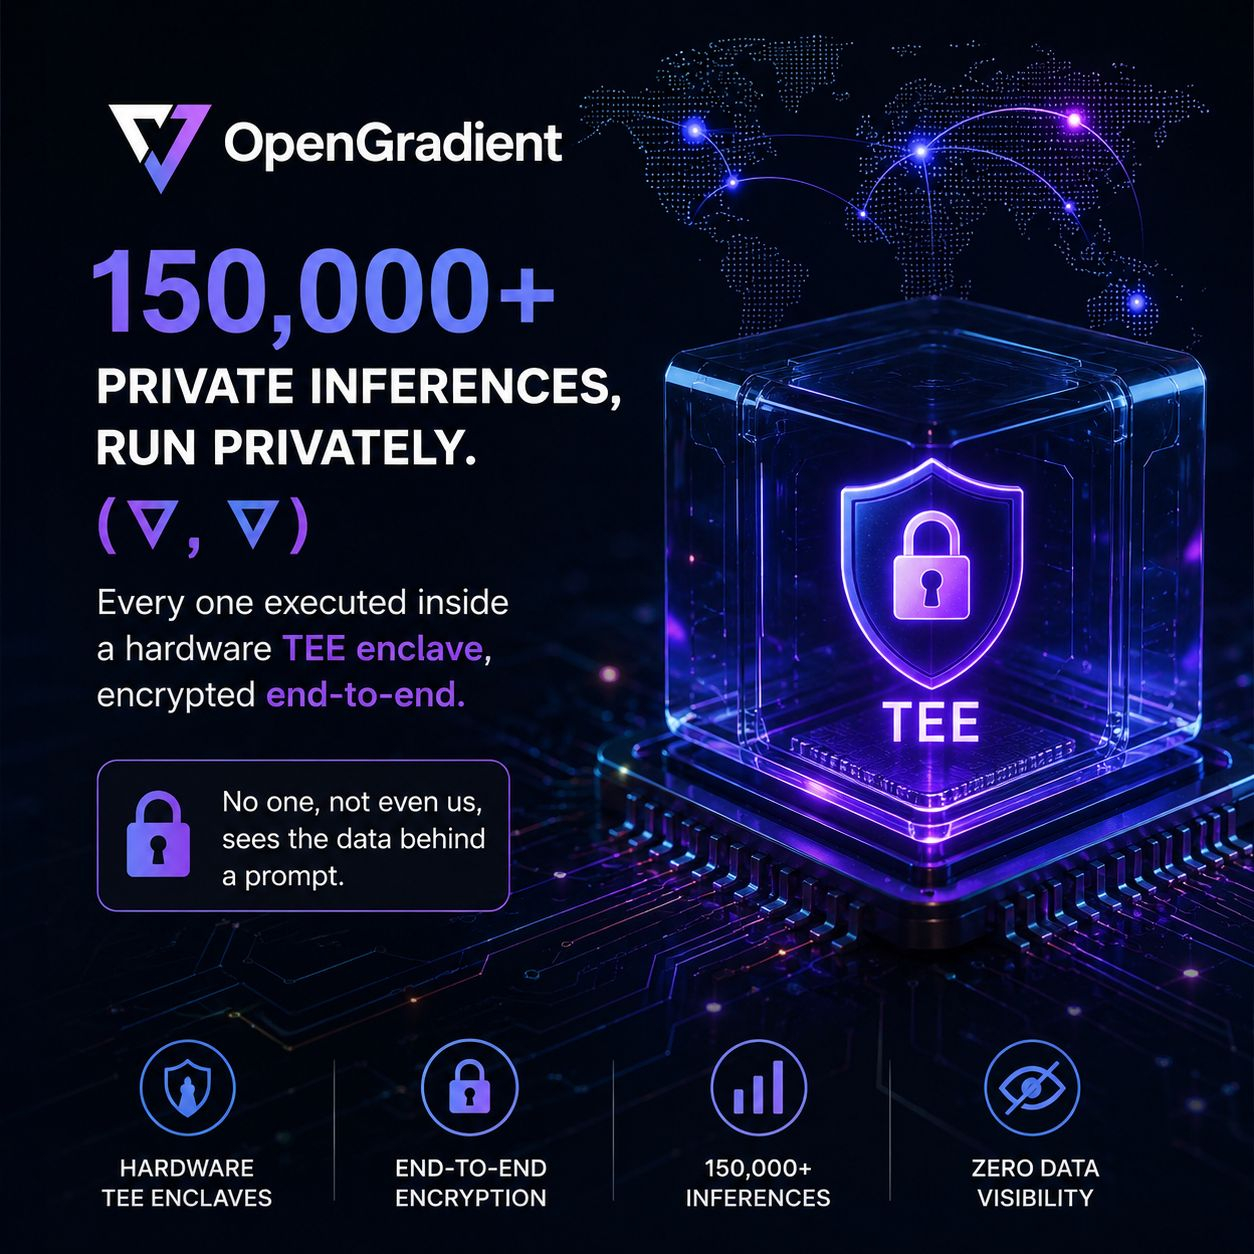
私が注目するのは、機密AIが暗号技術の難問というよりも、リソース配分の課題になりつつあることです。TEEエンクレーブ内で15万件以上のプライベート推論を実行できることは、安全な実行が意味のある規模で動作し得ることを示していますが、規模だけでは長期的な実現性は決まりません。重要なのは、需要が増えるにつれて、機密実行が経済的に競争力を保てるかどうかです。
分散型AIでは、信頼はしばしば二値の性質として扱われます。つまり、実行が検証可能であり、かつ秘密性が保たれているか、そうでないかです。しかし実際には、信頼はコスト曲線上に存在します。アテステーションの各層、エンクレーブの隔離、セキュアな状態管理は、セキュリティ保証を高める一方で、別の方法ならスループットを増やせたはずのリソースを消費します。ネットワークが成長するほど、このトレードオフは純粋なセキュリティ問題というより、インフラの問題になっていきます。
私の見立てでは、最も成功するAIインフラプロジェクトは、必ずしも最も強力なプライバシー保証を備えたものではありません。信頼性対コストの比率が最も優れているものが成功するでしょう。この違いが重要なのは、開発者が最終的に導入可能性を最適化するからです。もし機密実行がレイテンシや運用コストを大幅に引き上げるなら、リアルタイム推論を必要とするアプリケーションは、信頼の前提が弱いものの性能特性に優れたアーキテクチャへ移行する可能性があります。
本当の課題は、成功がそれ自体でボトルネックを生み出し得ることだと思います。もし機密AIがWeb3全体に広く採用されるなら、保護された計算への需要は、それを支えるよう設計されたインフラよりも速く増えるかもしれません。その場合、今後のネットワークは最大の信頼を最適化すべきでしょうか、それとも最大のスケーラビリティを最適化すべきでしょうか?🤔
#OPG @OpenGradient $OPG
分散型AIでは、信頼はしばしば二値の性質として扱われます。つまり、実行が検証可能であり、かつ秘密性が保たれているか、そうでないかです。しかし実際には、信頼はコスト曲線上に存在します。アテステーションの各層、エンクレーブの隔離、セキュアな状態管理は、セキュリティ保証を高める一方で、別の方法ならスループットを増やせたはずのリソースを消費します。ネットワークが成長するほど、このトレードオフは純粋なセキュリティ問題というより、インフラの問題になっていきます。
私の見立てでは、最も成功するAIインフラプロジェクトは、必ずしも最も強力なプライバシー保証を備えたものではありません。信頼性対コストの比率が最も優れているものが成功するでしょう。この違いが重要なのは、開発者が最終的に導入可能性を最適化するからです。もし機密実行がレイテンシや運用コストを大幅に引き上げるなら、リアルタイム推論を必要とするアプリケーションは、信頼の前提が弱いものの性能特性に優れたアーキテクチャへ移行する可能性があります。
本当の課題は、成功がそれ自体でボトルネックを生み出し得ることだと思います。もし機密AIがWeb3全体に広く採用されるなら、保護された計算への需要は、それを支えるよう設計されたインフラよりも速く増えるかもしれません。その場合、今後のネットワークは最大の信頼を最適化すべきでしょうか、それとも最大のスケーラビリティを最適化すべきでしょうか?🤔
#OPG @OpenGradient $OPG