あるトレーダーが2つのAIプロジェクトを比較する。
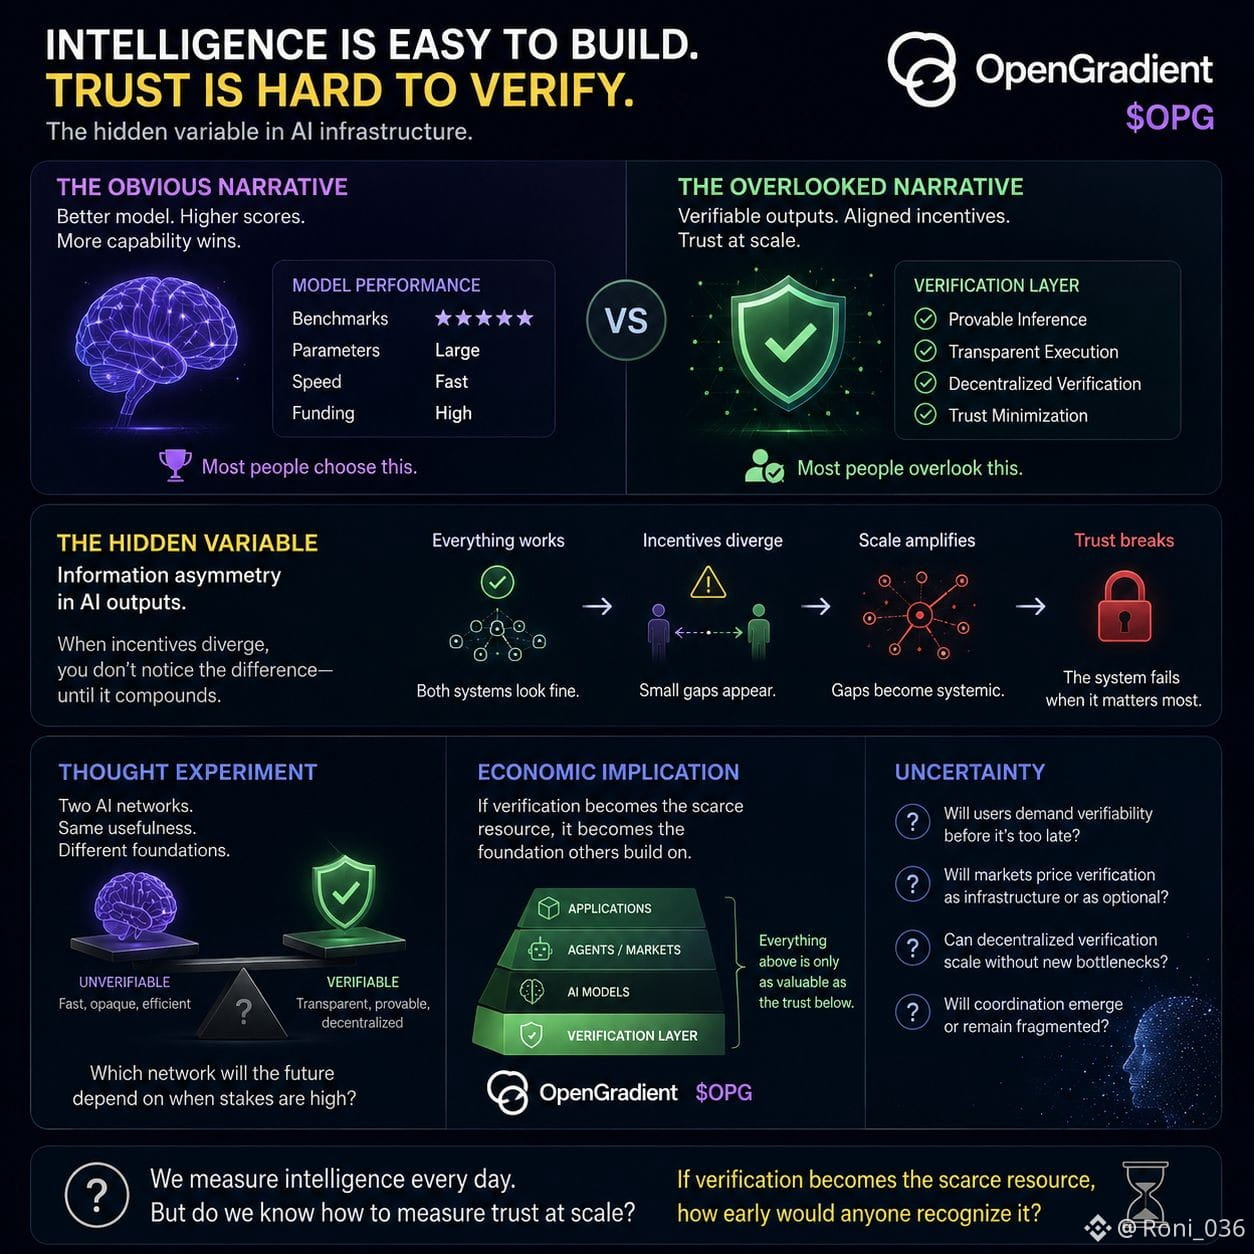
一方はより大きなモデル、より多くの資金、そしてより高いベンチマークスコアを持っている。
もう一方は、その努力の大半を、モデル出力を検証可能にすることに費やしている。
多くの人はおそらく前者を選ぶだろう。
それは、AIインフラをめぐる「当然の物語」にも見える。より良いモデルが勝つ。より多くの知能が勝つ。より高い能力がより多くのユーザーを呼び込む。
最初は私も同じだと思った。
しかし考えが長くなるほど、知能が測られている一方で、検証は単に当然の前提として置かれているのではないかと疑問が湧いてくる。
同じくらい有用な出力を生み出す2つのAIネットワークを想像してみよう。
あるネットワークでは、ユーザーがそれぞれ独立に、結果がどのように生成されたかを検証できる。もう一方では、検証は主に評判や信頼を通じて存在する。
どちらも、すべてがうまくいっている限りは正常に機能する。
違いが表れるのは、インセンティブが食い違い始めたときだけだ。
検証できない単発の出力は問題にならないかもしれない。数千件もおそらく問題にならないだろう。だが、市場全体、エージェント、アプリケーション、自動化された意思決定が、簡単には検証できない情報に依存し始めたらどうなる?
その観点から見ると、@OpenGradient $OPG はAIの性能に関する問いというより、情報の非対称性に関する問いのように思えてくる。
知能を作れるかどうかではない。
だが、知能を大規模に信頼できるかどうかだ。
市場が、どちらの問題のほうが実際に難しいのか、まだ決め切れていないのかもしれない。
そして、検証が最終的に希少な資源になるとしたら、人はそれを誰がどれくらい早く気づくだろう?
#opg $OPG @OpenGradient
一方はより大きなモデル、より多くの資金、そしてより高いベンチマークスコアを持っている。
もう一方は、その努力の大半を、モデル出力を検証可能にすることに費やしている。
多くの人はおそらく前者を選ぶだろう。
それは、AIインフラをめぐる「当然の物語」にも見える。より良いモデルが勝つ。より多くの知能が勝つ。より高い能力がより多くのユーザーを呼び込む。
最初は私も同じだと思った。
しかし考えが長くなるほど、知能が測られている一方で、検証は単に当然の前提として置かれているのではないかと疑問が湧いてくる。
同じくらい有用な出力を生み出す2つのAIネットワークを想像してみよう。
あるネットワークでは、ユーザーがそれぞれ独立に、結果がどのように生成されたかを検証できる。もう一方では、検証は主に評判や信頼を通じて存在する。
どちらも、すべてがうまくいっている限りは正常に機能する。
違いが表れるのは、インセンティブが食い違い始めたときだけだ。
検証できない単発の出力は問題にならないかもしれない。数千件もおそらく問題にならないだろう。だが、市場全体、エージェント、アプリケーション、自動化された意思決定が、簡単には検証できない情報に依存し始めたらどうなる?
その観点から見ると、@OpenGradient $OPG はAIの性能に関する問いというより、情報の非対称性に関する問いのように思えてくる。
知能を作れるかどうかではない。
だが、知能を大規模に信頼できるかどうかだ。
市場が、どちらの問題のほうが実際に難しいのか、まだ決め切れていないのかもしれない。
そして、検証が最終的に希少な資源になるとしたら、人はそれを誰がどれくらい早く気づくだろう?
#opg $OPG @OpenGradient