過去数日間、@OpenGradient を調べてきたのですが、私の目を本当に引いたのはAIのナラティブではありませんでした。
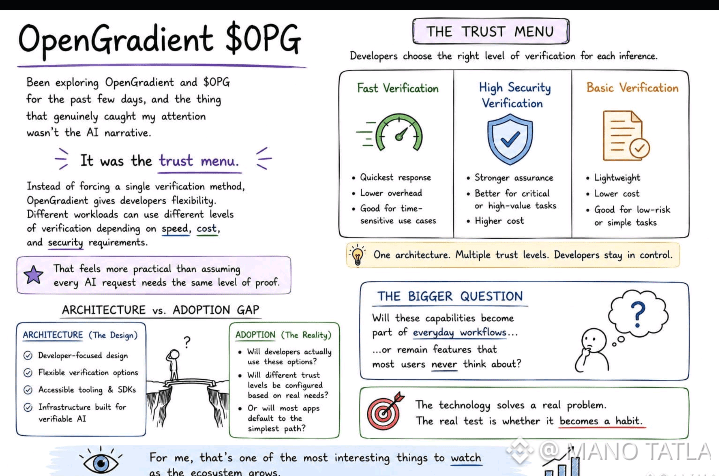
それは「信頼メニュー」です。
単一の検証方法を押し付けるのではなく、OpenGradientは開発者に柔軟性を与えます。さまざまなワークロードが、速度・コスト・セキュリティ要件に応じて、異なるレベルの検証を使い分けられるのです。
「すべてのAIリクエストが同じレベルの証明を必要とする」と決めつけるより、ずっと現実的だと感じます。
私が考え続けているのは、アーキテクチャと導入(アダプション)の間にあるギャップです。
設計は明らかに開発者を意識しています。柔軟な検証、利用しやすいツール、検証可能なAIを前提に作られたインフラは、紙の上ではすべて理にかなっています。
しかし、優れたインフラは、人々が実際に使ってこそ意味があります。
私が最も注目しているのは、その部分です。
開発者は自分のニーズに応じて、異なる検証オプションを積極的に設定し、使っていくのでしょうか?
それとも、多くのアプリケーションは利用可能な最も簡単な手順にデフォルトで落ち着くのでしょうか?
このテクノロジーは、実際の課題を解決しています。
より大きな問いは、こうした能力が日常のワークフローに組み込まれるのか、それとも大半のユーザーがそもそも意識しないままの機能として残るのか、ということです。
エコシステムが成長していく中で、私にとってそれが最も興味深い観察ポイントの一つです。
#OPG $OPG @OpenGradient