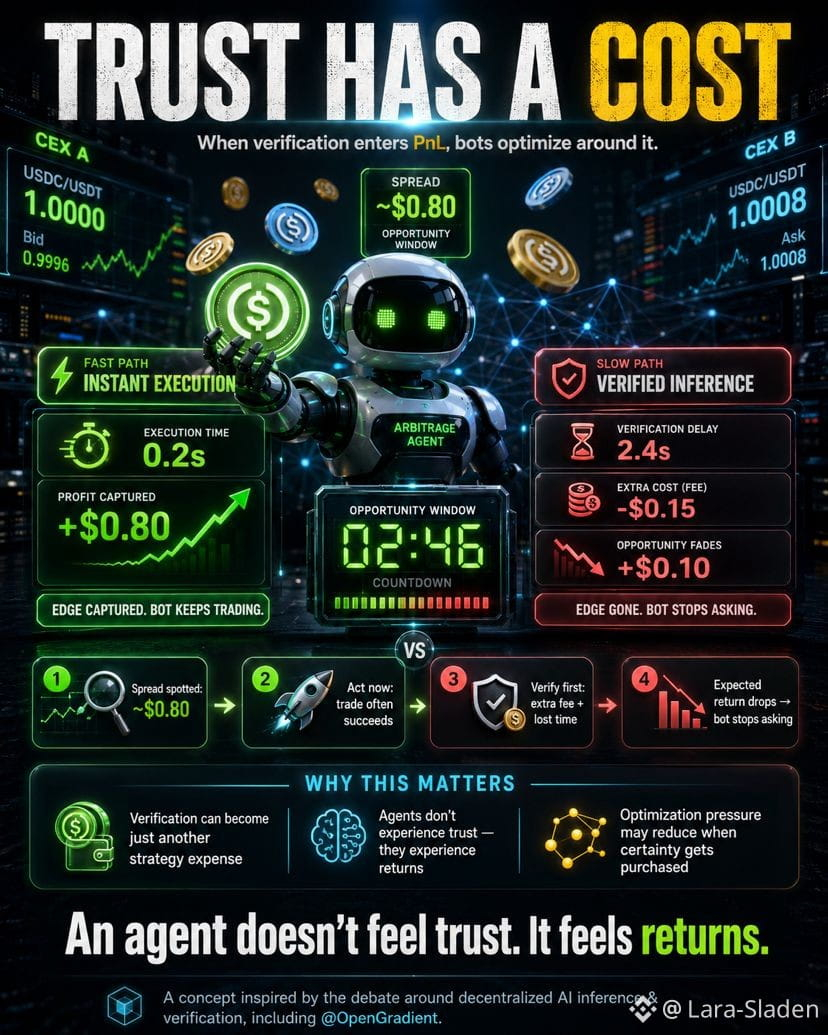

ボットがステーブルコインの裁定取引で$0.80を見ている。
このウィンドウは数秒しか続かない。
即座に動けば、十分な頻度で勝てる。
検証済み推論を待つなら、追加で支払う。
それだけ時間を失う。
期待収益が下がる。
だから最終的に、問い合わせをやめる。
そして正直に言うと?
それは驚くことじゃない。
それこそが、取引戦略がやるべきことだ。
信頼のことは気にしない。
重要なのは優位性だ。
@OpenGradientについて読んでいる間ずっと、そんな考えが頭から離れなかった。
OpenGradientは通常、分散型AIインフラとして語られる:
モデルを保管し、推論を実行し、実行を検証する。
最初は、主なポイントは単純だと思った。
APIキーを、粒度の細かい推論支払いに置き換える。
サブスクなし。
未使用の容量に対して払わない。
使っていない計算にお金を払わない。
その部分は今も筋が通っている。
実際、私はそれが好きだ。
でも、ステーブルコインの例が繰り返し戻ってくる。
$0.80が重要だからではない。
数字は変えられる。
$8にしてもいい。
$800にしてもいい。
論理は同じままだ。
ある時点で、検証はもはやセキュリティ機能ではなくなる。
コストになる。
そして、何かがコストになると、戦略はそれを中心に最適化を始める。
そこが不快な部分だ。
たぶん、ほとんどの判断はまだ検証される。
たぶん、大きな取引だけが追加の確実性を正当化する。
たぶん、そのコストが十分小さくて誰も気にしない。
たぶん、これは些細な問題だ。
でも、私はもう完全には確信できない。
以前はこう思っていた:
より良い信頼インフラ=より信頼できるエージェント。
でも、今はそれが単純すぎるかもしれないと思っている。
なぜなら、エージェントは信頼を体験しないからだ。
体験するのはリターンだ。
遅延を見る。
手数料を見る。
失われる機会を見る。
PnLを見る。
そして、検証がPnL欄の中に現れてしまうなら、なぜ最適化の圧力がそこから止まるのか?
それが、私が振り払えない問いだ。
未来はこうならないかもしれない:
AIを検証できるか?
そうではなく、こうかもしれない:
検証には、いつお金を払う価値があるのか?
そして市場において、その答えはめったに感情的ではない。
それは数学的なものだ。
#opg $OPG @OpenGradient
このウィンドウは数秒しか続かない。
即座に動けば、十分な頻度で勝てる。
検証済み推論を待つなら、追加で支払う。
それだけ時間を失う。
期待収益が下がる。
だから最終的に、問い合わせをやめる。
そして正直に言うと?
それは驚くことじゃない。
それこそが、取引戦略がやるべきことだ。
信頼のことは気にしない。
重要なのは優位性だ。
@OpenGradientについて読んでいる間ずっと、そんな考えが頭から離れなかった。
OpenGradientは通常、分散型AIインフラとして語られる:
モデルを保管し、推論を実行し、実行を検証する。
最初は、主なポイントは単純だと思った。
APIキーを、粒度の細かい推論支払いに置き換える。
サブスクなし。
未使用の容量に対して払わない。
使っていない計算にお金を払わない。
その部分は今も筋が通っている。
実際、私はそれが好きだ。
でも、ステーブルコインの例が繰り返し戻ってくる。
$0.80が重要だからではない。
数字は変えられる。
$8にしてもいい。
$800にしてもいい。
論理は同じままだ。
ある時点で、検証はもはやセキュリティ機能ではなくなる。
コストになる。
そして、何かがコストになると、戦略はそれを中心に最適化を始める。
そこが不快な部分だ。
たぶん、ほとんどの判断はまだ検証される。
たぶん、大きな取引だけが追加の確実性を正当化する。
たぶん、そのコストが十分小さくて誰も気にしない。
たぶん、これは些細な問題だ。
でも、私はもう完全には確信できない。
以前はこう思っていた:
より良い信頼インフラ=より信頼できるエージェント。
でも、今はそれが単純すぎるかもしれないと思っている。
なぜなら、エージェントは信頼を体験しないからだ。
体験するのはリターンだ。
遅延を見る。
手数料を見る。
失われる機会を見る。
PnLを見る。
そして、検証がPnL欄の中に現れてしまうなら、なぜ最適化の圧力がそこから止まるのか?
それが、私が振り払えない問いだ。
未来はこうならないかもしれない:
AIを検証できるか?
そうではなく、こうかもしれない:
検証には、いつお金を払う価値があるのか?
そして市場において、その答えはめったに感情的ではない。
それは数学的なものだ。
#opg $OPG @OpenGradient