

ストレージはコストセンターではなく、Bitroot AI Stack の価値配分システムです。多くのチームは、ローンチから半年以上経って初めて、ストレージのレイヤーをもっと慎重に選ぶべきだったと気づきます。データは失われず、サービスも停止していませんが、問題は別の形で浮上しています。アーカイブされたトレーニングデータの取得がどんどん遅くなり、ホットベクトルクエリのレイテンシーがミリ秒から秒単位まで揺れ動いています。オンライン事故を振り返る必要がある時には、誰もそのモデルがどのトレーニングデータのバージョンを使用していたのかを説明できません。この段階では、解決すべきは拡張ではなく、3つのより難しい問題です:誰がデータが常に使用可能であることを証明できるのか、誰がバージョンの責任を持つのか、誰が長期コストを負担するのか。
ストレージは中央集権のクラウドからチェーン下のネットワークに移すことを理解し、NFTメタデータ時代にも持ちこたえることができます。一度ビジネスがAIトレーニングコーパス、モデルの重み、ベクトルインデックスに拡大すると、この考え方は急速に無効化されます。
ほとんどのチームは今でもストレージをコスト削減が進む後方支援と見なしており、これは最も過小評価され、最も間違えやすい部分です:AIパブリックチェーンでは、実際には誰がデータを掌握し、誰が報酬を得るかを決定する価値分配層なのです。この文書はただ一つの質問に答えます:AIとパブリックチェーンの統合シーンで、いかにして検証可能、ガバナンス可能、持続可能な分散ストレージソリューションを構築するか。以下では、主流の3つのパラダイムの能力の境界を分解し、AIデータの特別な難しさを説明し、最後に5層の実行可能なアーキテクチャと段階的な立ち上げのしきい値を説明します。判断基準は公式のプロトコル文書を基にし、できるだけ検証可能な資料に基づきます。
Bitrootの例を挙げると、ストレージ層のより正確な位置付けはAIスタックの価値分配の基盤です。Bitrootは、一方で並列化されたEVMとPipeline BFTによって高性能なオンチェーン実行環境を提供し、他方で分散トレーニング、推論ネットワーク、信頼できる実行、AI資産管理によってデータ、モデル、計算力、エージェントアプリケーションを結びつけて決済可能なネットワークを形成します。このネットワークでは、ストレージは孤立したモジュールではなく、データが権利確定できるか、モデルが再現可能か、計算力が決済できるか、貢献者が持続的に収益を得られるかを決定するインフラストラクチャです。
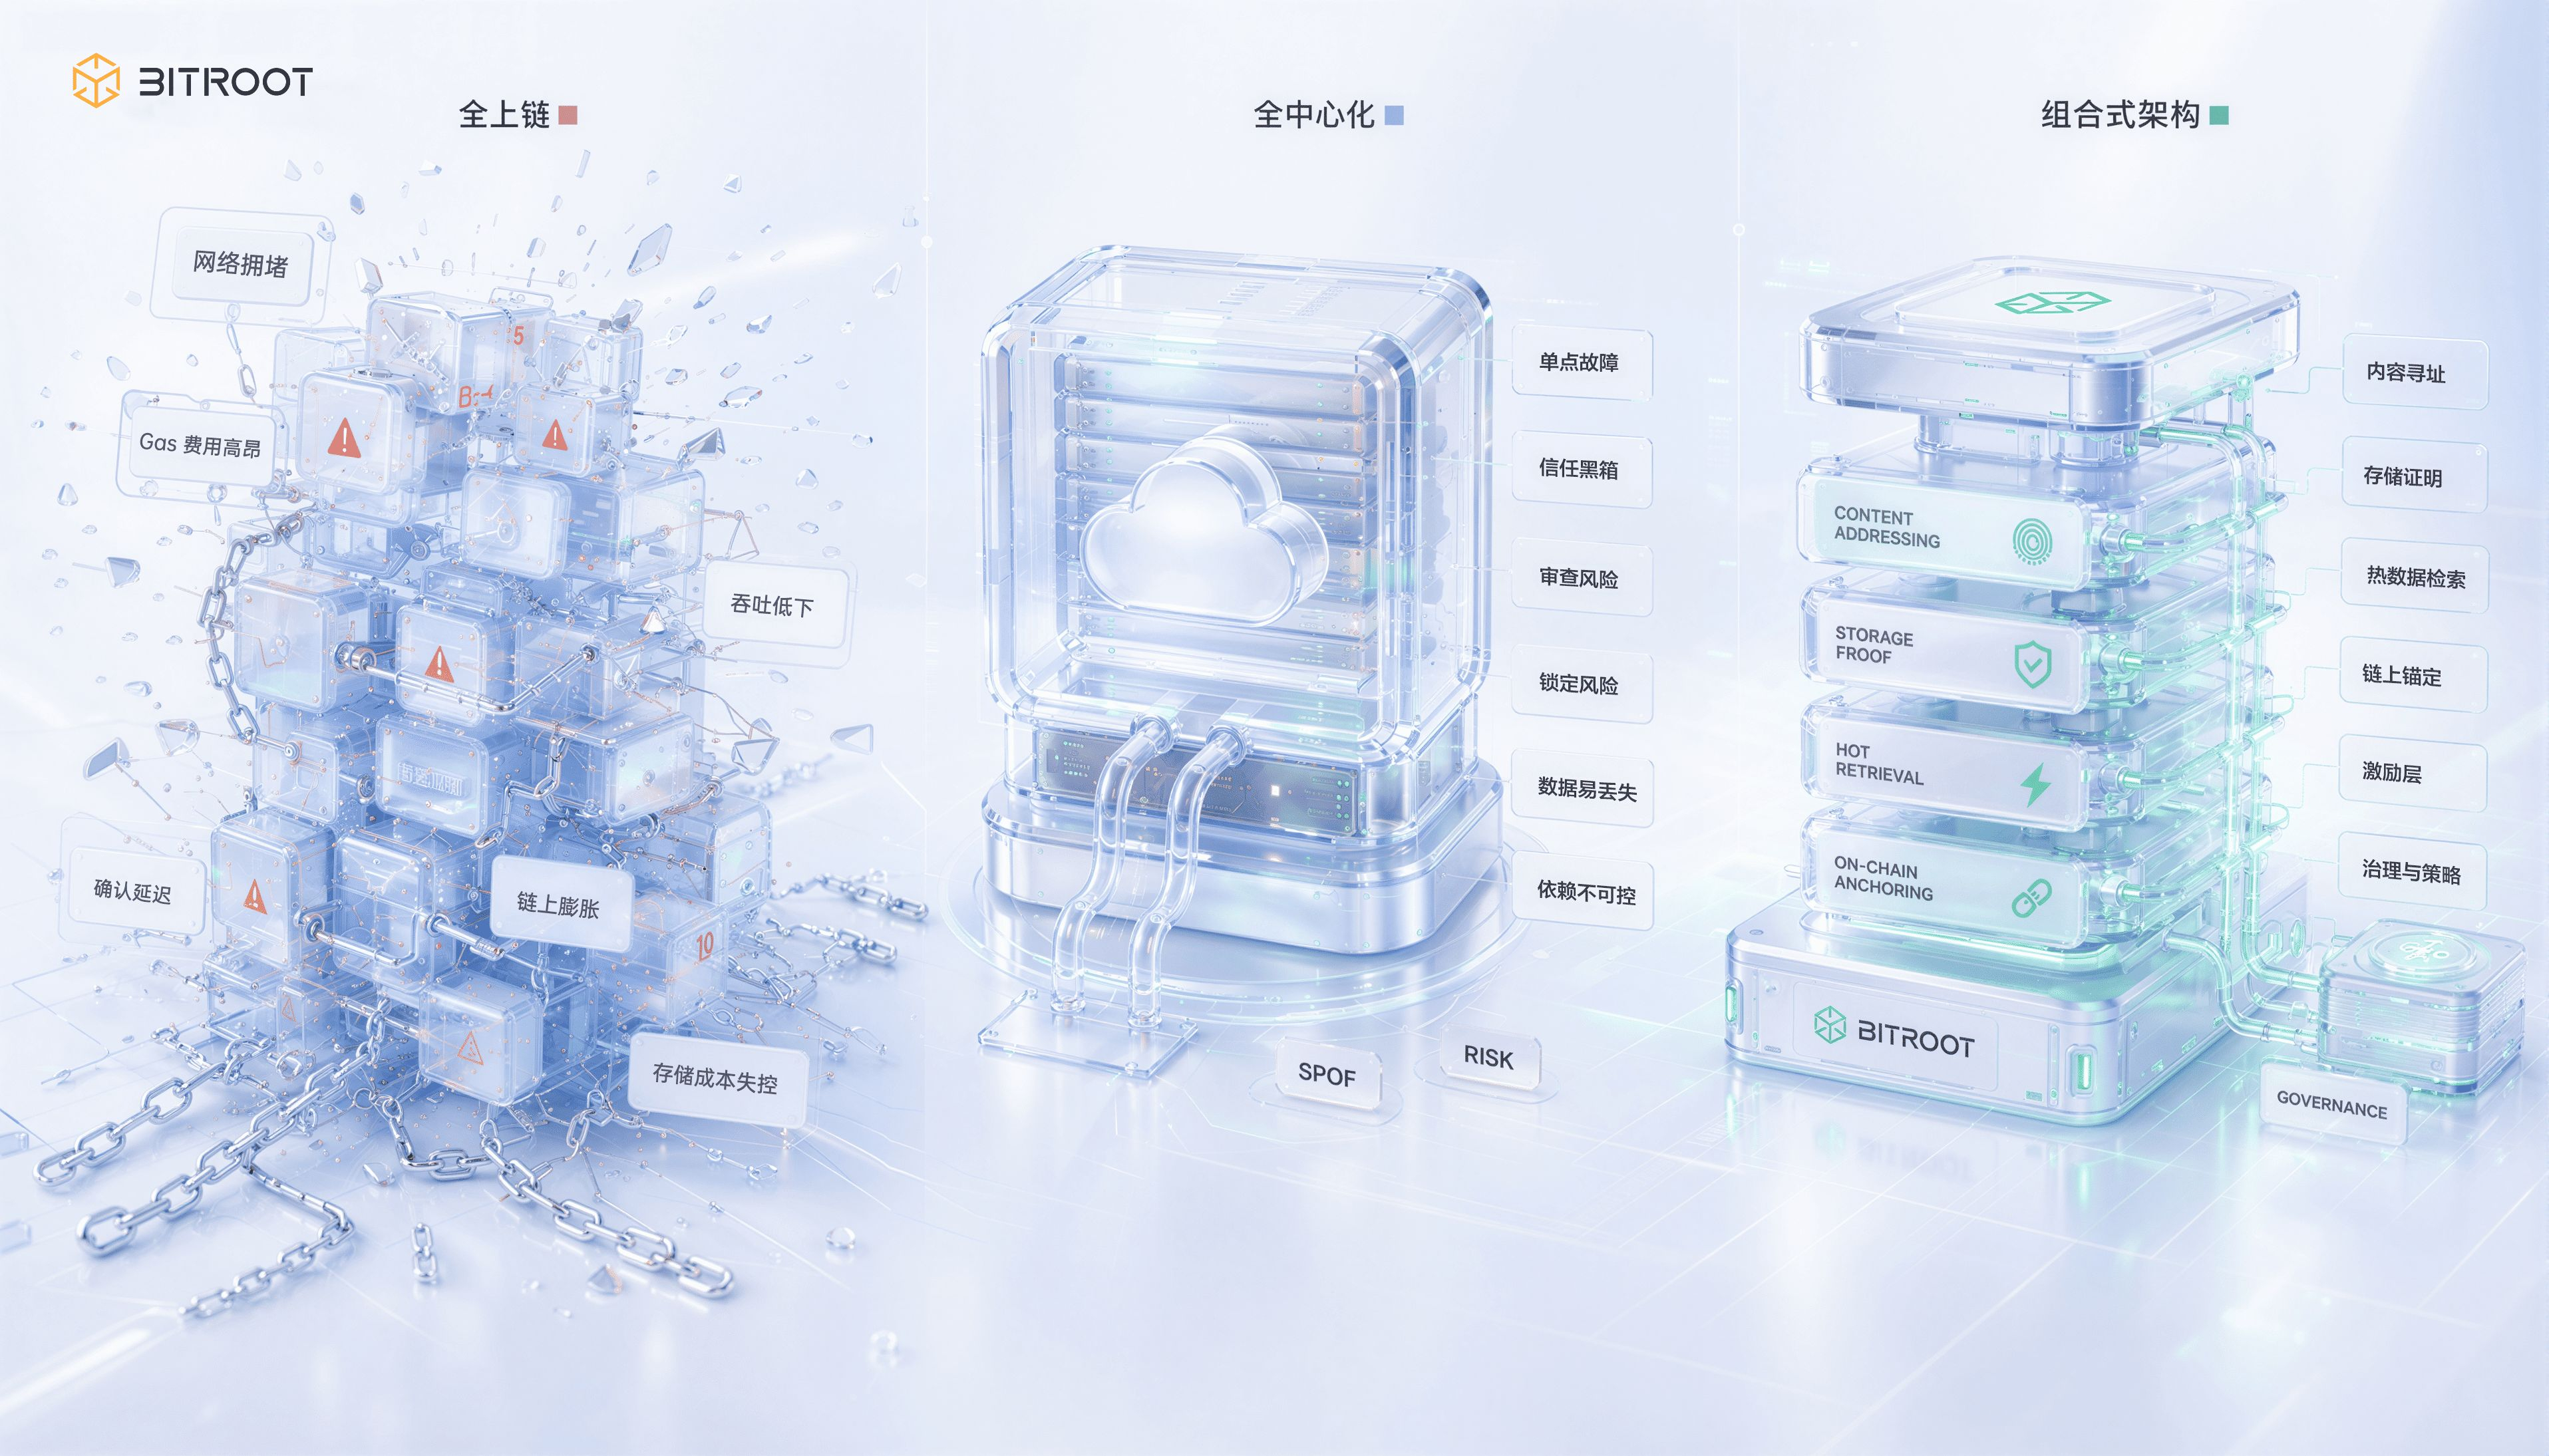
全てがオンチェーンで全てが中央集権的な方法は、AIシーンではもはや通用しません。過去数年、ストレージ問題はしばしば二者択一に簡略化されました:全てをオンチェーンにするか、全てを中央集権的にするか。この2つの道は、AIシーンでは持続可能ではありません。
全てをオンチェーンにするプレッシャーは具体的です。トレーニングデータ、モデルの重み、推論ログ、ベクトルインデックスは一般的に高いボリュームに加え高頻度の更新を伴います。たとえスライスしてからオンチェーンにしても、スループットの天井とコスト曲線に同時にぶつかります。全てが中央集権的に運営されると速いですが、検証可能性、追跡可能性、データの主権、複数主体間の協力で依存する信頼の基盤は非常に脆弱であり、一度複数の分配と権利確定が関わると立ち行かなくなります。
さらに重要な変化は、AIがストレージをコスト項目から生産要素に変えたことです。データバージョンを誰が管理するかが、モデルの反復の主導権を誰が持つかを決定します;データが可用であることを証明できるかが、計算力のスケジューリングと決済の優先順位に直接影響します;データ資産化の能力は、チームがエコシステム内で長期的なインセンティブを確立できるかどうかに関係します。ストレージ層はこの段階で、もはや後方支援システムではなく、価値分配システムとなっています。
したがって、適切なストレージアーキテクチャは同時に4つの質問に答える必要があります:データが本当に存在していて持続可能であるか、データとモデルのバージョン関係が追跡可能であるか、権限と収益がガバナンス可能であるか、システムがコストと性能の間で長期的にバランスを保つことができるか。
Bitrootの切り口:AIデータを「保存可能」から「決済可能」へ
これこそがBitrootが補完する必要がある位置です。AIシーンに向けた高性能Parallel EVMパブリックチェーンとして、Bitrootのストレージの物語は「データをどこに置くか」にとどまるべきではなく、「データがどのように証明され、どのように呼び出され、どのように分配に参加するか」を答えるべきです。トレーニングコーパス、モデルの重み、ベクトルインデックス、推論ログは、より大きなオブジェクトに適した分散ストレージ層に留められることができますが、それらのハッシュの約束、バージョン関係、権限ポリシー、呼び出しの記録、収益のイベントは、Bitroot上で統一されたチェーン上の証拠を形成する必要があります。
この観点から見ると、Bitrootの高スループットと低遅延はDeFi取引を単にサービスするためのものではなく、AIスタック内のより細かい粒度でより高頻度のガバナンスイベントをサービスするためのものです:データセットの更新をアンカーし、モデルバージョンを登録し、AIエージェントの呼び出しを決済し、検索結果の争議を仲裁し、ストレージノードの可用性を持続的に挑戦し、報酬を与える必要があります。基盤となるチェーンがこれらのイベントを受け入れることができなければ、AIデータ資産は中央集権化されたデータベースにロックされたままとなり、責任を持たないオフチェーンのブラックボックスに陥ります。
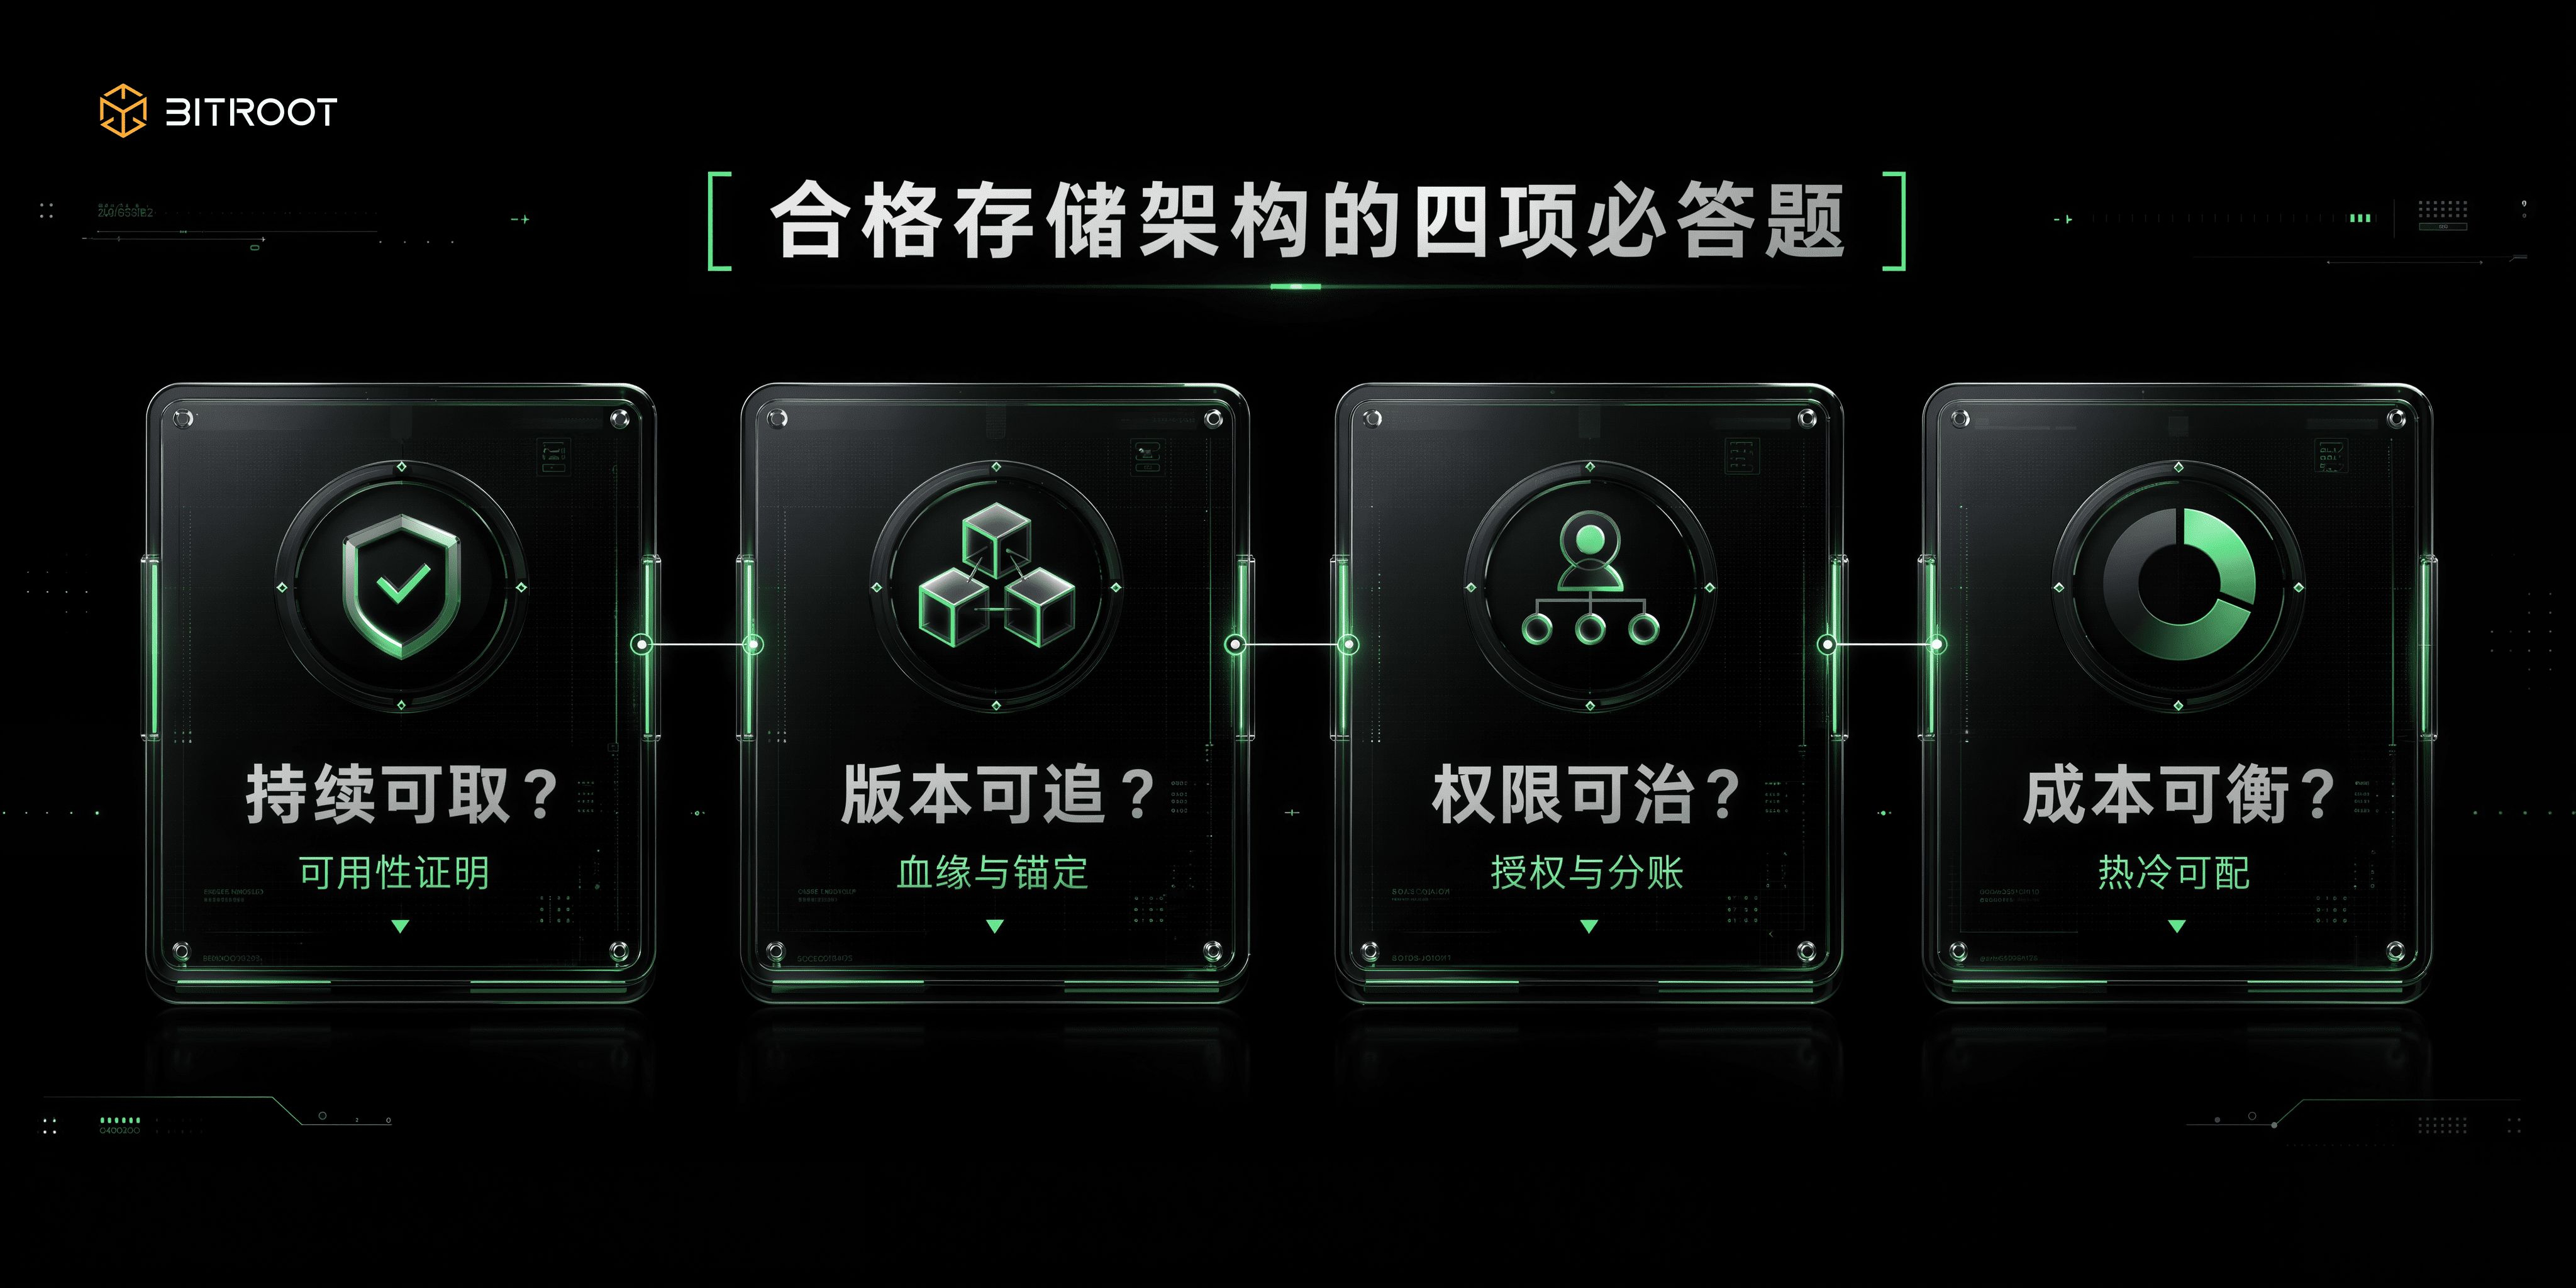
3つの主流パラダイムでは、どれも単独で全シーンを突破することはできません。分散ストレージの競争は、決して誰が最も先進的かではなく、あなたのデータ構造に最も適しているかです。
コンテンツアドレッシングネットワークは、これはそのデータであるかどうかを解決しますが、誰がそれをオンラインで保証するかは問題ではありません。IPFSの公式文書によると、CIDはコンテンツのハッシュに基づく識別子であり、位置アドレッシングには依存しません:同じコンテンツは同じエンコード/デコード設定で生成された同じCIDを持ち、コンテンツが1バイトでも変更されればCIDも変わります。この特性により、完全性の検証、重複排除、システム間の参照に自然に適しており、データ確権の基盤能力です。しかし、コンテンツアドレッシングは経済的に持続可能な可用性を意味するものではありません。CIDはアイデンティティの問題に答えますが、誰がそれを常にオンラインで保証するかには答えません。多くのチームが導入後に最初の落とし穴に陥るのはここです:技術的にはCIDを取得しましたが、ビジネス面では可用性の約束を取得していません。
ストレージ市場ネットワークは、経済的メカニズムを用いて時間次元の可用性を獲得します。Filecoinの文書によると、ネットワークはProof-of-ReplicationおよびProof-of-Spacetimeを通じてストレージの約束と持続的な証明のメカニズムを確立します。PoRepは初期のパッケージ時にこの独特なコピーが実際に保存されていることを証明し、PoStは後続のサイクルでそれがまだ存在することを繰り返し証明します。WindowPoStの証明サイクルは通常24時間ごとに組織され、30分ごとの証明ウィンドウに分割されます。ストレージ側はウィンドウ内に有効な証明を提出しないと、担保の罰金やストレージ能力の低下を引き起こします。このシステムでは、可用性は持続的な評価項目であり、契約後の一度きりの約束ではありません。この契約化された、監査可能なモデルは中長期的なアーカイブ、バックアップ、データ市場に適していますが、これは証明された長期的な倉庫のようなものであり、自然に低遅延のオンラインサービスではありません。高頻度のオンラインクエリを直接押し上げると、体験は遅延によって損なわれることになります。
永続的なストレージネットワークは、単発の支払いで不変の歴史を得る別の道を進んでいます。Arweaveのプロトコルと白書の資料によると、アップロード料金の一部はストレージ寄付池に入ります。これは長期的なストレージインセンティブをカバーするために使用され、持続可能性を事前に料金モデルに組み込んでいます。これは歴史的なアーカイブ、重要な証明、著作権資料のような改ざん不可能な記録に適しています。ただし、短所も明確です:永続化が自動的に高い並行性と低遅延を意味するわけではなく、実際にはキャッシュ、ゲートウェイ、または近接インデックス層を追加する必要があります。これがユーザーサイドのリアルタイム体験を満たすためです。
この3つの基本的なパラダイムに加えて、エンジニアリング上で考慮すべき2つの一般的な組み合わせがあります。1つはデータ可用性層とオブジェクトストレージの混合で、データの発行と可用性証明がより標準化されますが、代償として層間の協調が複雑で、インターフェースガバナンスコストが高くなります。もう1つはマルチクラウドとエッジの協調で、低遅延と災害回復が優れていますが、コストガバナンスと一貫性管理が難しくなります。
どのように選んでも、1つのプロトコルがすべてのシーンを飲み込むことはエンジニアリング上不可能です。効果的な方法はデータタイプに基づいて組み合わせることです:永続性、検索遅延、コンプライアンスを分け、能力層にそれぞれマッチさせ、オンチェーンのアンカーとガバナンス層で統一的に編成します。
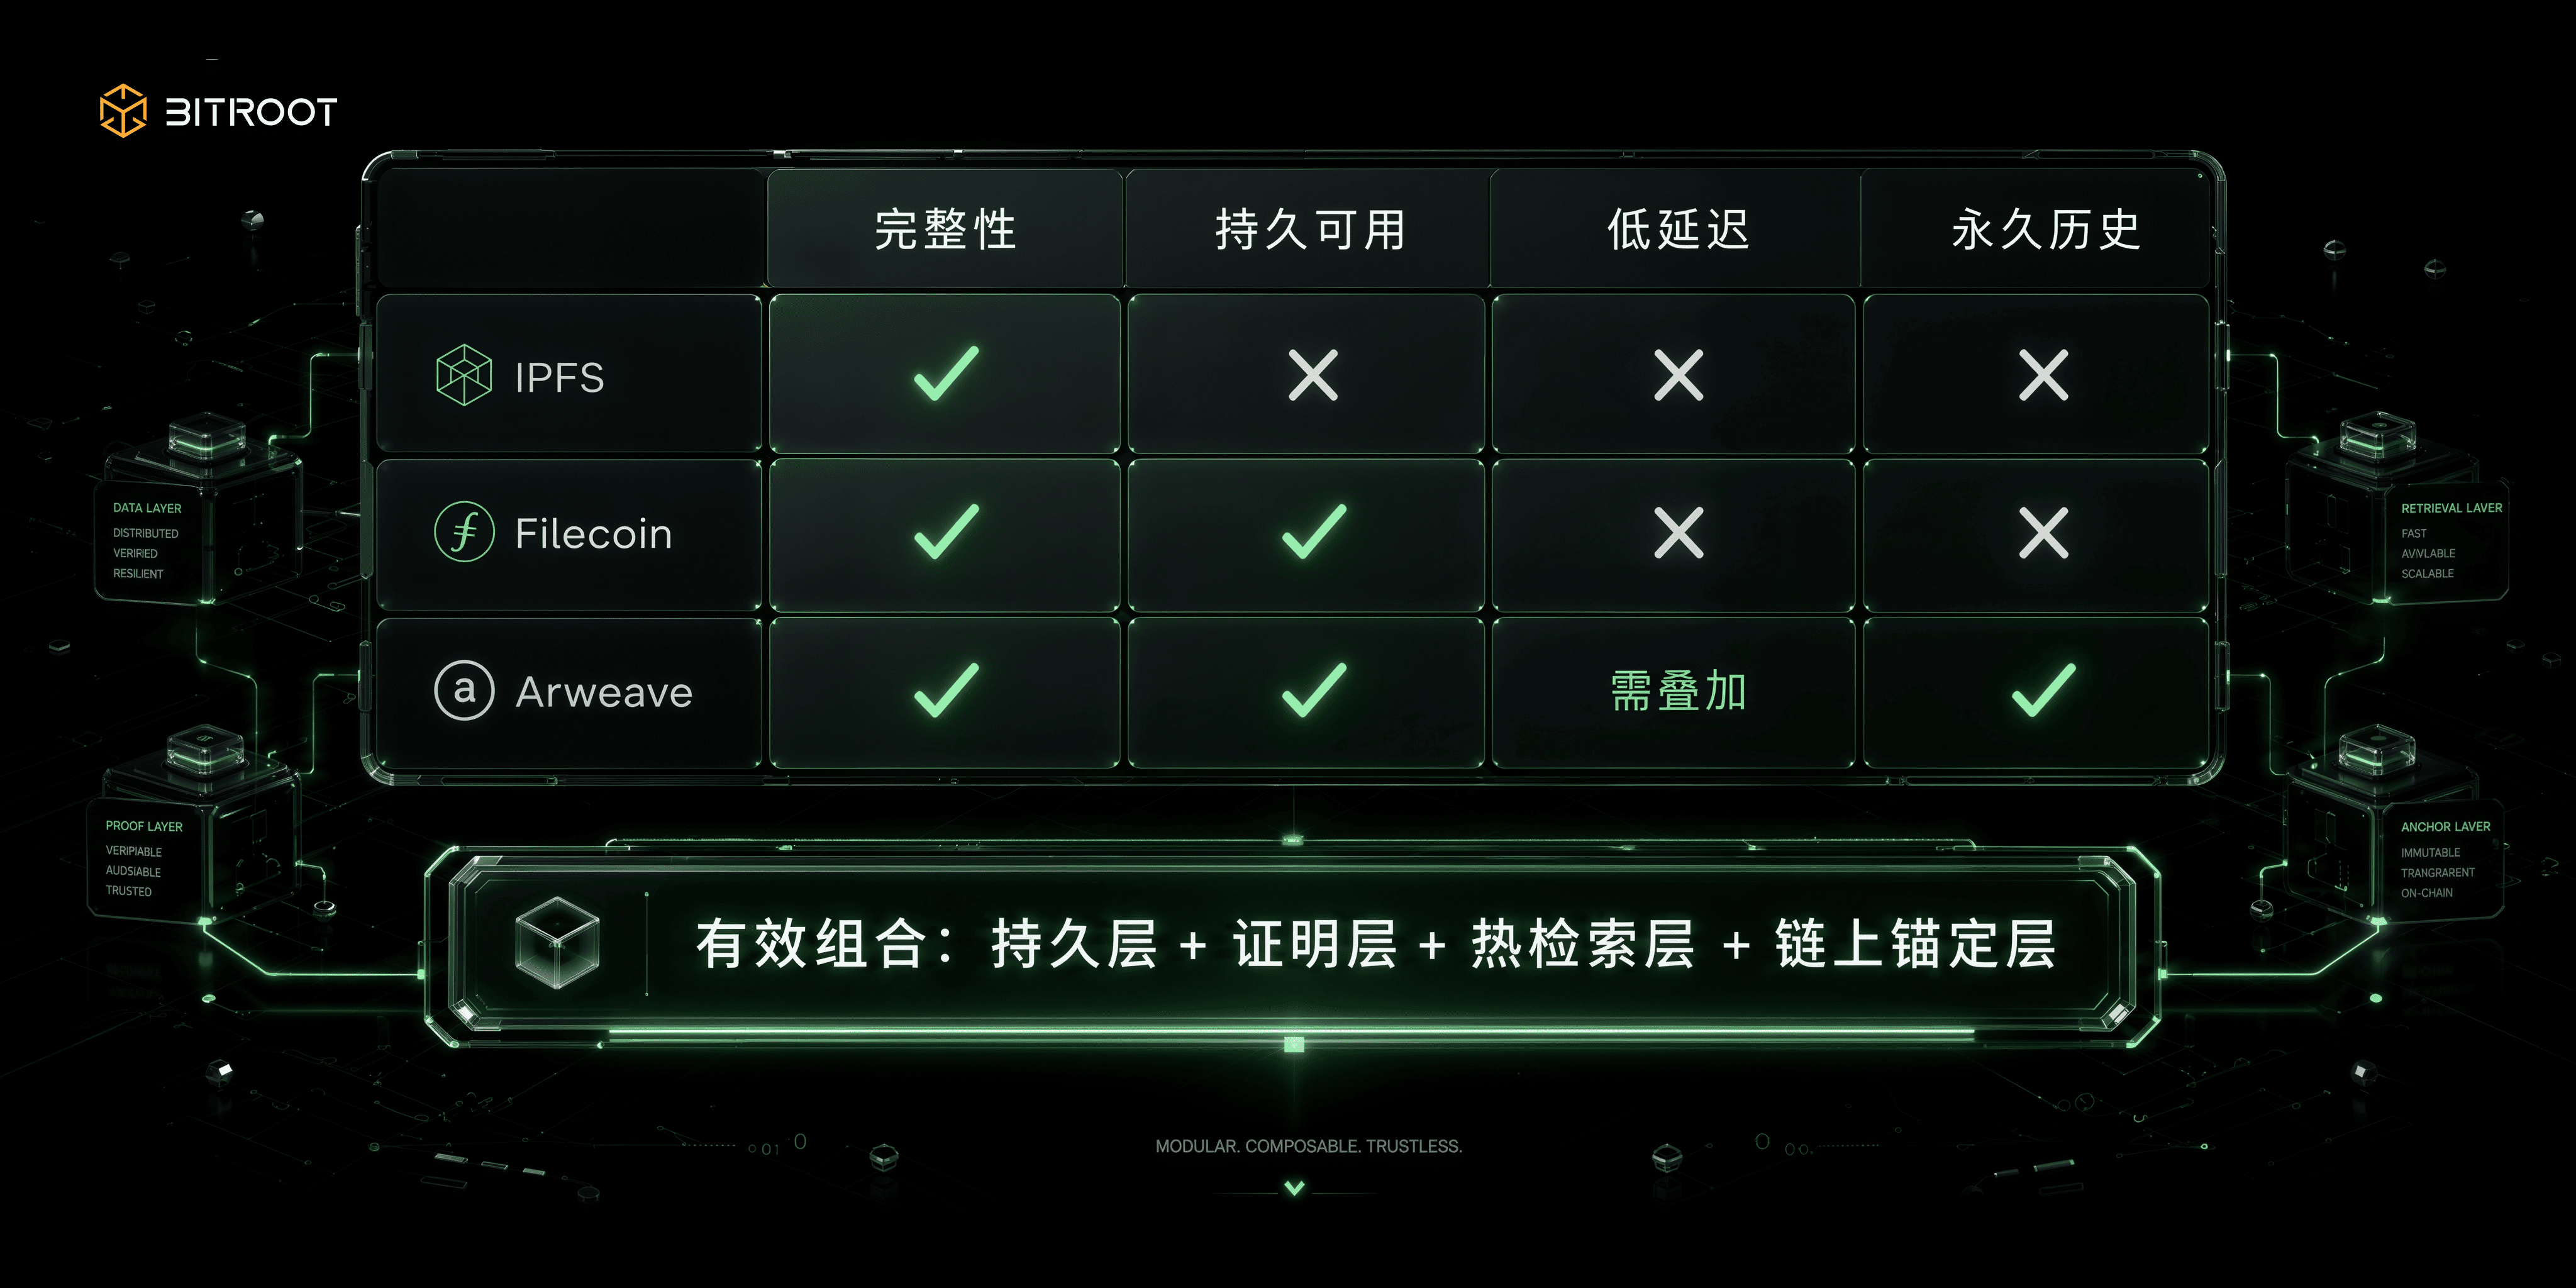
Bitrootの選択肢もこの組み合わせロジックに基づいて構築されるべきです:IPFS、Filecoin、Arweave、またはオブジェクトストレージを相互に置き換えるのではなく、それらを異なる責任層に配置します。コンテンツアドレッシングはデータのアイデンティティと完全性に使用され、ストレージ証明は長期的な可用性に使用され、永久層は重要な歴史と証明に使用され、ホット検索層はAIアプリケーション体験に使用され、Bitrootのチェーン上層はバージョンのアンカー、権限ポリシー、呼び出しの決済、争議処理を統一的に担います。言い換えれば、Bitrootはすべてのデータの物理的な倉庫になる必要はなく、AIデータの価値流の信頼できる元帳になる必要があります。
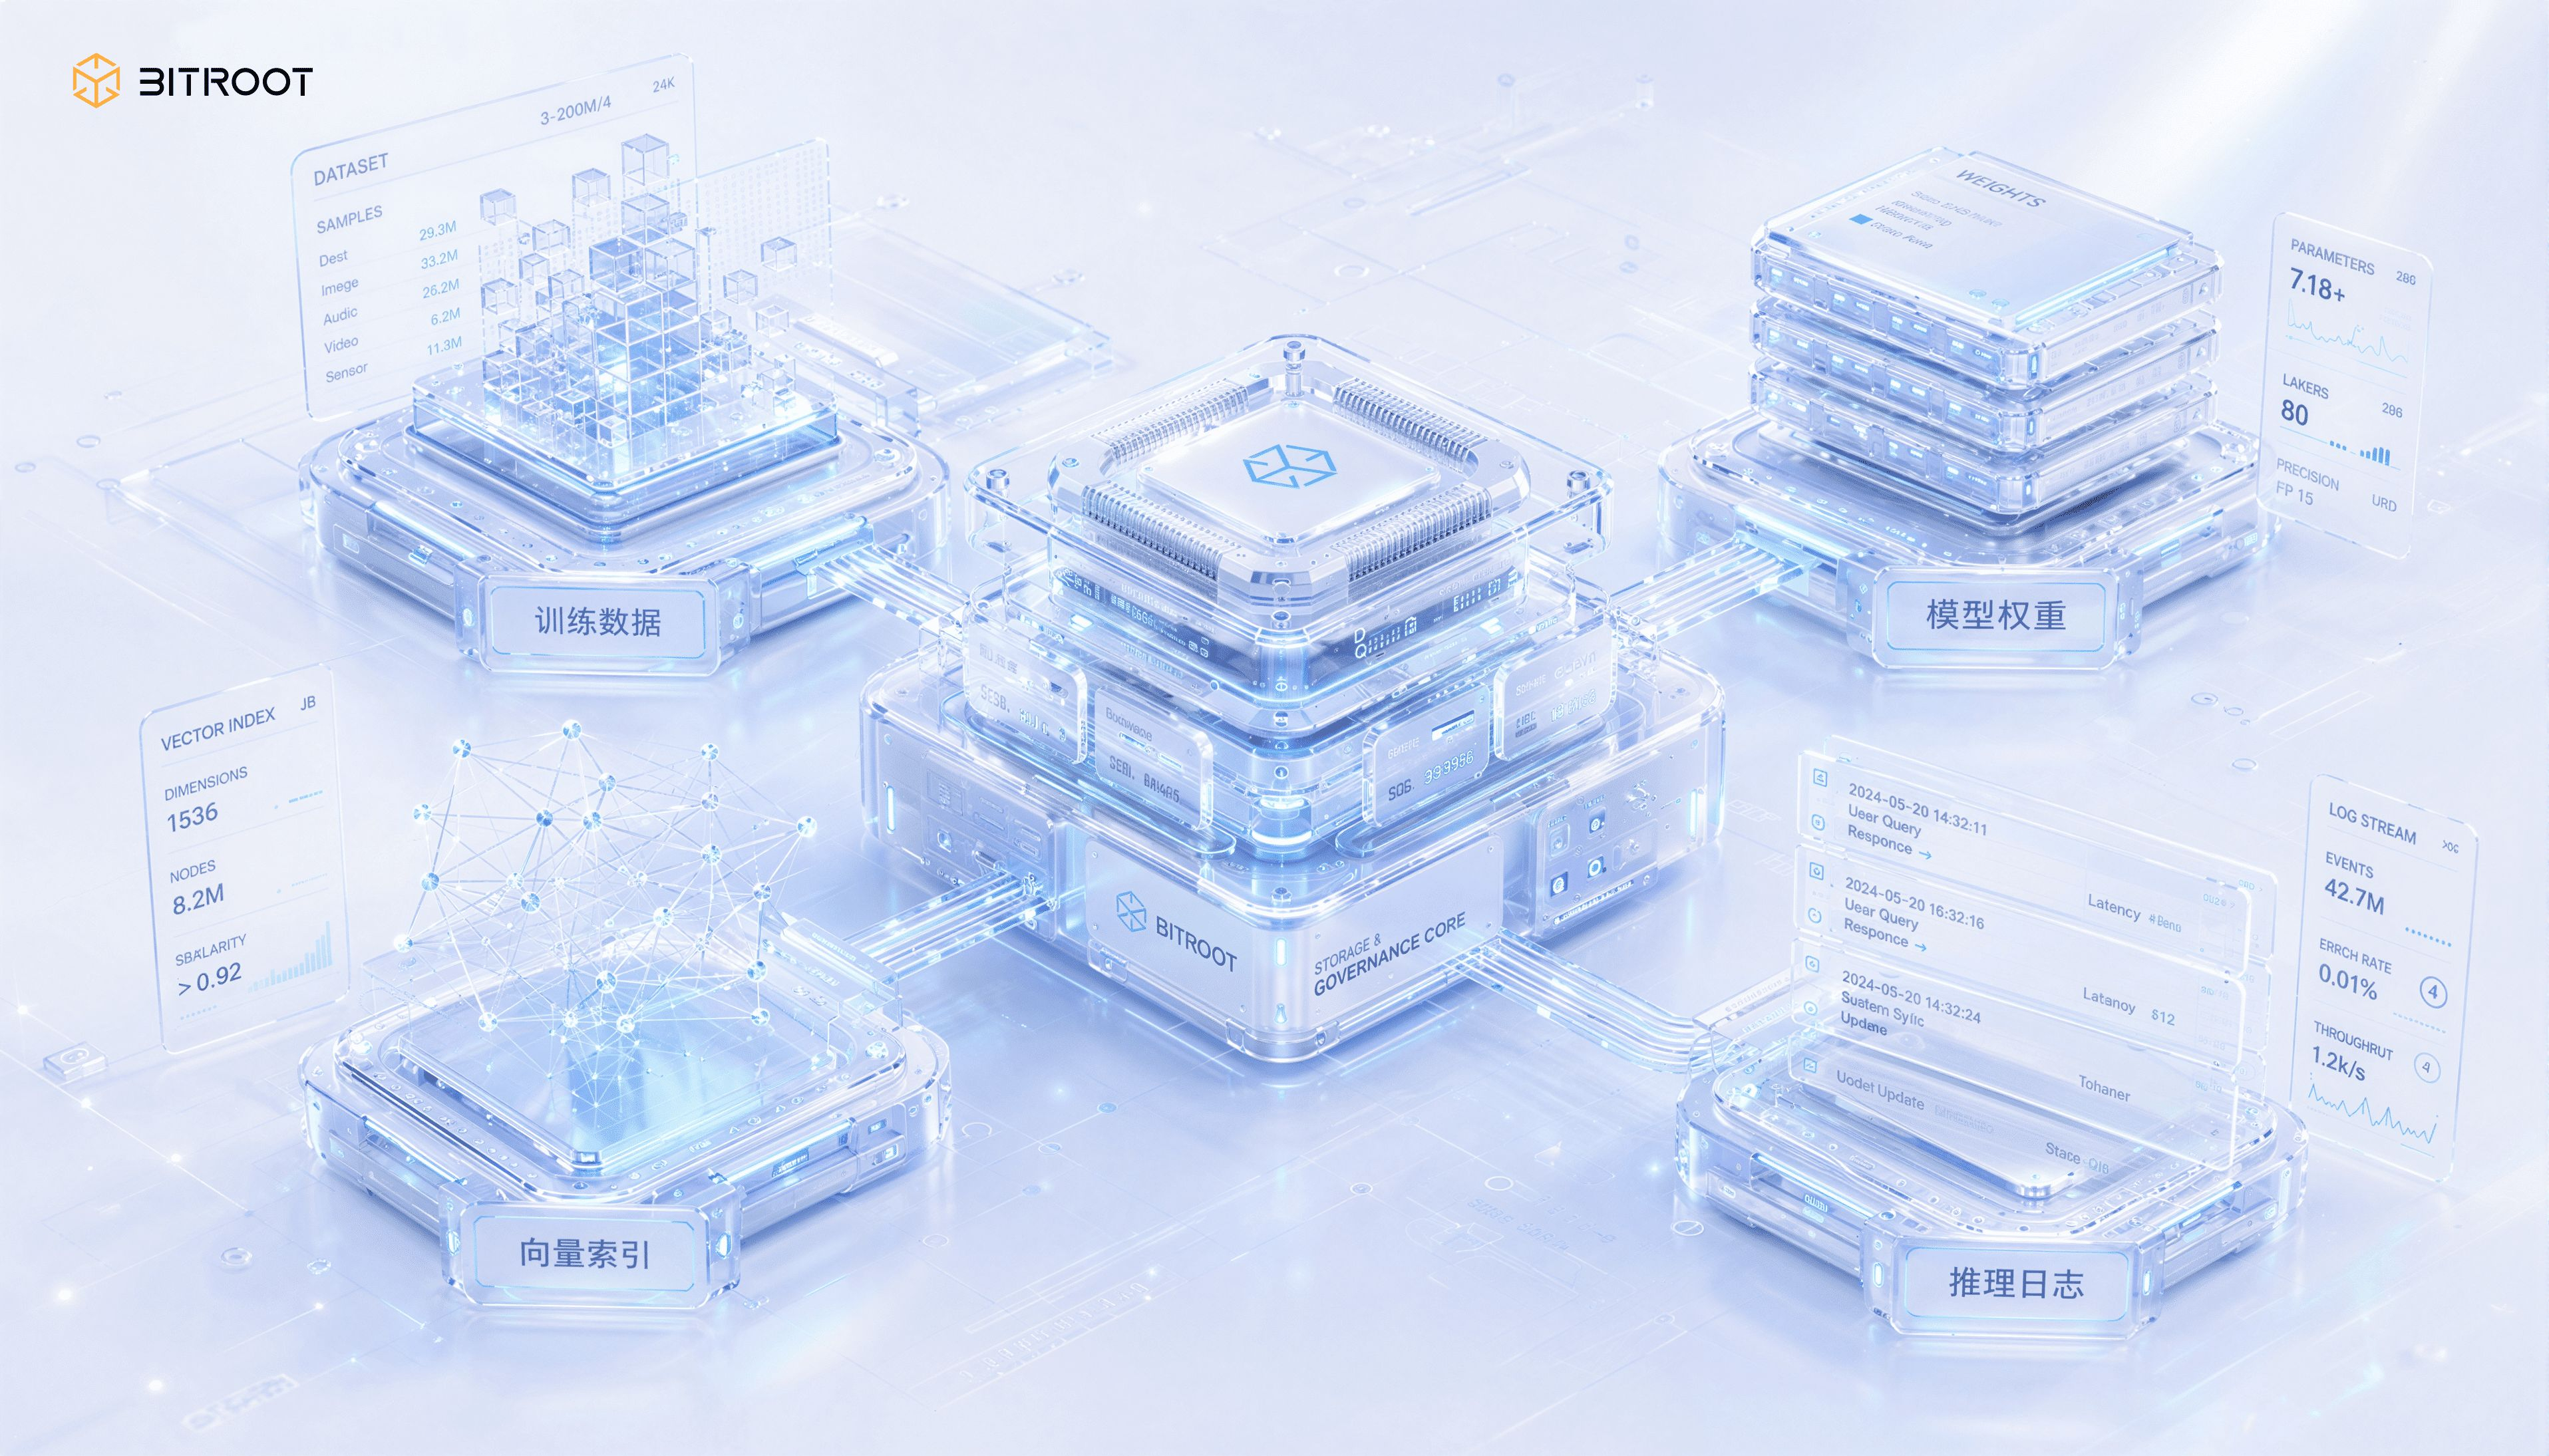
AIストレージの難しさは、ファイルを保存することではなく、生産チェーンを管理することです。AIシーンでは、ストレージオブジェクトは少なくとも4つのカテゴリに分かれます:トレーニングデータ、モデルの重み、ベクトルインデックス、推論ログ。これら4つのオブジェクトのライフサイクル、アクセスパターン、価値密度は完全に異なり、1つの戦略で管理することは短期的には便利ですが、長期的には必ずガバナンスが制御不能になります。
トレーニングデータの問題は容量ではなく、バージョンの漂流にあります。多くのチームはトレーニングデータの問題をTBレベルのストレージコストと同じだと見なしていますが、実際には漂流がより厄介です:クリーニングルール、サンプルフィルタリングの閾値、ラベルの基準が変わると、モデルの動作が変わります。データバージョンとモデルバージョンの結びつきがなければ、オフライン評価は再現可能性が難しくなります。MLflowのモデルとデータの追跡実践に基づいて、トレーニングの実行とデータバージョンの結びつきは再現実験の前提です。この原則はチェーン上でも有効です:元のデータはすべてチェーン上にある必要はありませんが、バージョンの約束、重要な要約、出所フィンガープリンツはチェーン上のアンカーを行う必要があります。エンジニアリングの観点からは、少なくとも3つの識別子をバインドする必要があります:データバージョン、トレーニング実行、モデルバージョン。どれかが欠けると、オンラインの問題の遡及が証拠の確認から原因の推測に退化します。
モデルの重みの問題は、通常はダウンロードできるかどうかではなく、呼び出しの境界を誰が管理するかです。モデルが生産に入ると、通常はグレイディエント、メイン、ロールバック、退役のいくつかの状態を経ます。標準化された登録と権限体系がなければ、オンラインの呼び出しは監査不可能なブラックボックスです。成熟したモデル登録センターは、血縁関係、バージョンエイリアス、署名制約、監査ラベルを同時に記録します。オンチェーンシステムにとって、モデルバージョンは単なるファイルハッシュであるべきではなく、権限ポリシー、収益分配、責任境界と結びついている必要があります。
ベクトルインデックスの難しさは、一つの場所に集中しています:ホットとコールドの層分け後の一貫性です。ベクトル検索には固有の矛盾があり、低遅延と低コストが相反します:ホット層はメモリや高性能インデックスサービスを利用してオンライン応答を保証し、コールド層はオブジェクトストレージによって長期的なコストを抑えます。統一されたメタデータと同期戦略がなければ、2つの層はすぐに分岐し、最終的に同じクエリが異なるノードで異なる意味の結果を返すことになります。したがって、ベクトルシステムは2つのことをサポートする必要があります:インデックス構築プロセスが追跡可能であること、ホット層のインデックスバージョンとコールド層のメインデータが照合可能であること。これが、後の検証可能な検索が解決すべきことでもあります。
推論ログはプライバシー、監査、コンプライアンスの3つが同時に成立する必要がありますが、これは非常に難しいです。それは安全監査の材料であり、プライバシーリスクの源でもあります:全量の明文が保存されるとコンプライアンスリスクが生じ、完全に保存されないと事故の再調査能力を失います。実行可能な方法は3層の重ね合わせで、内容を脱敏して保存し、ハッシュをチェーン上にコミットし、アクセスには監査の認可を必要とします。不可篡改と取り消し可能なアクセスを階層的に実現します。
BitrootのAIスタックにおいて、これらの4種類のオブジェクトは4つのガバナンスアクションに対応します:トレーニングデータはバージョンのアンカーと出所の登録を行い、モデルの重みは資産の登録と権限呼び出しを行い、ベクトルインデックスはホットとコールドの層分けと一貫性証明を行い、推論ログは脱敏ストレージと監査の約束を行います。これらは同じ方法でオンチェーンにする必要はありませんが、Bitroot上で統一された資産ID、バージョン系譜、呼び出しイベントを形成する必要があります。こうすることで、データ資産、モデル資産、エージェントアプリケーションの間で再利用可能な商業クローズドループを形成することが可能になります。
検証可能性が最低限で、可用性証明が分水嶺です。可用性証明のないストレージの約束は、生産環境では基本的に約束がないのと同じです。分散ストレージが生産に入るためには、少なくとも3つのしきい値をクリアする必要があります:完全性の証明、可用性の証明、行動の監査;AI検索シーンに入る場合は、さらに最も難しい証明である検索可能性を追加する必要があります。
完全性の証明は、コンテンツアドレッシングとMerkleコミットによって実現されます。コンテンツアドレッシングはデータフィンガープリンツを安定させ、Merkleコミットは局所的な検証を保証します。エンジニアリングの意義は、シャーディングレベルの証明でオブジェクトのサブセットを検証できることであり、毎回全体を読み込む必要がないことです。大規模モデルの重み、大規模コーパス、メディアデータにとって、これが直接的に検証コストを決定します。
可用性を証明するには、挑戦メカニズムとサンプリング検証が必要です。Filecoinの実践はすでに示していますが、可用性は口頭のSLAではなく、定期的な挑戦とオンチェーンの証明であり、一般的なアーキテクチャに抽象化すると、受動的なランダムチェック、能動的な巡回、失敗の罰則の3点セットです:ノードは所定のウィンドウ内で挑戦に応答しなければならず、そうでなければペナルティまたは重みの低下を引き起こします。同様の考え方がデータ可用性層でさらに進んでいます。Celestiaのデータ可用性サンプリング設計に基づいて、データはk×kから2k×2kの行列に拡張され、軽ノードは複数回のランダムサンプリングと確率累積を通じて、全ブロックデータをダウンロードすることなく、高い確率で可用性の信頼を構築できます。これはAIシーンに移植可能なヒントを提供します:超大オブジェクトと高並行アクセスに直面した場合、すべての可用性を全体のダウンロードで検証する必要はなく、統計的確認が大規模システムではより現実的です。
行動の監査可能性は、オンチェーンのアンカーとイベントの痕跡によって実現されます。ストレージシステムで最も管理が難しいのは実際には行動です:誰が何をアップロードし、誰が戦略を変更し、誰が移行を引き起こし、誰がいつ敏感なモデルを呼び出したか。これらの行動が統一されたイベントストリームにまとめられないと、争議が発生した場合には口頭での証拠が必要になります。ガバナンス層が行うべきことは、すべての詳細をチェーンに移すことではなく、争議が発生したときに、最小限で確定的、検証可能な証拠セットを持っていることです。
検索可能性はAIシーンで独自であり、最も難しい問題です。問題は、見落とされがちなギャップにあります:結果が返されたからといって、正しい結果が返されたわけではありません。ベクトル検索ノードは、期限切れのインデックスを使ったり、実際の最近の近傍を飛ばしたりして、見た目が妥当なtop-kを返すことができますが、あなたは返された値だけでは見分けがつきません。意味的検索の出力自体には自己証明性がなく、エラーは報告されず、静かにリコール品質とモデルのパフォーマンスを低下させます。検索結果が決済、権限付与、またはオンチェーンの意思決定に使用される場合、このギャップは品質の問題から信頼の問題にエスカレートします。
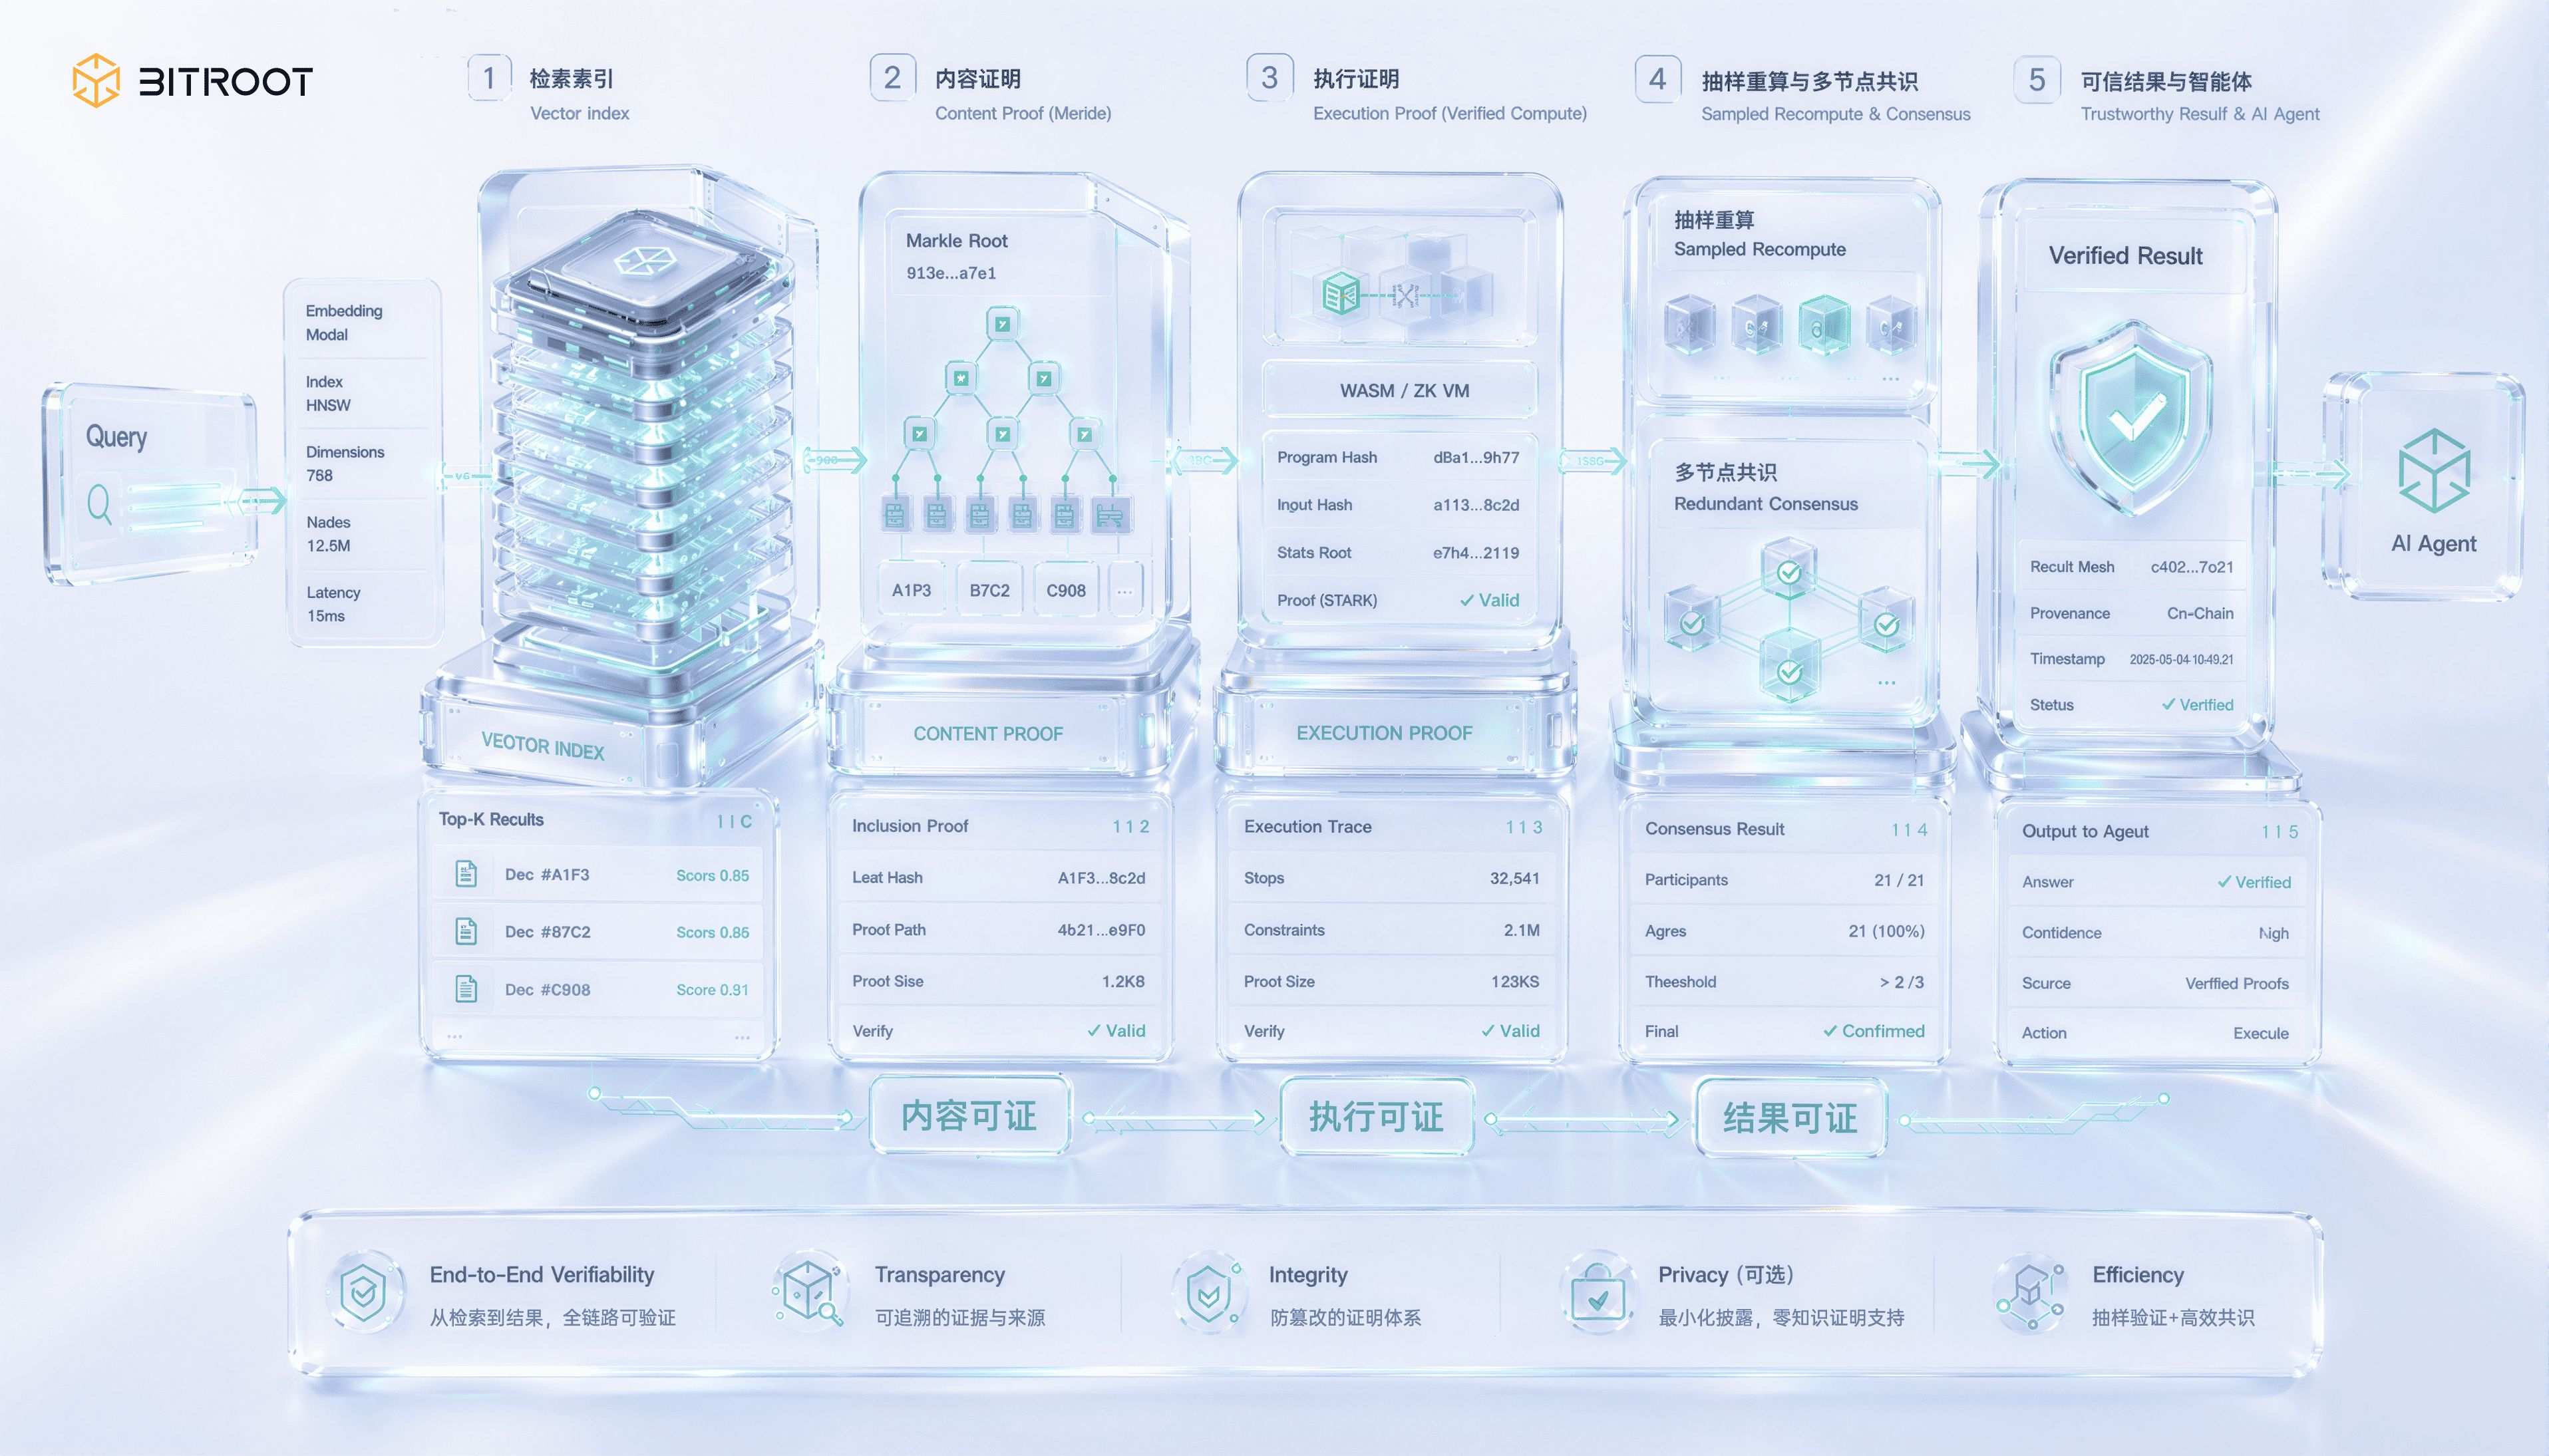
検索可能性を分解すると、実際には3つの層で段階的に難易度が増します。第一層は内容の証明で、返されたベクトルが実際に約束されたインデックスバージョンに属することを証明します。これはインデックスに認証データ構造を構築し、Merkleでインデックスのルートをチェーン上にコミットし、返された結果に含有証明を付けることで、ノードがデータを無から捏造したりすり替えたりすることを確保します。第二層は実行の証明で、今回のクエリが実際にその約束されたバージョンで実行されたことを証明し、私的に変更されたインデックスではないことを示す必要があります。これはクエリプロセスを検証可能な計算の範疇に入れる必要があります。第三層が最も難しく、結果の証明で、返されたtop-kが与えられたメトリックにおいて実際に最近のものであることを証明し、より近い近傍が漏れていないことを示すことです。これは本質的に近似最近傍検索の正確性を提供するための証明を必要とします。
生産規模で高次元近似最近傍の結果を厳密に証明することは、現在も最前線の課題です。ゼロ知識証明などの暗号技術は進展していますが、高次元ベクトル計算の証明コストはまだ大規模オンライン使用のレベルには達していません。実務的なエンジニアリングの解法は、段階的に底を支えること、つまり、一度にすべてを行うのではなく、最初にインデックスバージョンと構築パラメータをチェーンにコミットして追跡可能性を保証し、次にクエリのサンプリング再計算を行い、オンラインクエリで信頼できるコピーを抽出して再実行し、結果を比較し、統計的信頼度で逐次証明を代替します。同時に、複数の独立ノードが冗長に検索し、返された結果に合意を取ります。単一のノードの不正行為コストを引き上げます。比較または合意に相違が生じた場合にのみ、争議クエリの完全再計算とオンチェーン裁定にアップグレードします。このルートは、可用性証明のサンプリング検証優先の考え方と一脈通じています:大規模システムでは、統計的確認と争議のアップグレードが、逐次的な厳密な証明よりも実行可能です。
Bitrootにとって、検証可能な検索は孤立したストレージ機能ではなく、AIエージェントの信頼できる実行の一部です。オンチェーンエージェントが外部の知識ベース、モデルの重み、またはベクトルインデックスに依存して意思決定を行う場合、システムは少なくとも3つの質問に答えられなければなりません:どのデータバージョンを読み取っているのか、どのモデルバージョンを呼び出しているのか、返された結果が登録されたインデックスバージョンからのものであるかどうか。Bitrootはこれらの証拠を圧縮してオンチェーンで検証可能なイベントにし、エージェントの行動を「知的に見える」から「追跡可能、異議を申し立て可能、決済可能」へと進化させることができます。
選択の真の問題は、プロトコルを選ぶことではなく、組み合わせを作ることです。多くの提案が失敗するのは、問題を間違って提起するからです。正しい提起は、私たちが特定のプロトコルを使用する必要があるかどうかではなく、私たちのデータの組み合わせは何か、目標指標は何か、制約条件は何かということです。4つのアクションに従うことをお勧めします。
まずデータ資産の在庫を調査します。少なくとも状態データ、オブジェクトデータ、検索データ、監査データを区別し、在庫テンプレートを固定フィールドにし、最低8項目を含めます:データタイプ、日増量、ピーク同時接続数、読み書き比、保持周期、コンプライアンスレベル、目標遅延、コスト上限。フィールドが統一されると、クロスチームの選択コミュニケーションが大幅に迅速化されます。
サービスレベル目標を再定義します。P95/P99の遅延、復元時間RTO、復元ポイントRPO、可用性目標、単一TBコスト上限を一つ一つ書き留めます。そうでなければ、後のすべての議論に基準がありません。
次に能力マッピングを構築します。永続ストレージ、周期的な可用性証明、低遅延の検索、アクセスガバナンスなどの能力をそれぞれ異なる技術層にマッピングし、単一層で全てをカバーすることを期待しません。
最後に、移行のしきい値を確定します。どのデータが移行期間中に中央集権的なホスティングを許可し、どの指標が移行をトリガーし、いつ去中心化の置き換えを完了する必要があるのか。実用的な方法は、二重のしきい値を事前設定することです:単一TBのコストが連続して2つの統計期間で予算を超えたり、P95の遅延が連続して2週間目標を超えたりすると、自動的にアーキテクチャ移行のレビューをトリガーします。しきい値がなければ、ガバナンスはありません。移行期間は永続的な状態になるでしょう。
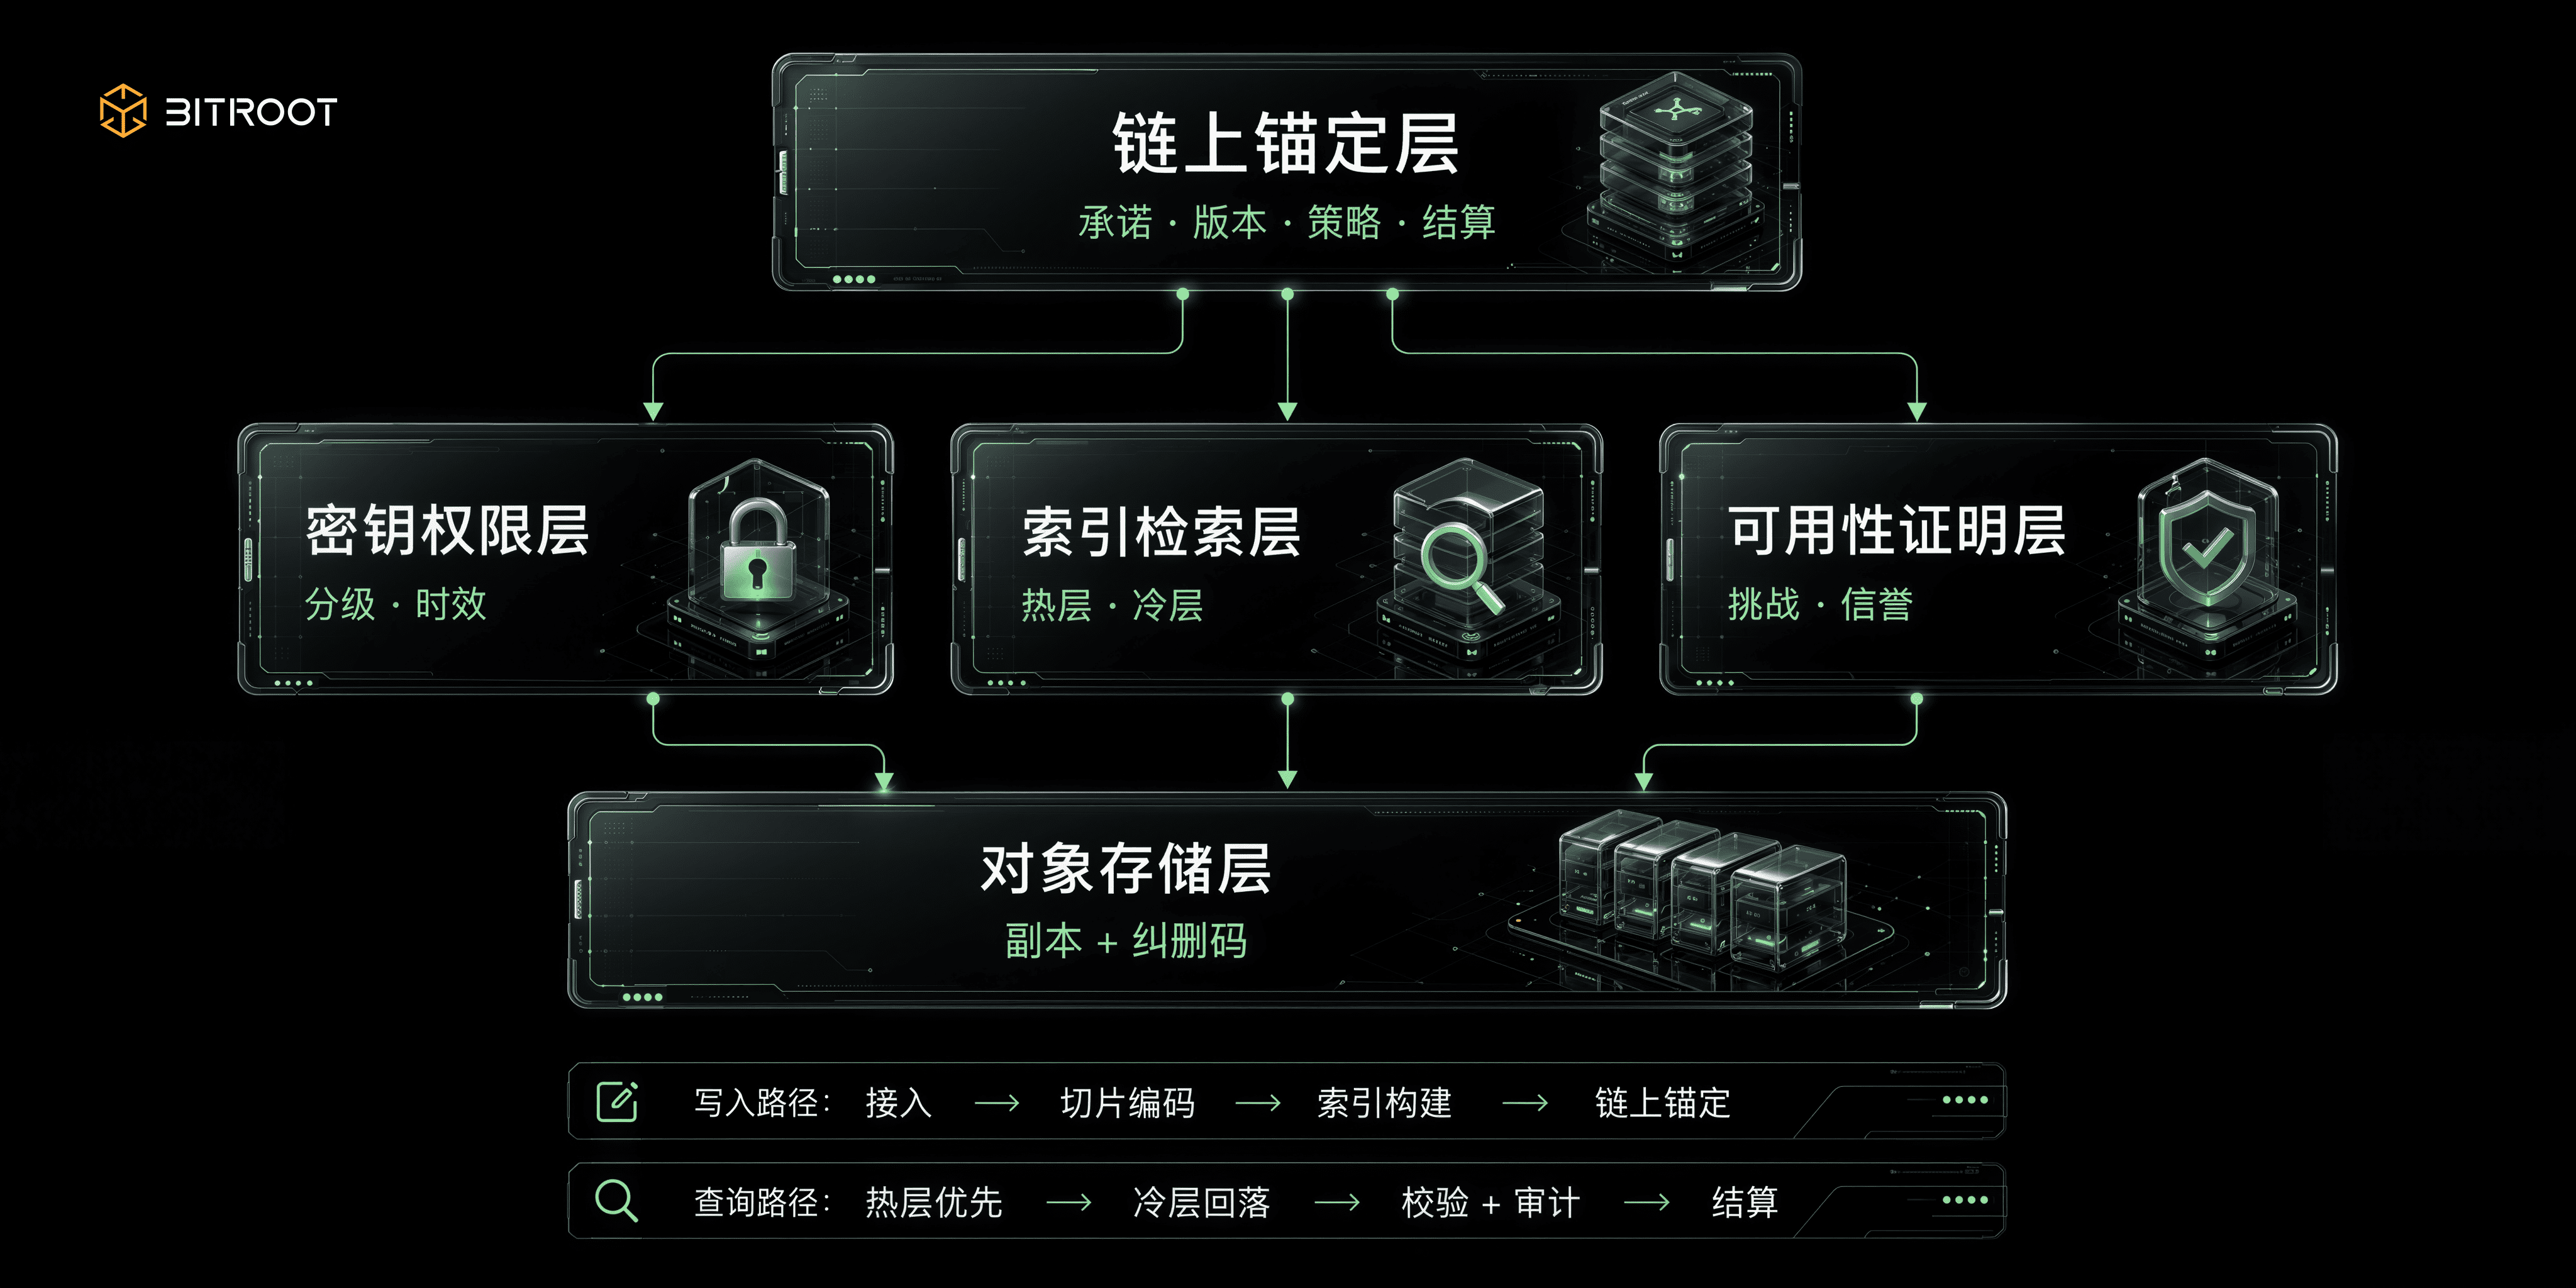
実行可能なソリューション:5層アーキテクチャを構築し、可存、可取、可管理を一環にします。アーキテクチャの価値は層数の多さではなく、検証可能なクローズドループを形成できるかどうかにあります。前述のフレームワークに基づいて、ソリューションは5層に収束します:オンチェーンアンカー層、オブジェクトストレージ層、インデックス検索層、可用性証明層、キー権限層。目標は、検証可能性をデフォルトの能力にし、高性能を構成可能な能力にし、ガバナンスを実行可能なプロセスにすることです。
Bitrootに置くと、この5層はAIスタックのストレージガバナンスモジュールとしてさらに理解できます:Parallel EVMは高頻度のアンカーと決済能力を提供し、Pipeline BFTは低遅延の確定性を提供し、分散ストレージネットワークは大きなオブジェクトと履歴データを受け入れ、インデックス検索層はAIエージェントとアプリケーション呼び出しにサービスを提供し、可用性証明層はノードのサービス品質を信用と報酬に変換し、キー権限層はユーザーの主権、プライバシー保護、モデルの商業化権限を接続します。
オンチェーンアンクリング層は最小限の必要な状態のみを保持します:データの約束、バージョンフィンガープリンツ、権限ポリシーの要約、決済イベント。大きなオブジェクトはチェーン上には載せず、チェーン上に載せるのはそのオブジェクトが存在し、バージョンが正しいという証拠です。これにより、チェーン上の検証可能性を保持しつつ、大きなファイルによってスループットが損なわれることはありません。
Bitrootのアーキテクチャコンテキストの中で、オンチェーンアンカー層は単なる「ハッシュを記録する」場所ではなく、AI資産の登録、権限ガバナンス、収益分配、争議裁定の共同入口です。データセット、モデルの重み、ベクトルインデックス、推論ログは、チェーン下で最も適した方法でストレージできますが、それらのバージョンの約束、権限の状態、呼び出しの記録、収益の帰属はBitrootのオンチェーン状態に入る必要があります。こうすることで、チェーン下のストレージがボリュームを担い、Bitrootが信頼を担います。
オブジェクトストレージ層は実際のデータを担い、エラーレートコードとコピーの混合戦略を採用します:高価値、低頻度アクセスのオブジェクトはフォールトトレランスを重視し、中価値、高頻度アクセスのオブジェクトは検索効率を重視します。この戦略は静的な構成ではなく、アクセスのホットさとビジネスレベルに応じて動的に調整されます。
インデックス検索層はメタデータインデックスとベクトルインデックスを統一されたディレクトリに統合し、ホット層はオンライン検索を受け入れ、コールド層はアーカイブと再構築を受け入れます。すべてのインデックスバージョンは元データバージョンと構築パラメータの出所を登録する必要があり、そうでなければインデックスの漂流を追跡できません。
可用性証明層はノードの行動を定量化します。挑戦に対する応答の成功率、応答遅延、修復成功率がすべて信用スコアに入ります。スコアは報酬配分と結びつけられ、単に容量を報酬として与えるのではなく、可用性を報酬として与えることを避けます。
キー権限層はアクセスとコンプライアンスを制御します。高感度データは階層化されたキーと期限付きの権限を使用し、推論ログはデータの匿名化ストレージと監査再生を使用し、モデル呼び出しには取り消し可能なライセンスを使用します。権限操作自体も痕跡を残す必要があり、設定の漂流を防ぎます。
この5層は実行層としてはクローズドループであり、単方向の流水線ではありません:データが接続された後、最初にスライスしてオブジェクト層にエンコードし、書き込むとインデックスが生成され、オンチェーンにアンカーされます;オンラインクエリはホット層を通り、ヒットが不足するとコールド層に戻ります;結果を返すと同時に完全性検証と権限検証がトリガーされ、重要な行動が決済と監査に入ります。このチェーンの本当の価値は、どのノード、どの瞬間でも、4つの質問に答えられることです:データはどこから来たのか、現在のバージョンは何か、誰がアクセス権を持っているのか、システムはそれが可用であることを証明できるのか。
これもBitrootがAIストレージガバナンスを担当するのに適している重要な理由です。AIエージェントの呼び出し、モデルバージョンの切り替え、データ権限の変更、検索結果の争議は、低頻度のバックグラウンド操作ではなく、アプリケーションの成長とともに継続的に発生するオンチェーンイベントです。基盤となるチェーンが十分に低い確認遅延と十分に高いスループットを提供できない場合、ストレージガバナンスは最終的にオフチェーンの表や手動の調整に強制的に戻ることになります。BitrootのParallel EVMとPipeline BFTの組み合わせは、高いTPSだけでなく、これらの高頻度のガバナンスイベントをリアルタイムでアンカー、決済、責任を持つことを可能にします。
誰が支払うのか:容量ではなく可用性が収益を決定します。ストレージが長期間稼働するためには、インセンティブは可用性に向けなければならず、容量を積むことではありません。容量だけを報酬として与えることは、ノードにハードディスクを積ませ、サービスを軽視することを意味します。この点で、Filecoinはメカニズムで修正を行っています:それは、実際にストレージオーダーを承接し、特に検証された有効なオーダーを持つセクターが、計算力の測定でより高い重みを得る「品質調整済みパワー」の概念を導入しました。これにより、真にサービスを提供する容量に報酬が傾き、単にパッケージされた空の容量には傾かないようにします。この考え方は、自己構築のインセンティブ層が参照するに値します。
これを実行可能な報酬関数に落とし込むには、少なくとも4つの次元を同時に考慮し、それぞれの重みの論理を明確にする必要があります。容量は基礎的なシェアを決定し、あなたがどれだけのスペースを約束したかを回答します。オンライン率と応答遅延はサービス品質係数を決定し、このスペースが必要とされたときに本当に取得可能かを回答します。この項目は高い重みを占めるべきであり、さもなければ可用性は単なるスローガンに過ぎなくなります。データ復元成功率は災害回復の信頼性を決定し、ノードがダウンした後にコピーが再構築できるかを回答します。これはロングテールデータの生存に直接関係します。データの価値密度は需要側の加算を決定し、高価値のデータセットや高需要のモデルには差別化された倍率を設定し、希少で頻繁に呼び出されるデータにより高いリターンを得られるようにします。報酬は証明可能なサービスに与えられるべきであり、宣言された容量に与えられるべきではありません。
正のインセンティブだけでは不十分であり、制約側の質押、罰則、仲裁が同時に整う必要があります。また、1つの基本的不等式を満たさなければなりません:不正行為の期待収益は、罰没される期待コストを下回らなければなりません。そうでなければ、どんな証明メカニズムも経済的合理性によって回避されるでしょう。質押はノードが可用性の約束に対してコストを賭けることを要求し、担保の規模はその約束に対する計算力とデータの価値に比例するべきです;Filecoinの設計では、ストレージ側は約束された計算力に応じて前置担保を支払う必要があり、証明ウィンドウ内にダウンすると障害料金が発生し、セクターが永久的に放棄されると、より重い終了罰が発生します。この階層的な罰の意義は、短期的なダウンと悪意のある退出を区別することです。仲裁は、オンチェーン証拠を駆動して争議を処理します:ユーザーがデータが利用できないと主張し、ノードが正常にサービスを提供していると主張する場合、挑戦記録、サンプリング証明、イベントログが可読的な裁定の根拠を構成し、本来は人間の介入が必要な争いを検証可能なオンチェーンの判定に圧縮します。
AIシーンでは、3者の収益をどう分配するかという難しいガバナンスが必要です。再度呼び出されるモデルの背後には、データの貢献者が提供したコーパス、モデルの貢献者が投入したトレーニング、ストレージノードが担うホスティングがあり、3者すべてが最終的な呼び出し価値に貢献していますが、貢献を直接観測することは困難です。実行可能な方法は、価値の帰属を計測可能なオンチェーンイベントに基づいて構築することです:呼び出しに応じて課金し自動決済し、データとモデルをバージョンフィンガープリンツと血縁関係で結びつけ、事前に書かれたプログラム可能な分配比率に基づいて自動的に分割し、事後の準拠を避けます。それに伴うのがブラックリストと罰没メカニズムです。悪意のあるデータアップロード、著作権侵害、モデル盗用などの行為には、仲裁で認定されれば即座に担保を差し押さえ、以降の収益を凍結します。さもなければ、直感に反する結果が生じることになります:資産化が進むほど、分配と権利確定の争いが増え、最終的にエコシステムの信頼自体が崩壊します。
コンプライアンスは導入後のパッチではなく、アーキテクチャ期間中の制約です:安全基準はエンドツーエンドの暗号化、階層化されたキー管理、周期的なローテーションで、ハッシュ検証とMerkleコミットを重ねてダウンロードの検証を保証し、複製とエラーレートコードを用いて障害回復を確保します;プライバシーに関しては、データレベルに応じた最小権限のアクセス制御を行い、取り消し可能な権限、一回限りの権限、期限付きの権限をサポートし、重要なアクセスと操作は全てのリンクで痕跡を残し、監査再生を容易にします。コンプライアンスは最も後に持ち込まれ、コストの高い部分でもあります:データのローカリゼーションやクロスドメイン転送ポリシーは可配置である必要があり、削除、アクセス、監査のリクエストには標準的なプロセスインターフェースを持たなければなりません;最も厄介なのは改ざん不可と削除可能の天然の対立で、実行可能な解決策は暗号化の消去とインデックスの無効化です:キーを破壊して暗号文を復元できなくし、インデックスを無効化してデータを検索できなくし、チェーン上の記録を保ったまま削除要求を満たします。パイロットから生産までには3つの段階的なしきい値があります:まず最小限の信頼できるクローズドループを構築し、オブジェクトストレージ、オンチェーンのアンカー、完全性検証、基本監視を安定して実行し、可用性、読み書き成功率、アンカーとオブジェクトのバージョンの一致率、障害回復が試行できるかで受け入れを行います;次にAI資産化とインデックスガバナンスを行い、データセットとモデル資産管理、バージョン系譜、ベクトルインデックスのホットとコールドの層分け、モデル権限の呼び出し、トレーニングデータの出所登録を導入し、受け入れはトレーニングの追跡可能性、モデルのロールバックと監査可能性、ホット層の遅延基準、インデックス再構築の影響の制御を確認します;最終的に検証可能な検索と自動化ガバナンスを導入し、挑戦証明、ポリシーの移行、報酬と罰則の自動化を行い、受け入れは可用性証明のカバレッジ、リスク処理の遅延、単位コストの減少、ポリシー変更の追跡可能性とロールバックを確認します。指標体系は戦略システムであり、展示用の報告書ではありません。技術項目だけを書き、ビジネス成果を書かないと、ストレージソリューションは純粋なコストセンターに崩壊します。3層に分けることをお勧めします:基礎技術指標(可用性、P95/P99の遅延、スループット、RTO/RPO、エラー率)がシステムの健康を回答し、AI専門指標(トレーニングデータの追跡可能率、モデルの再現性、推論検証のカバレッジ、インデックスの一貫性)がモデルの品質がガバナンス可能であるかを回答し、ビジネス結果指標(データ供給の増加、呼び出しコストの低下、ノードの活動度、資産取引の規模)がシステムが価値を創造しているかを回答し、3層の間にはマッピング関係が必要で、指標の真の用途は戦略調整の入力であり、展示用の報告書ではありません。最も一般的な5つの失敗点は基本的に事前に回避できます:ストレージを行いながらバージョンガバナンスを行わない、データがあっても可用性を保証されていない、可用性があっても再現性を保証されていない;容量を見ずに可用性証明を見ない、容量に基づいて報酬を与えると容量を積み上げてサービスを軽視する誘導になる;ホットとコールドの層分けは行ったが同期戦略が行われていない、インデックスバージョンの同期と無効処理がクローズドループされていない;コンプライアンス戦略が後置され、権限、ログ、脱敏、削除への応答が遅れるほどコストが増加する;過渡的なアーキテクチャに退出メカニズムがない、先に中央集権化してから去中心化するのは合理的な道ですが、移行のしきい値が欠けると過渡的な状態が固定化され、初志から逸脱します。
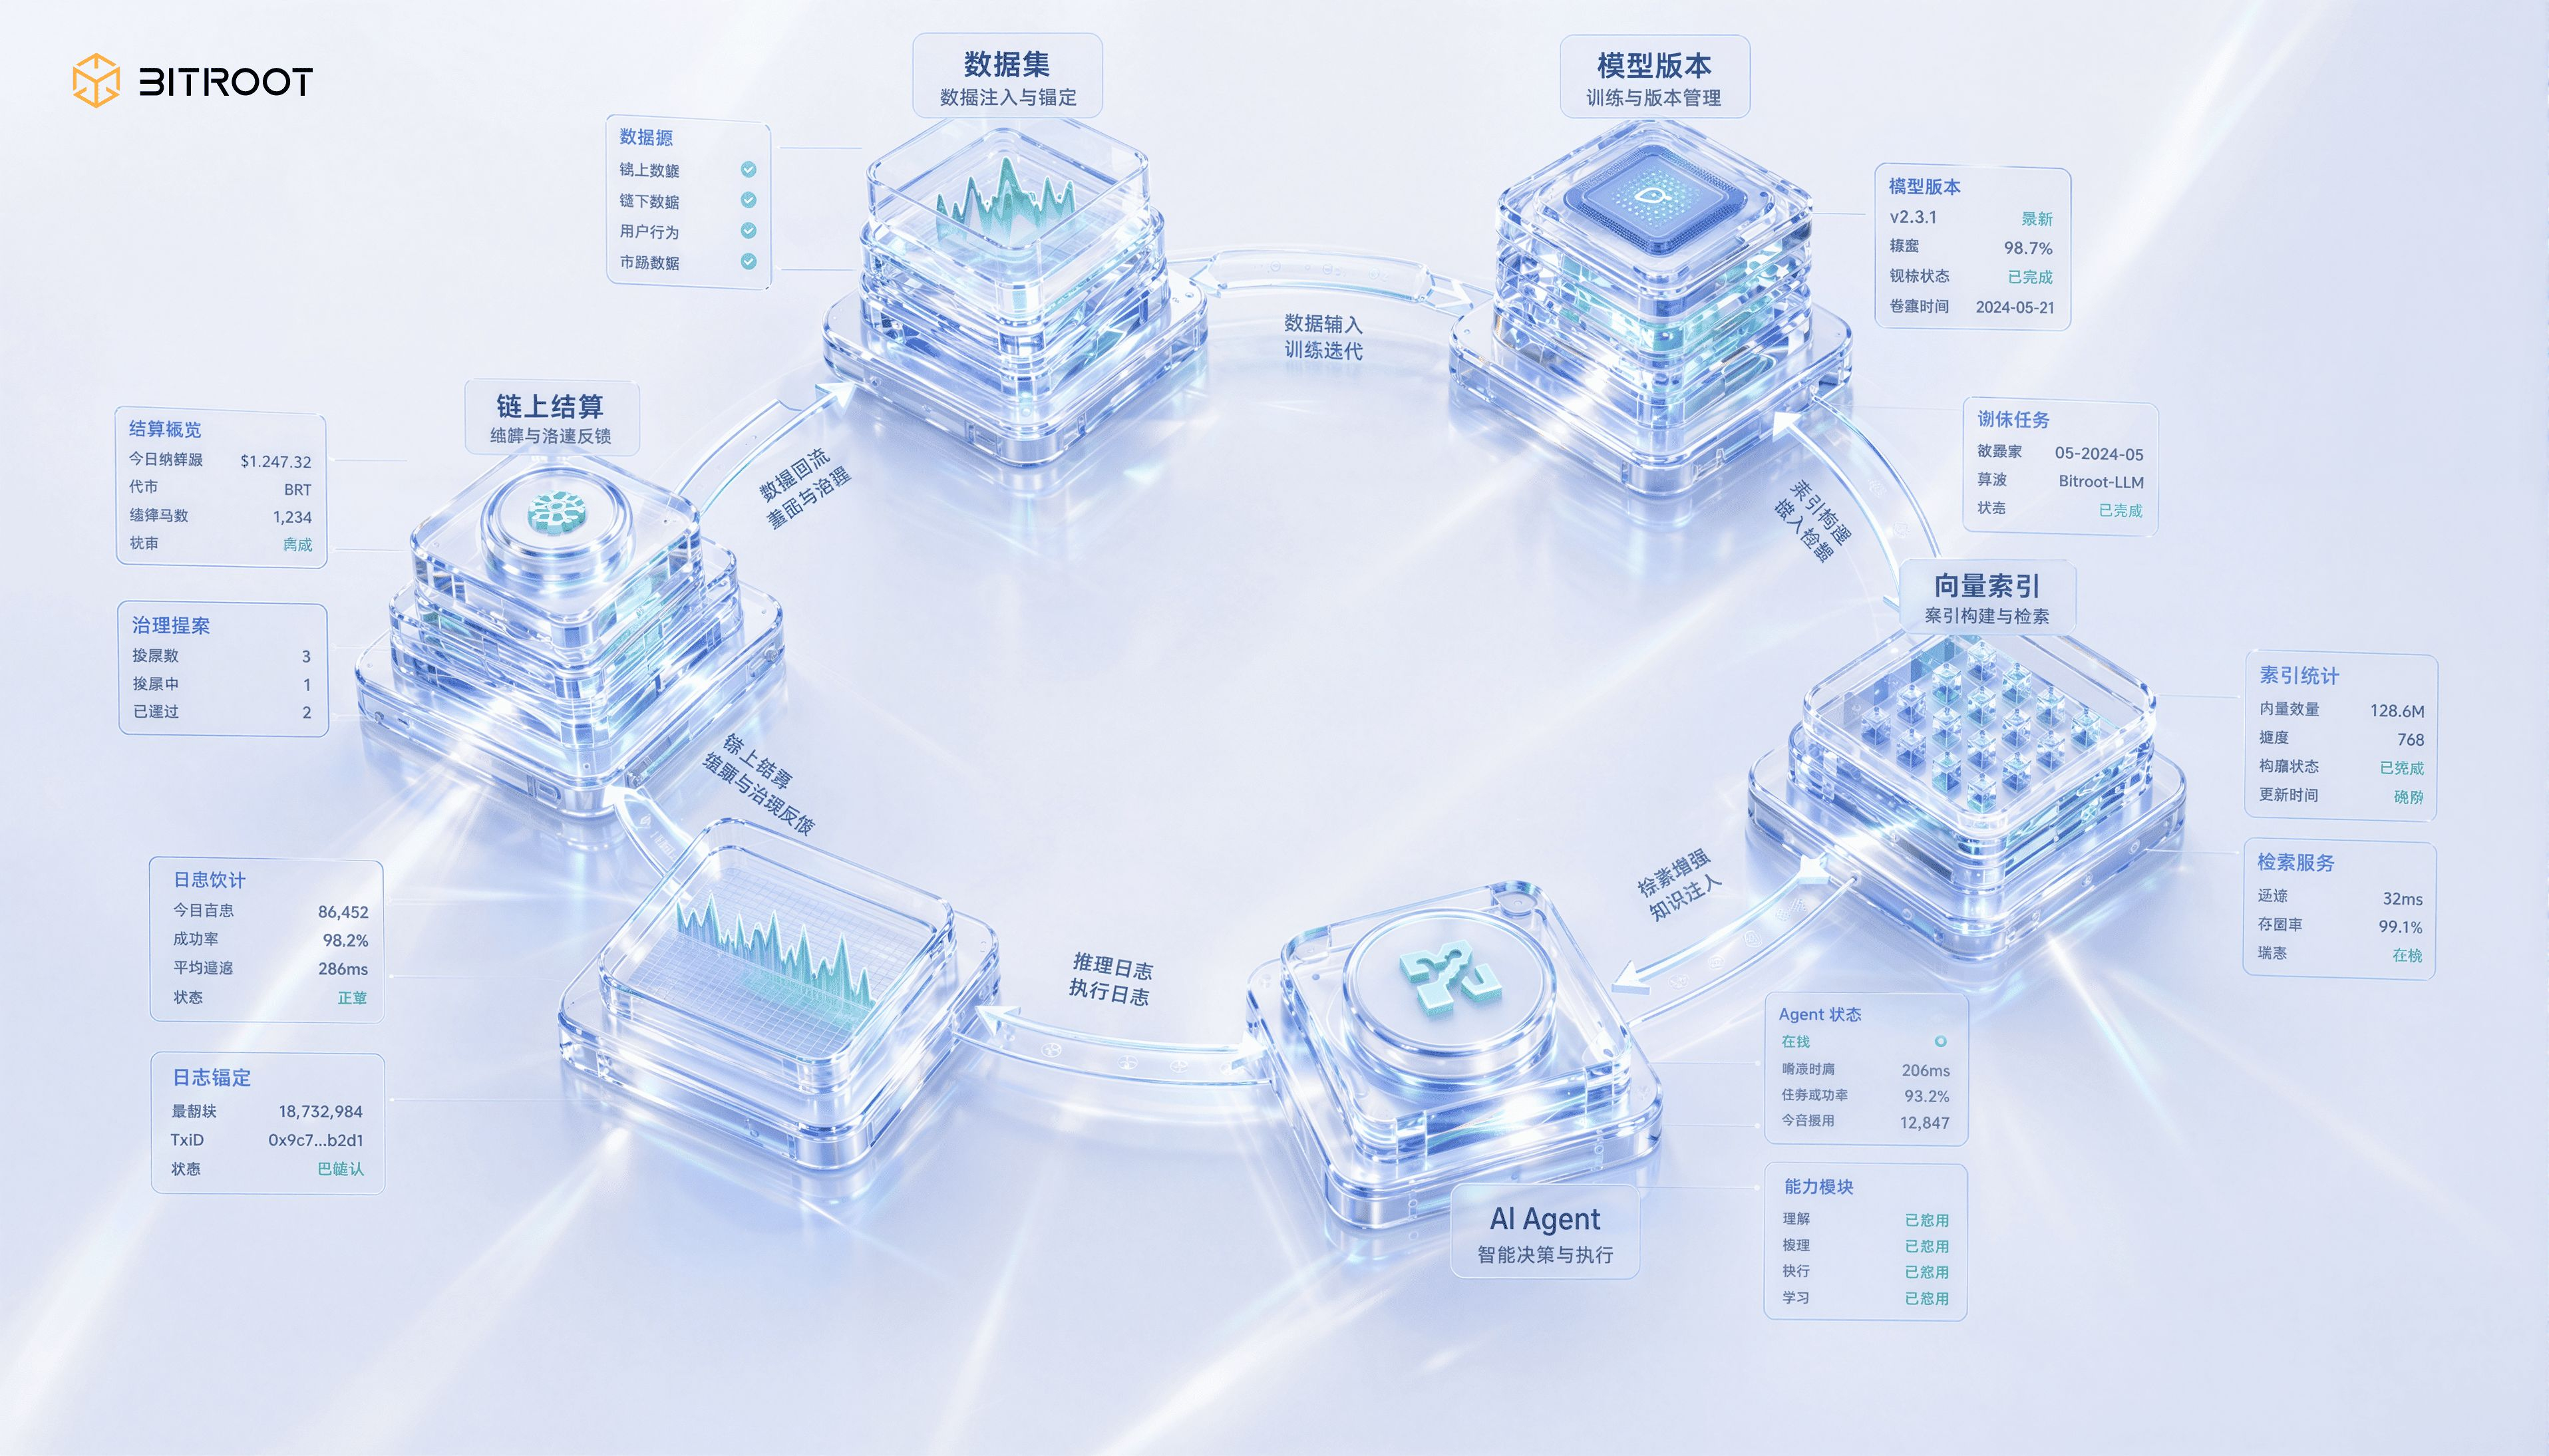
Bitrootの完全なクローズドループ:データ、モデル、AIエージェントからなるこのクローズドループの中で、BitrootはAI資産の重要な行動をすべて決済可能なイベントに変換できます:データセットの登録、モデルバージョンのリリース、ベクトルインデックスの再構築、AIエージェントの呼び出し、推論ログのアンカー、権限の付与と取り消し、異議申し立てと仲裁結果。チェーン上はすべてのデータを保持する必要はありませんが、これらの行動の最小限の証拠を保持する必要があります。これにより、データ、モデル、計算力、アプリケーション間の価値関係は口頭の約束にとどまらず、プログラム可能な分配と監査可能なガバナンスに入ることができます。
このメカニズムをBitrootの運営とエコシステムの拡張に適用すると、ストレージのインセンティブは単独のハードウェア補助として設計されるべきではなく、AIスタックの価値の流れの一部となるべきです:データ貢献者はデータがトレーニングまたは呼び出されることで収益を得、モデル貢献者はモデルサービスで収益を得、ストレージと検索ノードは持続的な可用性と低遅延サービスで収益を得、検証と挑戦ノードは不可用性、インデックスの漂流、または権限の異常を発見することで報酬を得ます。こうして、Bitrootの経済システムが報酬を与えるのは「アップロードした」ことではなく、「持続的に証明可能に有用である」ことです。
ストレージはコストセンターではなく、信頼と価値分配システムです。AI時代の分散ストレージが解決すべきは、特定のストレージ製品の置き換えや去中心化の物語を追求することではなく、4つのより難しいことです:長期的に可用な信頼できる証明、主体間協力のガバナンス秩序、データとモデルの責任のチェーン、持続可能な経済的インセンティブです。
単一のプロトコル単層アーキテクチャでは、これらの目標をカバーできません。より現実的な道は、組み合わせアーキテクチャです:コンテンツアドレッシングは完全性を保ち、ストレージ証明は時間次元の可用性を保ち、永久層は重要な歴史を保ち、ホット層はオンライン体験を保ち、オンチェーンアンカーはガバナンスと決済の証明を保ちます。これは妥協ではなく、エンジニアリングの理性です。実行においても、最も機能が豊富であることではなく、クローズドループが最初に成立することが重要です。最小の信頼できるクローズドループを通過させた後、AI資産化、検証可能な検索、自動化ガバナンスを段階的に追加します。
この方法を1週間のアクションに圧縮すると、実際には3ステップしかありません:1日目に8フィールドのデータ在庫表を完成させ、3日目に実際のビジネスドメインで接続、ストレージ、検索、検証の最小チェーンを一度通過させ、7日目にP95の遅延と単位コストで移行のしきい値を振り返る会議を開きます。これら3つのステップを実行すれば、チームは概念の合意からエンジニアリングの合意に移行します。
ただし、現実的な境界を認める必要があります:どのプロトコルの組み合わせを採用しても、コスト、遅延、持続可能性の間にはトレードオフが存在し、すべてのビジネスに最適な単一の答えは存在しません。本当に持続可能なソリューションは、明確な境界の下での継続的な反復から生まれ、一次的な決定の後の長期的な静的構成ではありません。
未来にプロジェクトを淘汰するのは、しばしばTPSが十分でないからではなく、データ責任のチェーンが明確でないからです。AIパブリックチェーン時代、ストレージはデータを単に入れることではなく、データをいつでも証明できるようにすることです。
結論
真のAIパブリックチェーンの競争は、最終的にはTPS、Gas、または確認時間の比較に留まることはありません。性能は入口ですが、終局ではありません。AIネイティブアプリケーションの時代に入ると、チェーン上のシステムが担うべきは、取引だけではなく、データのバージョン、モデルの呼び出し、計算力のスケジューリング、推論の記録、エージェントの行動、複数の収益分配です。
これもBitrootがストレージ層に対する判断です:ストレージは単なる付随モジュールではなく、AIスタックの価値の源に最も近い層です。データが証明できるか、モデルが再現できるか、呼び出しが監査可能か、収益が自動的に分配されるかは、分散型AIネットワークが本当に長期的な生命力を持つかどうかを決定します。
Bitrootが構築しようとしているのは、単により高速な実行を追求するチェーンではなく、AI資産が確認され、呼び出され、決済され、ガバナンスされるインフラストラクチャです。Parallel EVMとPipeline BFTは高頻度のオンチェーンイベントの負荷能力を解決し、分散ストレージと検証可能なメカニズムはAIデータとモデルの信頼の基盤を解決し、プログラム可能な分配とオンチェーンガバナンスは貢献を持続的な経済的インセンティブに変えます。
AIエージェントがユーザーを代表して行動し始め、モデルとデータが流通資産になると、計算力、ストレージ、推論サービスが同じ価値ネットワークに入ると、ストレージは「ファイルをどこに置くか」という問題ではなくなります。
それはAIパブリックチェーンの信頼の基盤となり、次世代のインテリジェントネットワークの価値分配システムとなります。
Bitrootにとって、未来で本当に重要なのは、誰が最も多くのデータを所有しているかではなく、誰がデータをいつでも証明可能で呼び出し可能、追跡可能にし、最終的に価値を決済できるかです。
Bitrootについて。Bitrootは、並列実行とAIネイティブアーキテクチャに焦点を当てたLayer 1のパブリックブロックチェーンプロジェクトです。BitrootはEVM互換技術路線を採用し、並列実行メカニズム、コンセンサスの最適化、AI関連インターフェースの設計を通じて、AIエージェント、DeFi、Web3アプリケーションに高性能で低コストのオンチェーン実行環境を提供することを探索しています。
私たちに参加してください:
公式サイト:https://bitroot.co/
推特:https://twitter.com/Bitroot_
Telegram:https://t.me/bitroot_official