みんなAIを「オンチェーン」にすることに夢中だ。でも、最初からそれがひどいアイデアだって聞いた人はほとんどいないよ。
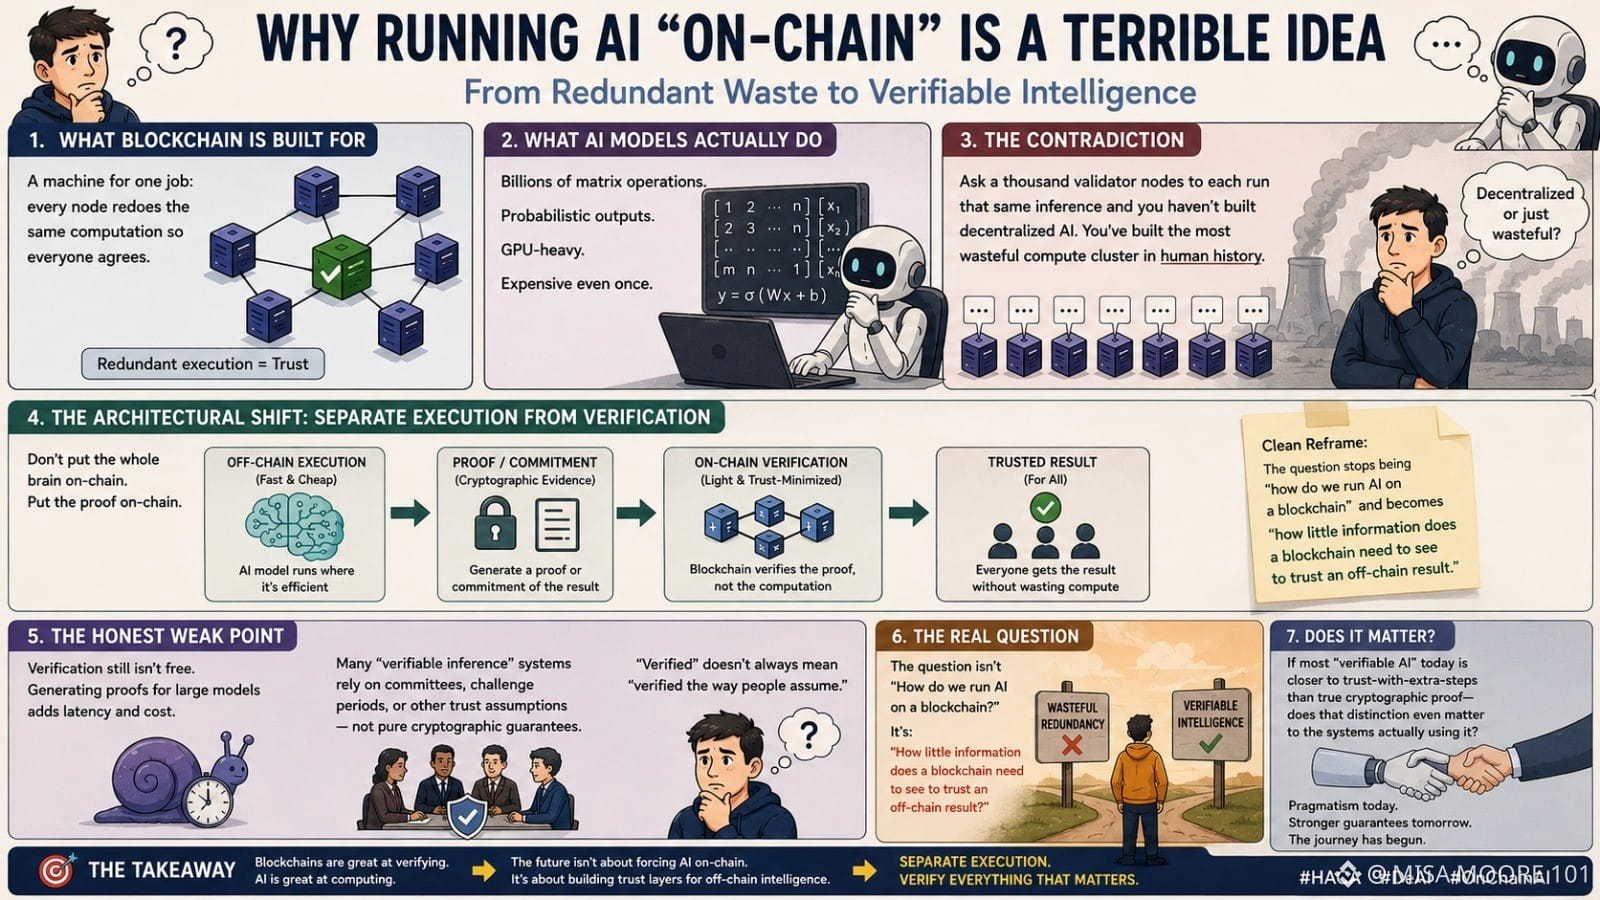
ブロックチェーンが実際に何なのか考えてみて。全てのノードが同じ計算をやり直して、結果にみんなが同意できる機械だ。それが信頼モデルの全てだ。今、AIモデルが何をしているか考えてみて。何十億もの行列演算、確率的な出力、GPUに負荷がかかって、一度実行するだけでも高価だ。千のバリデーターノードにそれぞれ同じ推論を実行させたら、分散型AIを構築したことにはならない。あなたは人類史上最も無駄な計算クラスターを作っただけだ。
これが誰も話さない静かな矛盾なんだ。ブロックチェーンを信頼できるものにしている冗長な実行は、AI推論を直接実行することを経済的に不可能にする正確な要因なんだ。だから、プロジェクトはそれを偽装する(分散型のラベルを貼った中央集権的な計算)か、実際にアーキテクチャを再考しなければならない。
それがまさに「ハイブリッドAIコンピュートアーキテクチャ」スタイルのデザインが解決しようとしていることだ。実行を検証から分離すること。実際のモデルはオフチェーンで、最も安くて速いところで動く。オンチェーンに載せるのは計算そのものではなく、計算が正しく行われたことの証明やコミットメントだ。チェーンはコンピュータでなくなり、レフェリーになる。
見えてくるとすっきりする:質問は「ブロックチェーン上でAIをどうやって動かすか」から「オフチェーンの結果を信頼するためにブロックチェーンが見る必要がある情報はどれくらい少ないか」に変わる。
正直な弱点は、検証は無料ではない。大規模モデルのための証明を生成することはレイテンシーとコストを追加するし、今日の多くの「検証可能な推論」は依然として信頼の仮定(委員会、楽観的チャレンジ期間)に依存している。実行を検証から分離するのは正しい方向だが、「検証済み」が常に「人々が仮定する方法で検証された」を意味するわけではない。
「検証可能なAI」が暗号的証明の代わりに追加のステップを必要とする場合、ユーザーにとってそれは重要なのだろうか?
#HACA #DeAi #OnChainAi
@OpenGradient #OPG $OPG
ブロックチェーンが実際に何なのか考えてみて。全てのノードが同じ計算をやり直して、結果にみんなが同意できる機械だ。それが信頼モデルの全てだ。今、AIモデルが何をしているか考えてみて。何十億もの行列演算、確率的な出力、GPUに負荷がかかって、一度実行するだけでも高価だ。千のバリデーターノードにそれぞれ同じ推論を実行させたら、分散型AIを構築したことにはならない。あなたは人類史上最も無駄な計算クラスターを作っただけだ。
これが誰も話さない静かな矛盾なんだ。ブロックチェーンを信頼できるものにしている冗長な実行は、AI推論を直接実行することを経済的に不可能にする正確な要因なんだ。だから、プロジェクトはそれを偽装する(分散型のラベルを貼った中央集権的な計算)か、実際にアーキテクチャを再考しなければならない。
それがまさに「ハイブリッドAIコンピュートアーキテクチャ」スタイルのデザインが解決しようとしていることだ。実行を検証から分離すること。実際のモデルはオフチェーンで、最も安くて速いところで動く。オンチェーンに載せるのは計算そのものではなく、計算が正しく行われたことの証明やコミットメントだ。チェーンはコンピュータでなくなり、レフェリーになる。
見えてくるとすっきりする:質問は「ブロックチェーン上でAIをどうやって動かすか」から「オフチェーンの結果を信頼するためにブロックチェーンが見る必要がある情報はどれくらい少ないか」に変わる。
正直な弱点は、検証は無料ではない。大規模モデルのための証明を生成することはレイテンシーとコストを追加するし、今日の多くの「検証可能な推論」は依然として信頼の仮定(委員会、楽観的チャレンジ期間)に依存している。実行を検証から分離するのは正しい方向だが、「検証済み」が常に「人々が仮定する方法で検証された」を意味するわけではない。
「検証可能なAI」が暗号的証明の代わりに追加のステップを必要とする場合、ユーザーにとってそれは重要なのだろうか?
#HACA #DeAi #OnChainAi
@OpenGradient #OPG $OPG