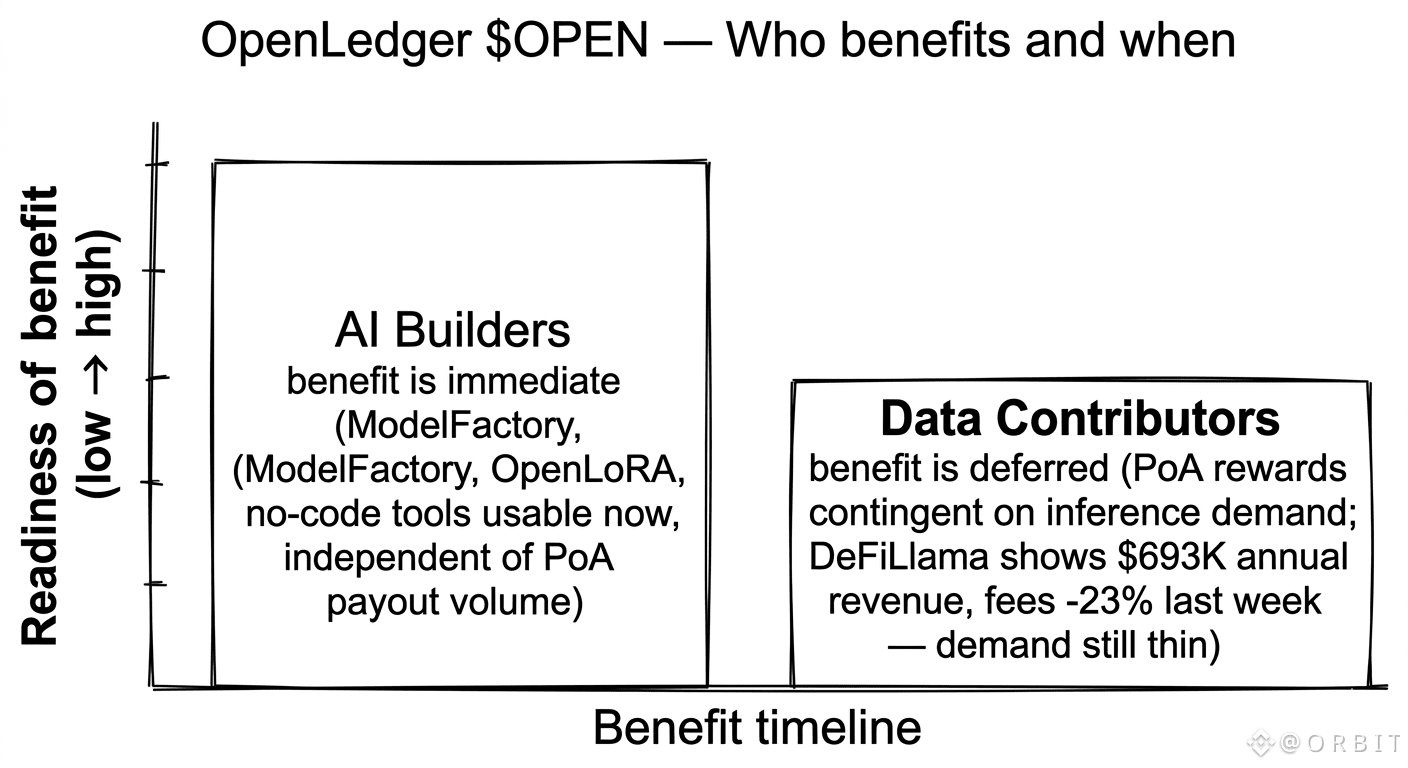
OpenLedger $OPEN #OpenLedger @OpenLedger のタスクで印象に残ったのは、2つの受益者グループ——AIを構築する人々とデータ提供者——が、同時に参加するかのように説明されているにもかかわらず、それぞれまったく異なる時間軸で動いていることです。構築者はすぐに実用的な価値を得られます。ModelFactoryは今すぐ使え、ノーコードのファインチューニングも今すぐ使え、OpenLoRAなら大規模なインフラを用意しなくてもモデルをデプロイできます。こうした価値は最初から得られるもので、Proof of Attributionの好循環が回り始めるかどうかには左右されません。一方、提供者は事情が異なります。彼らへの報酬が実際に生まれるのは、自分たちのDatanet上で構築されたモデルが大規模に利用されてからです。しかし、DeFiLlamaによると、プロトコルの年間収益は69万3,000ドルにとどまり、過去1週間の手数料も23%減少しています。これは、推論への需要がまだ小さいことを示唆しています。設計の筋は通っていますが、説明から受ける印象以上に、進める順序が重要です。構築者が参加してインフラ上で開発し、モデルは利用を待つ。一方、提供者はすでにデータをアップロードし、貢献し、貢献記録も獲得しています……そして今、まだ十分には到来していない需要を待っています。この隔たりが埋まるかどうかは、参加した構築者たちが、実際に人々に使われるプロダクトを出荷するかどうかに完全にかかっています。