正直に言うと、私はときどきAIについて同じ考えに戻ってしまい、それがなかなか消えません。
私たちは、同じことを何度も何度も繰り返して話しています。より大きなモデル、より速い推論、より優れた推論、新しいベンチマーク、賢いエージェント。もちろん、それらは本当に改善につながっています。進歩は実際にあって、目に見えます。ですが、この競争のどこかで、非常に単純な問いがしばしば見過ごされます。
そもそも、このAIの背後にある価値を実際に生み出しているのは誰なのでしょうか?
なぜなら、立ち止まってよく見てみれば、今日AIが行うすべてのことが、ある一つのものの上に成り立っていることが明らかだからです。それはデータです。単なる技術的なデータではなく、深く人間的なデータ。人々が交わす会話、書き記すもの、犯すミス、公開するコード、共有する意見、後から加える訂正――つまり、インターネット上に残された、人間の思考の足跡のほぼすべてです。
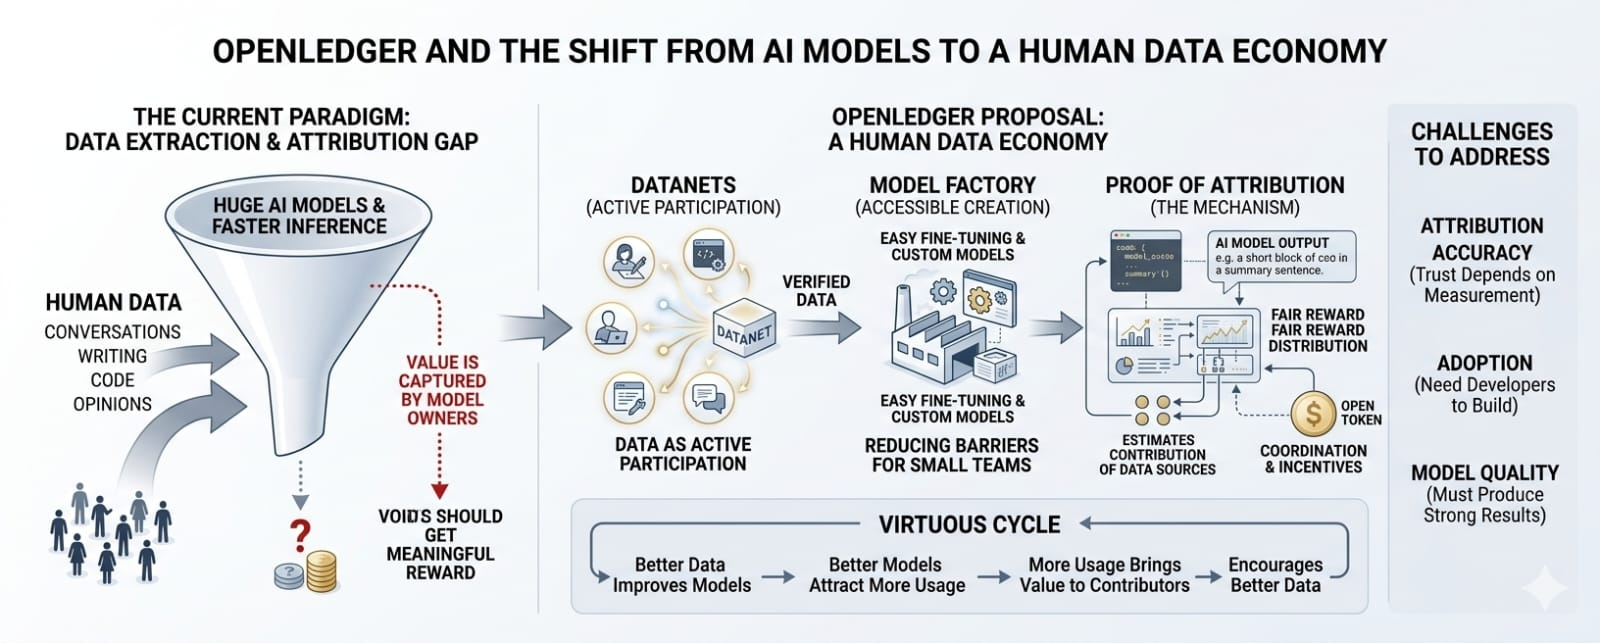
しかし奇妙なのは、その次に何が起きるかです。これらすべてが大規模モデルに吸収された後に出てくる価値は、主にモデルの所有者によって回収されます。元々のデータを実際に生成した人たちは、通常は何も意味のある形で返ってきません。認知もほとんどなく、さらに、彼らの寄与に直接結びついた報酬はほぼありません。
それが、私がOpenLedgerのようなアイデアを探し始めた地点です。
一見すると、ただの別のAIとブロックチェーンのプロジェクトに見えます。正直なところ、そういう類のプロジェクトはたくさんあります。「AI + ブロックチェーン」が本当の転換ではなく、マーケティングの層になっているケースです。ですが、もう少し深く見ると、ここでの角度は少し違います。従来の意味で「より良いモデル」を作ることに執着しているわけではありません。代わりに、もっと居心地の悪い、しかしより重要な問いを投げています。
貢献が意味のある形で測定され、報酬として還元されるAI経済を、実際に構築できるでしょうか?
その問いは、方向性を完全に変えてしまいます。
datanetsという発想は、これに当てはまります。データを、気軽にスクレイピングしたり集めたりして、その後忘れてしまうものとして扱うのではなく、特定のAIユースケースに向けて人々がデータを作り、検証し、改善できる、構造化された継続的な仕組みの一部にします。言ってしまえば簡単に聞こえますが、含意は大きいのです。データがサイレントな入力でなくなり、経済への能動的な参加に近いものになっていくからです。
そして「モデル・ファクトリー」という発想があります。この部分は見落とされがちですが、非常に重要です。今のところ、AIシステムの構築やファインチューニングは、強力な技術リソースを持つチームにほぼ限られています。そのハードルを下げて、モデル作成をもっと手軽にできるようにすれば、突然、より幅広い層のビルダーへの扉が開かれます。大規模な研究ラボだけではなく、より小さなチーム、さらにはアイデアはあるがインフラはない個人までが対象になります。
しかし、最も重要であり、同時に最も難しい概念が「帰属の証明(Proof of Attribution)」です。
ここから一気にややこしくなります。というのも今日では、AIが出力を生成するとき、すべてがごちゃ混ぜになってしまうからです。結果のどの部分に、どのデータソースが正確に影響したのかを明確に示す方法がありません。すべてが、数学的に分散された形で、実用的には追跡不能なやり方でモデルに吸収されていきます。
帰属の証明(Proof of Attribution)は、それを、さまざまなデータソースが特定のAI出力にどれだけ寄与しているかを推定することで変えようとしています。そうすれば、報酬をより公平に分配できます。もしこのような仕組みが本当にスケールして機能するなら、AI経済の構造そのものが完全に変わるでしょう。なぜなら突然、データ提供者が見えない存在ではなくなり、測定可能な価値創出の仕組みの一部になるからです。
技術面では、EVMの互換性も採用に影響します。Ethereumのツールやインフラと足並みをそろえたままでいれば、開発者はゼロからすべてを学ぶ必要がありません。使い慣れたウォレット、スマートコントラクト、既存のワークフローをそのまま利用できます。この種の互換性は小さく聞こえるかもしれませんが、実際のエコシステムでは、それが採用されるか無視されるかを決めることがしばしばあります。
$OPEN tokenは、システムの調整(コーディネーション)レイヤーになります。この文脈では、単に取引や投機のためのものではありません。利用、報酬、ガバナンス、インセンティブを1つのループに結びつけることが目的です。理論上は、人々がシステムを使うことで価値がシステムへと流れ戻り、貢献者は参加に基づいて報酬を受け取ります。
でも正直に言うと、これらはどれも簡単ではありません。
少なくとも3つの大きな課題が、すぐに際立って見えてきます。
1つ目は帰属の精度です。システムが寄与を信頼できる形で測定できないなら、その上に構築されるものはすべて疑わしくなります。この種の仕組みでは、信頼がとても早く崩れます。
次は採用です。アイデアが強力であっても、開発者やユーザーが実際にその上に構築しなければなりません。実際の利用がなければ、それは紙の上の単なるアイデアのままです。
3つ目はモデルの品質です。結局のところ、ユーザーは理論には関心がありません。結果を重視します。システムがより遅い、あるいはより弱い出力しか生み出せないなら、報酬システムがどれほど公平でも、ユーザーは残りません。
それでも、このすべての中で一番面白いのは、システムが作ろうとしているループです。より良いデータはより良いモデルを生み、より良いモデルはより多くの利用を呼び込み、より多くの利用はより多くの価値を貢献者へと返します。つまり、より良いデータがまた促される、という好循環になります。ワンウェイのパイプラインではなく、サイクルになるのです。
そして、おそらくここでの本当の転換点はそこにあります。
より賢いAIシステムを作るだけでなく、そもそも知性・データ・所有がどうつながっているのかを、ゆっくりと再考することです。
この先どこへ向かうのか言い切るのは難しいです。AI経済の設計は、理論で説明するよりずっと複雑です。とはいえ、次第に確かなことがひとつあります。AIがより強力になるにつれて、その周りの問いは、単なる技術的な問題ではなくなっていく、という点です。
それらは経済的で構造的なものになります。
誰が貢献するのか? 誰が報酬を得るのか? そして、集団的な人間の入力で作られる仕組みの中で「公平」をどう定義するのか?
そして、たぶんそうした問いは、どんなベンチマークよりも、AIの次のフェーズを形作ることになるのかもしれません。