
オープンレジャーとAI経済を構築するレース
人工知能には奇妙な秘密がある。
みんなモデルについて話してるけど、実際にそれを支えている人々についてはほとんど誰も話さないね。
ちょっと考えてみて。
すべての画期的なチャットボット、画像生成ツール、リサーチアシスタント、そして自律エージェントは、人間が作り出した情報の山の上に構築されている。写真、記事、レビュー、研究論文、フォーラムのディスカッション、カスタマーサポートのトランスクリプト。何百万もの人々が残したデジタルの足跡が絶え間なく続いている。
それでも、お金が流れ始めると、大半は結局同じ場所にたどり着きます。インフラを支配している企業のところです。
それが、OpenLedgerが打ち砕こうとしている“偏り”です。
そして、それは小さな野望ではありません。
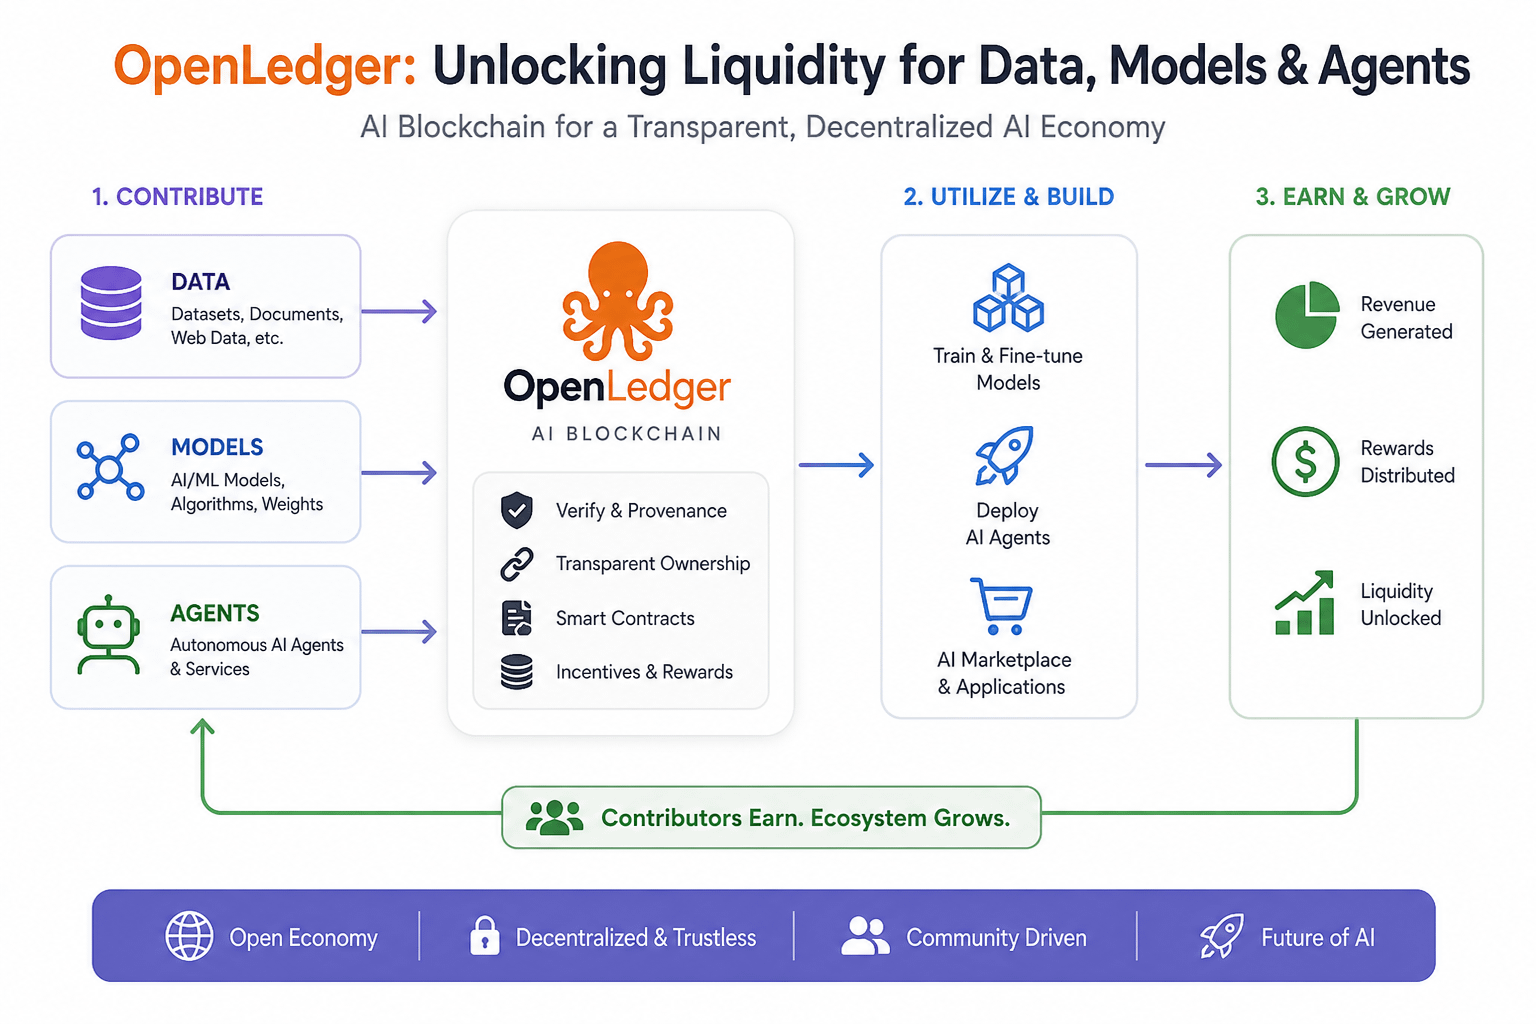
このプロジェクトは、自分たちを“ただの別のブロックチェーン”としてAIの物語に紐づけようとしているわけではありません。そうしたものはすでにたくさん見てきました。多くは、マーケティングのサイクルを数回回した後、ノイズに消えていきます。OpenLedgerは、もっとずっと大きな主張をしています。AIそのもののための経済的なレールを構築し、データ、AIモデル、自律エージェントを、使い捨ての資源ではなく生産的な資産として扱えるマーケットプレイスを作りたいのです。
複雑に聞こえるなら、それは複雑だからです。
しかし、根本の考え方は驚くほどシンプルです。
現在のAI業界は、何百万人もの人々が無自覚に生の材料を供給している巨大な工場のようです。そして完成品を所有しているのは、ごく一部の会社です。データが投入される。AIが出力される。価値は上部に蓄積していく。
OpenLedgerは、その方程式を変えたいのです。
このプロジェクトは、シンプルな信念に基づいています。あなたのデータが価値の創出に役立つのなら、その上昇分(アップサイド)に参加できる仕組みがあるべきです。人々が使うモデルをつくるなら、所有は透明であるべきです。AIエージェントが収益を生むなら、中央集権的な門番(ゲートキーパー)に頼らずに、経済的に運用できる“ネイティブな”仕組みが必要です。
言うのは簡単。
ずっと難しい。
そこでブロックチェーンが物語に入ってきます。
長年にわたり、ブロックチェーン支持者は、分散型ネットワークなら従来のプラットフォームが抱える所有の問題を解決できると主張してきました。理論上、ブロックチェーンは、貢献の記録、取引の追跡、報酬の分配、透明な説明責任(アカウンタビリティ)の仕組みづくりに非常に長けています。
一方、AIには逆の問題があります。
技術は毎年ますます強力になっていますが、それにまつわる経済性は驚くほど不透明なままです。多くのユーザーに、モデルの学習データがどこから来たのか、誰がそれに貢献したのか、誰が対価を受け取ったのかを聞いてみてください。答えはたいてい、肩をすくめるだけです。
OpenLedgerは、知性そのもののための台帳を作ろうとしています。
データは資産になる。
モデルは収益化できるプロダクトになります。
エージェントは経済的な参加者になる。
構想は注目を集めるほど大胆で、懐疑を呼び込むほど物議を醸す。
どちらの反応も正当です。
公開されたAIの経済圏を作ることは、紙の上では実に優雅に聞こえます。現実はたいていもっとごちゃごちゃしています。
データの品質は、その完璧な例です。
機械学習の周りで時間を過ごしたことがある人なら誰でも知っていますが、悪いデータは、ほぼ何よりも速くシステムを汚染し得ます。オープンな貢献は素晴らしく聞こえますが、スパム、操作、重複、低品質の提出がネットワークに流れ込み始めると話は別です。すると、あなたは知性を作っているのではなく、がらくた処理装置を作っていることになります。
OpenLedgerの長期的な成功は、何よりもこの問題を解決できるかに大きく左右されます。
帰属(アトリビューション)についても同じことです。
たとえば、あるモデルが価値を何百万ドルも生み出したとしましょう。では、その成功にどのデータセットがそれぞれ何パーセント貢献したのかを、どうやって正確に突き止められるのでしょう?何千人、あるいは何百万人もの貢献者に対して、公正にどう報酬を与えるのでしょう?
魔法の答えはありません。
非常に困難な会計問題を解こうとする、ますます洗練された試みがあるだけです。
ここから面白くなります。
AIエージェントの台頭は、従来のチャットボットが生み出した以上に、OpenLedgerのようなネットワークの強い根拠を作るかもしれません。
私たちは、ソフトウェアが質問に答えるだけではない世界へ向かっています。タスクを実行する。移動する。取引を執行する。契約を交渉する。調査を行う。ワークフローを管理する。
これらの仕組みは、単に情報を消費するだけではありません。経済活動を生み出します。
それがすべてを変えます。
たとえば、24時間365日稼働するカスタマーサポート業務を行うAIエージェントを想像してみてください。クライアントにサービスを提供し、手数料を回収し、計算資源を購入し、そして時間とともにパフォーマンスを改善していきます。すると、あなたはもはや“ツールとしてのソフトウェア”の話をしているのではありません。
あなたが言っているのは、参加者としてのソフトウェアということですね。
従来のインフラは、その未来のために設計されていませんでした。
OpenLedgerは、自律的な何百万ものエージェントが互いに相互作用し始めると、ブロックチェーンに基づく調整(コーディネーション)がますます価値を持つようになると賭けています。
たぶん彼らの言う通りです。
たぶん彼らは早すぎるだけです。
歴史は、しばらくの間その2つを同一に見せる癖があります。
テクノロジーのサイクルを十分に見てきたからわかる。タイミングは、実行とほぼ同じくらい重要だ。非常に素晴らしいアイデアでも5年早すぎて出れば、ダメなアイデアと見分けがつかないことがある。
AI業界は現在、誇大広告(ハイプ)で溺れています。毎週のように、分散型インテリジェンス、自律的な経済、革命的なインフラを約束する別のプロトコルが登場します。ほとんどは生き残れません。中には、そもそも誰も持っていない問題を解いているものもあります。
本当の問いは、OpenLedgerが取り組んでいる問題が、無視できなくなる種類の問題なのかどうかです。
そう考える理由があります。
AI業界は、クリエイター、規制当局、研究者、そして政府から、学習データや所有権に関するより多くの透明性を求められて、ますます強い圧力に直面しています。法廷闘争はすでに始まっています。規制対応の面倒が増え続けています。企業のエゴは、エコシステムを共有したいというより支配したい組織同士の協業を、相変わらず複雑にしています。
そのような圧力は、なくなるわけではありません。
むしろ、彼らはそれを強めています。
貢献を追跡し、価値を分配できるインフラ層は、業界が成熟するにつれてますます役に立つようになるかもしれません。
OpenLedgerは、その“層”になれるでしょうか?
誰にもわかりません。
そして、確実だと言い切る人はたぶん何かを売っているのでしょう。
私たちが言えるのはこれです。このプロジェクトは、2つの巨大な技術的転換点の交差点に位置しています。1つは人工知能。もう1つは、プログラマブルなデジタル所有です。
それは魅力的な場所です。
それに、危険でもあります。
なぜなら、成功するインフラを築くことは、ビジョンだけで決まることはめったにないからです。実行にかかっています。バグが重要です。インセンティブが重要です。統治(ガバナンス)が重要です。ユーザー体験が重要です。コミュニティが重要です。
そして何より重要なのは、信頼です。
インターネットには、誰も来なかったために失敗した技術的に見事なプロジェクトがあふれています。
OpenLedgerの課題は、単にテクノロジーを作ることではありません。
開発者、研究者、企業、そしてデータ提供者に対して、AIのための別の経済モデルに参加する価値があると納得させることです。
それはずっと難しい作業です。
しかし、それはチャンスでもあります。
結論は?
OpenLedgerは、本当に別のブロックチェーンを作ろうとしているわけではありません。
人工知能における最大級の未解決の問いの1つに答えようとしているのです。機械の知能によって生み出された価値を、誰が所有すべきなのか?
答えは、次の10年のテクノロジーを形作りうる。
そして、それは注目に値する物語です。