

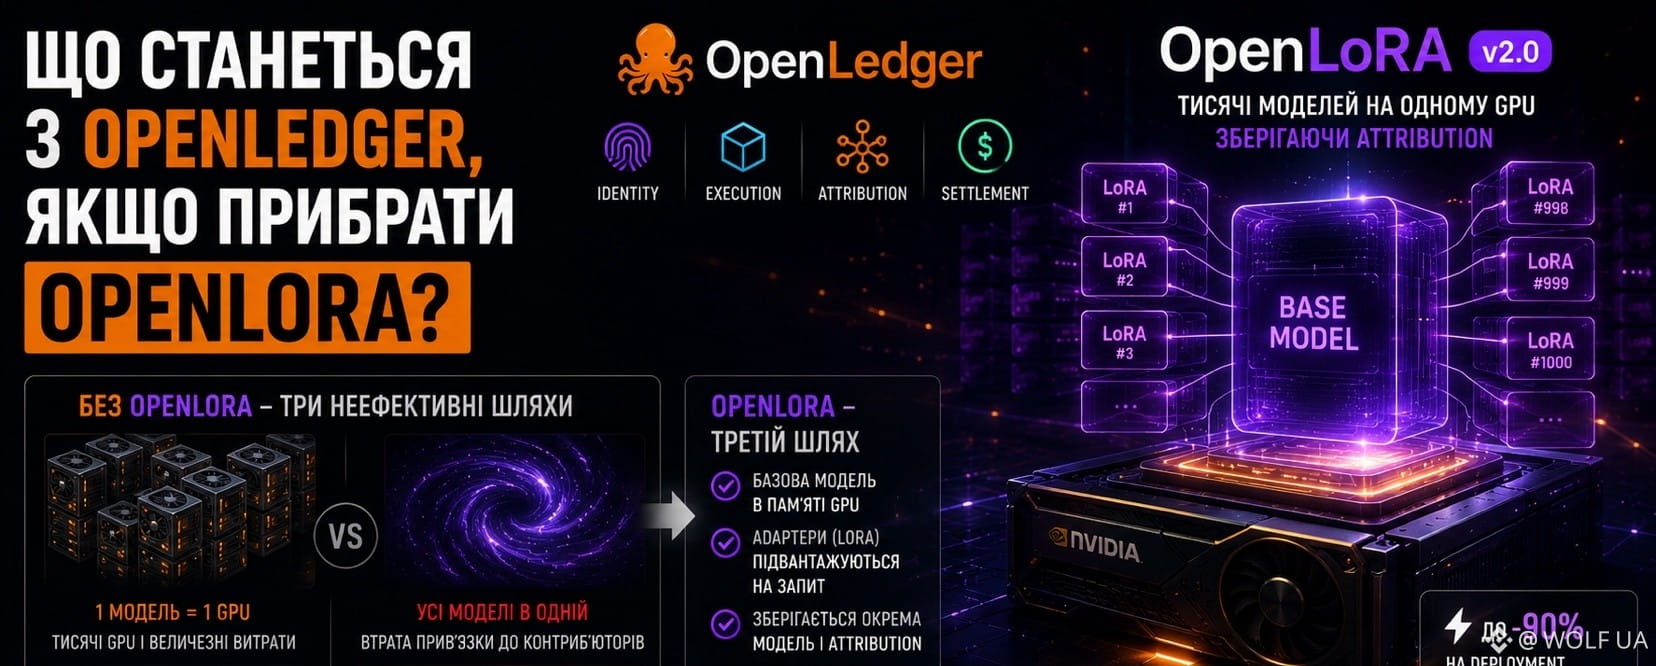

OpenLoRAを眺めれば眺めるほど、それをAI向けの単なる最適化として捉えにくくなります。私にとってはむしろ、OpenLedger全体の経済がそもそもスケールして機能し得るのかを確かめるためのもののように見えます。
面白いことに、私がこの結論に至ったのは製品の技術的説明を読んだからではなく、単純な疑問——もしOpenLoRAをアーキテクチャから取り除いたらどうなるのか——によるものです。
まずは技術そのものについて短く。OpenLoRA は、各ファインチューニング済みモデルに対して個別の GPU を確保する必要なく、大量の fine-tuned モデルを効率的に起動するという発想を軸に構築されています。ベースモデルは常にロードされたままで、LoRA アダプターはリクエストが来たときだけ接続されます。チームは、1 つの GPU で数千のアダプターを提供でき、推論コストを大幅に下げられると主張しています。4-bit quantization、dynamic loading、flash attention といった仕組みはオープンに説明されています。ただし、数千モデルという数字や、90% までの節約といったものは内部テストの結果にとどまっており、独立した計測による裏取りは見つけられていません。
そして次に、OpenLoRA の不在という問いに戻りましょう。
@Openledger の上に Proof of Attribution があるのがポイントです。アイデアはシンプルで、システムはどのデータが特定のモデルとその結果に影響したのかを理解している必要があります。ですが、ネットワークが十数ではなく数千の専門特化モデル――法律、金融、医療、研究――をサポートしようとすると、配置の問題が出てきます。
第一の案は明らかです。別 GPU に別モデルを置く。しかしそうすると、経済性はあっという間に Web3 ではなく、莫大な計算コストの請求がつく従来型のクラウド事業みたいな様相を帯びてきます。
次の選択肢は、すべてを 1 つの巨大なモデルに統合し、プロンプトで振る舞いを制御することです。こちらのほうが安いですが、その場合アトリビューションの精度が失われます。誰が結果に貢献したのか、そして誰に報酬が帰属するのかを理解しにくくなります。
実際のところ OpenLoRA は第三の道を探そうとしています。GPU を増やす必要なく、モデルを分離したままにすること。もしこの仕組みが、 заявлено(主張どおり)のとおりに動くなら、OpenLedger はモデル・データ・コントリビューターの結びつきを失うことなく、自社の経済圏をスケールするチャンスを得られます。
だからこそ私は OpenLoRA を、推論を高速化するためのツールとして見ているわけではありません。そうした解決策は市場に十分あります。@Openledger でそれが担っているのは別の役割――モデルの実行とアトリビューションの仕組みとのつながりを維持することです。
とはいえ、ここで残るのは本質的な問いです。そもそも市場に、この特性はどれほど必要なのか。
もし企業や開発者が、データの出所の透明性と収益の公正な分配を求め始めるなら、OpenLoRA は将来の AI インフラの重要な要素になるかもしれません。逆に、市場が速度と安さだけを選び続けるなら、どれほど洗練されたアーキテクチャでもニッチな解決策のままにとどまるリスクがあります。
だから私にとって OpenLoRA は GPU の話ではありません。数年後には、アトリビューションの価値が、モデルそのものの品質と同じくらい重要になるという賭けなのです。
あなたはこうした技術をどう評価していますか? 独立したベンチマークと証拠を待つのか、それとも、意思決定のロジック自体が説得力に見えるなら、プロジェクトに信用を与える用意があるのか。
