AIと暗号資産の両方を追いかける中で、最も大切なインフラは、市場がその目的を完全に理解する何年も前に構築されることが多い、という点を改めて実感するようになりました。
今のところ議論の中心は、どのAIモデルが最も賢いか、速いか、あるいは最も高機能かといったことに寄りがちです。しかし、より深い課題は知能そのものではないかもしれません。真の問いは、その知能がどこから知識を得るのか、ということです。
AIが進化し続けるにつれて、データはますます重要な制約になってきています。単にデータが足りないからではなく、信頼できる高品質なデータを特定することが難しくなっているからです。AI生成コンテンツがインターネットにあふれる中、本物の情報と合成ノイズを切り分けるのは、日を追うごとに難しくなっています。
それが、OpenLedgerに注目した理由のひとつです。
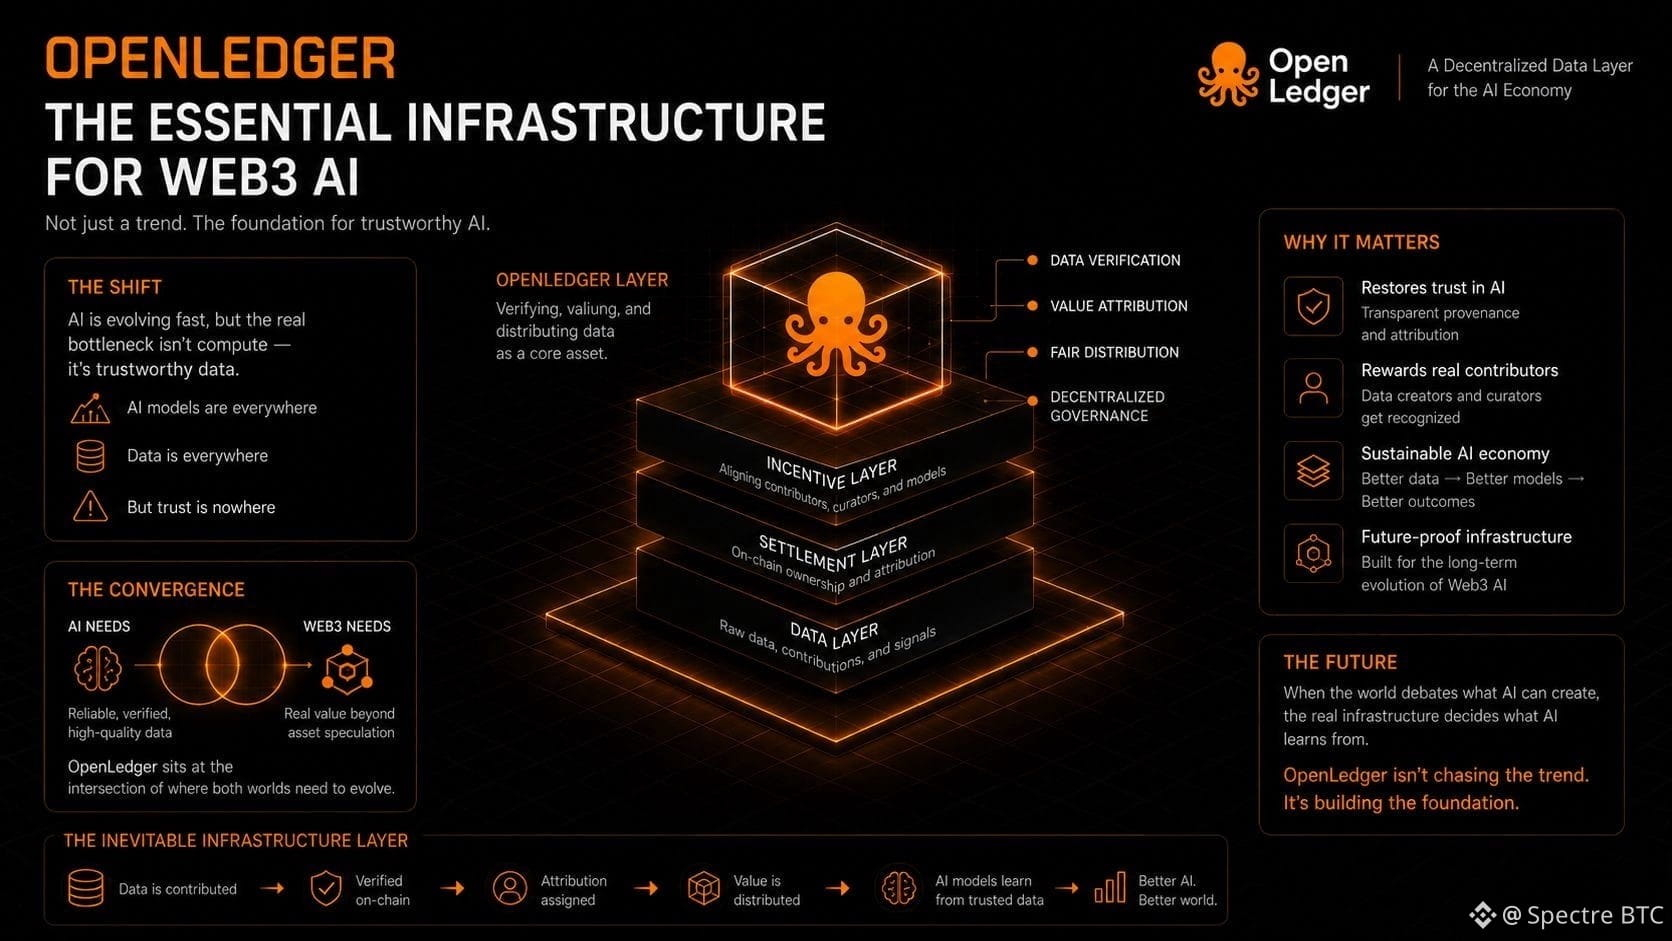
別のAIモデルを立ち上げて競うのではなく、OpenLedgerは、価値のあるデータを検証し、インセンティブを与え、配布するためのインフラを構築することに注力しているように見えます。データが最も重要なデジタル資産の一つになる未来において、このレイヤーの重要性は、より増していく可能性があります。
特に興味深いのは、AIとWeb3の交点に位置している点です。AIは改善のために信頼できるデータに依存しています。一方Web3は、単純な資産の移転を超えて価値を生み出す仕組みを探し続けています。OpenLedgerは、これら2つのニーズがぶつかる場所に備わっているように見えます。
それが将来のAIインフラの土台になるのかどうかは不確かです。しかし、多くの市場参加者が「AIが何を生み出せるか」に注目している一方で、より重要な問いは、AIが何を学んでいるのか、そしてその知識に貢献することで誰が利益を得るのか、かもしれません。
#OpenLedger $OPEN @OpenLedger
今のところ議論の中心は、どのAIモデルが最も賢いか、速いか、あるいは最も高機能かといったことに寄りがちです。しかし、より深い課題は知能そのものではないかもしれません。真の問いは、その知能がどこから知識を得るのか、ということです。
AIが進化し続けるにつれて、データはますます重要な制約になってきています。単にデータが足りないからではなく、信頼できる高品質なデータを特定することが難しくなっているからです。AI生成コンテンツがインターネットにあふれる中、本物の情報と合成ノイズを切り分けるのは、日を追うごとに難しくなっています。
それが、OpenLedgerに注目した理由のひとつです。
別のAIモデルを立ち上げて競うのではなく、OpenLedgerは、価値のあるデータを検証し、インセンティブを与え、配布するためのインフラを構築することに注力しているように見えます。データが最も重要なデジタル資産の一つになる未来において、このレイヤーの重要性は、より増していく可能性があります。
特に興味深いのは、AIとWeb3の交点に位置している点です。AIは改善のために信頼できるデータに依存しています。一方Web3は、単純な資産の移転を超えて価値を生み出す仕組みを探し続けています。OpenLedgerは、これら2つのニーズがぶつかる場所に備わっているように見えます。
それが将来のAIインフラの土台になるのかどうかは不確かです。しかし、多くの市場参加者が「AIが何を生み出せるか」に注目している一方で、より重要な問いは、AIが何を学んでいるのか、そしてその知識に貢献することで誰が利益を得るのか、かもしれません。
#OpenLedger $OPEN @OpenLedger